Innhold Vis
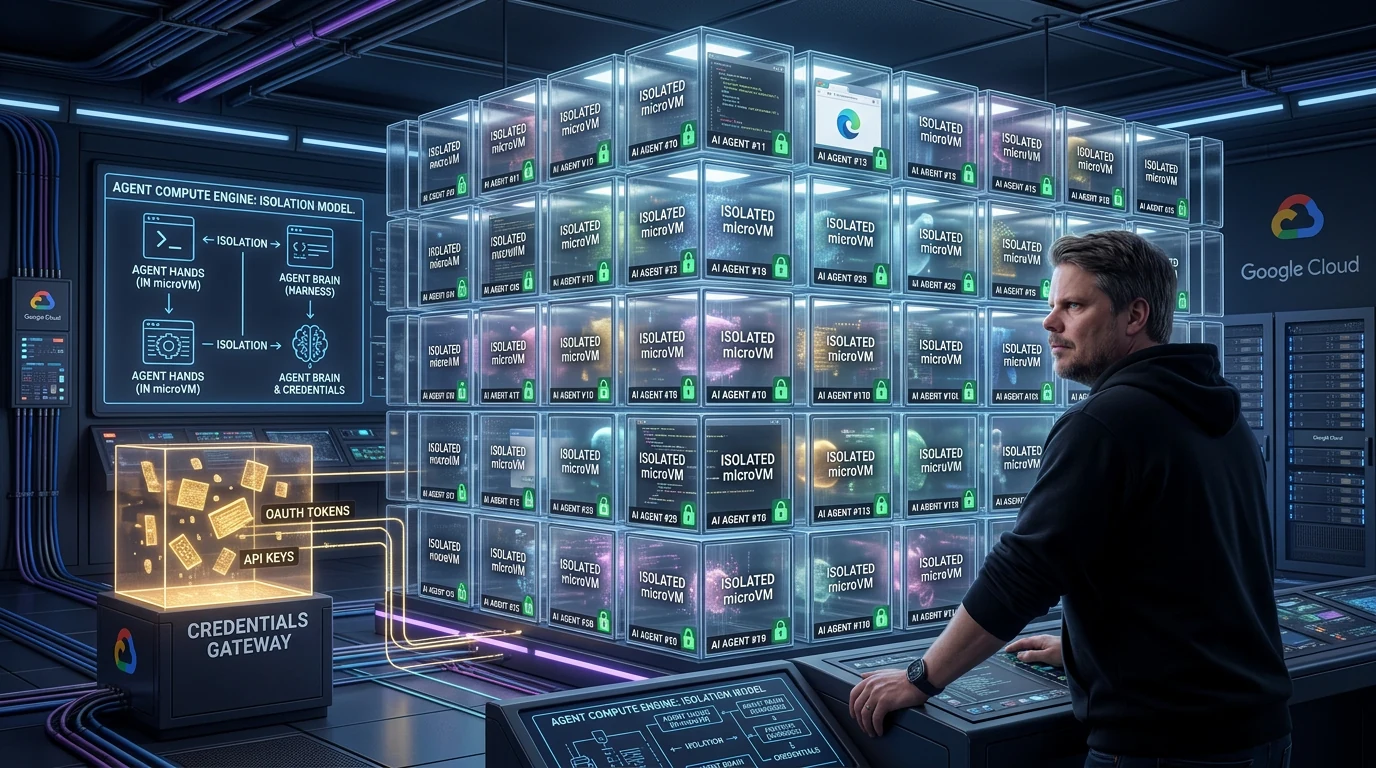
Hvis en AI-agent skal få kjøre kode, åpne nettleseren og arbeide i bedriftens systemer, holder det ikke å be modellen pent om å oppføre seg. Google Agent Compute Engine angriper problemet på infrastrukturnivå: Hver agent får sin egen maskinvareisolerte microVM, mens de verdifulle legitimasjonene holdes utenfor miljøet agenten kontrollerer.
Det er en langt mer interessant sikkerhetsmodell enn enda et lag med systeminstrukser. En agent kan lese en ondsinnet e-post, tolke en nettside feil eller kjøre kode ingen burde stole på. Googles utgangspunkt er derfor at alt inne i sandkassen kan bli kompromittert. Da bør angriperen heller ikke finne API-nøkler, OAuth-tokens eller direkte nettverkstilgang der inne.
Agent Compute Engine driver allerede Gemini-agenter internt hos Google, men tjenesten er ikke generelt tilgjengelig. Google annonserte 22. oktober 2026 at en preview kommer «i løpet av de kommende månedene». Det finnes foreløpig ingen offentlig pris, og jeg har ikke testet tjenesten. Likevel peker arkitekturen på noe viktig: AI-agenter trenger etter hvert et eget lag med datakraft, identitet og sikkerhet – ikke bare en modell koblet til noen verktøy.
Hva er Google Agent Compute Engine?
Google Agent Compute Engine er en ny skytjeneste som gir hver agentsesjon en vedvarende, maskinvareisolert microVM. Ifølge Googles lansering 22. oktober 2026 er tjenesten laget for agenter som skriver og kjører kode, bruker verktøy, styrer nettlesere og utfører arbeidsflyter over tid.
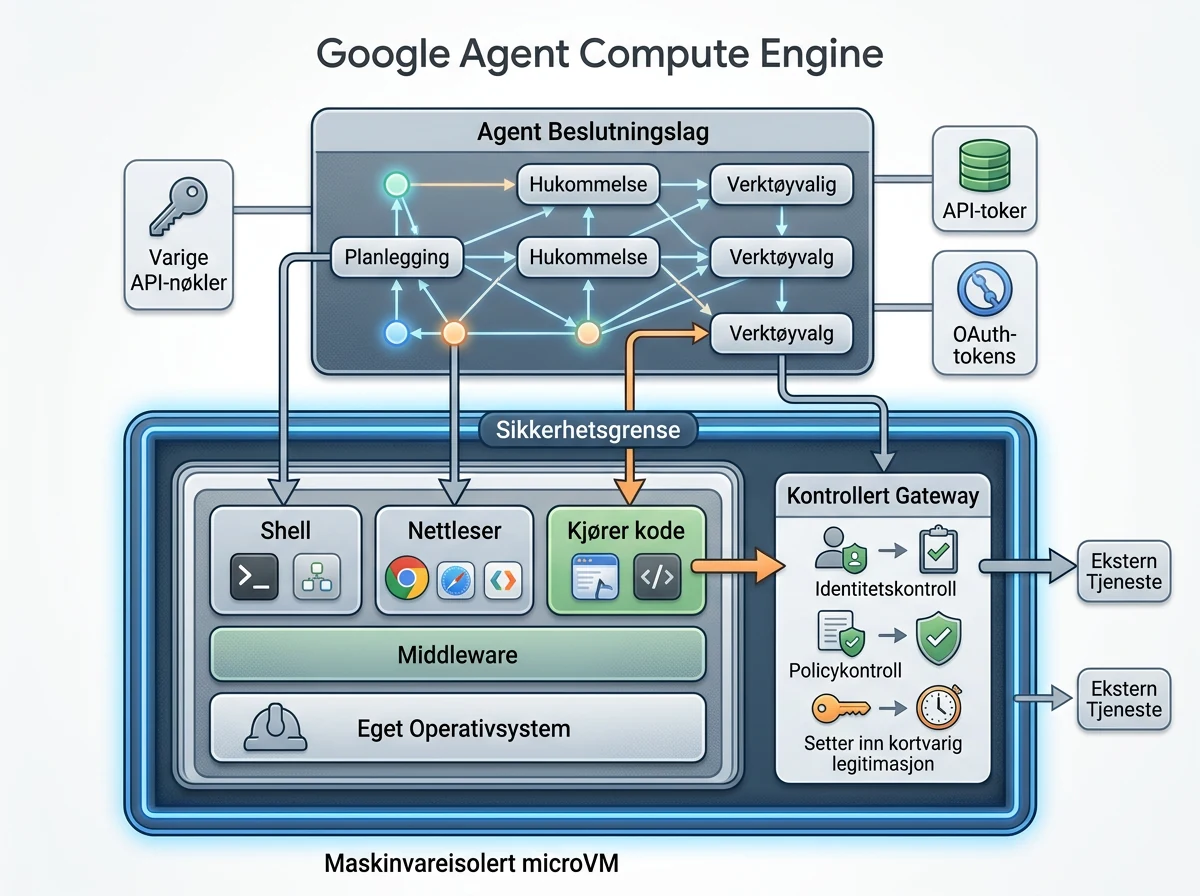
Google deler agenten i to. «Hjernen» er agentens harness, altså laget som snakker med modellen og bestemmer neste handling. «Hendene» er sandkassen som faktisk kjører shell-kommandoer, nettleseren og koden. Hjernen ligger utenfor microVM-en, mens den potensielt upålitelige kjøringen skjer på innsiden.
Det gir agenten mer frihet enn et låst container-miljø, blant annet eget operativsystem, egen kernel og root-tilgang. Samtidig får hver sesjon en sterkere grense mot naboene enn vanlige containere, som deler vertens kernel. Målet er i praksis å kombinere VM-isolasjon med oppstart og tetthet som passer raske, hakkete agentøkter.
Hvorfor er microVM-en viktig for sikkerheten?
MicroVM-en er viktig fordi en AI-agent ikke bare behandler tekst. Den kan få et filsystem, installere pakker, åpne nettsider og utføre kommandoer på vegne av en bruker. I Googles tekniske gjennomgang er grunnregelen nådeløst fornuftig: Anta at en angriper kontrollerer alt inne i sandkassen, og sørg for at det ikke finnes noe nyttig å stjele der.
Derfor skal microVM-en ikke lagre API-nøkler, OAuth refresh tokens eller service account-nøkler, verken i minnet eller på disken. Den får heller ikke tilgang til metadata-tjenesten i skyen. I stedet får hver sesjon en kortlivet identitet basert på SPIFFE og en egen kryptografisk attestasjon.
Når agenten ber om tilgang til en ekstern tjeneste, går trafikken gjennom en kontrollert gateway utenfor microVM-en. Gatewayen sjekker brukerdelegering, agentidentitet, verten og gjeldende policy før den setter inn riktig legitimasjon på vei ut. Sandkassen får med andre ord bruke en godkjent tjeneste uten å få holde nøkkelen som åpner døren.
Det er akkurat denne typen skille produksjonsagenter trenger. Prompt injection forsvinner ikke fordi agenten får en microVM. Modellen kan fortsatt gjøre noe dumt. Forskjellen er at et dumt eller ondsinnet steg møter en teknisk grense rundt identitet, nettverk og hemmeligheter. Sikkerheten avhenger dermed mindre av at modellen alltid tolker tekst riktig – en forventning historien allerede har gjort grundig narr av.
Hvordan kan en egen microVM være billig nok?
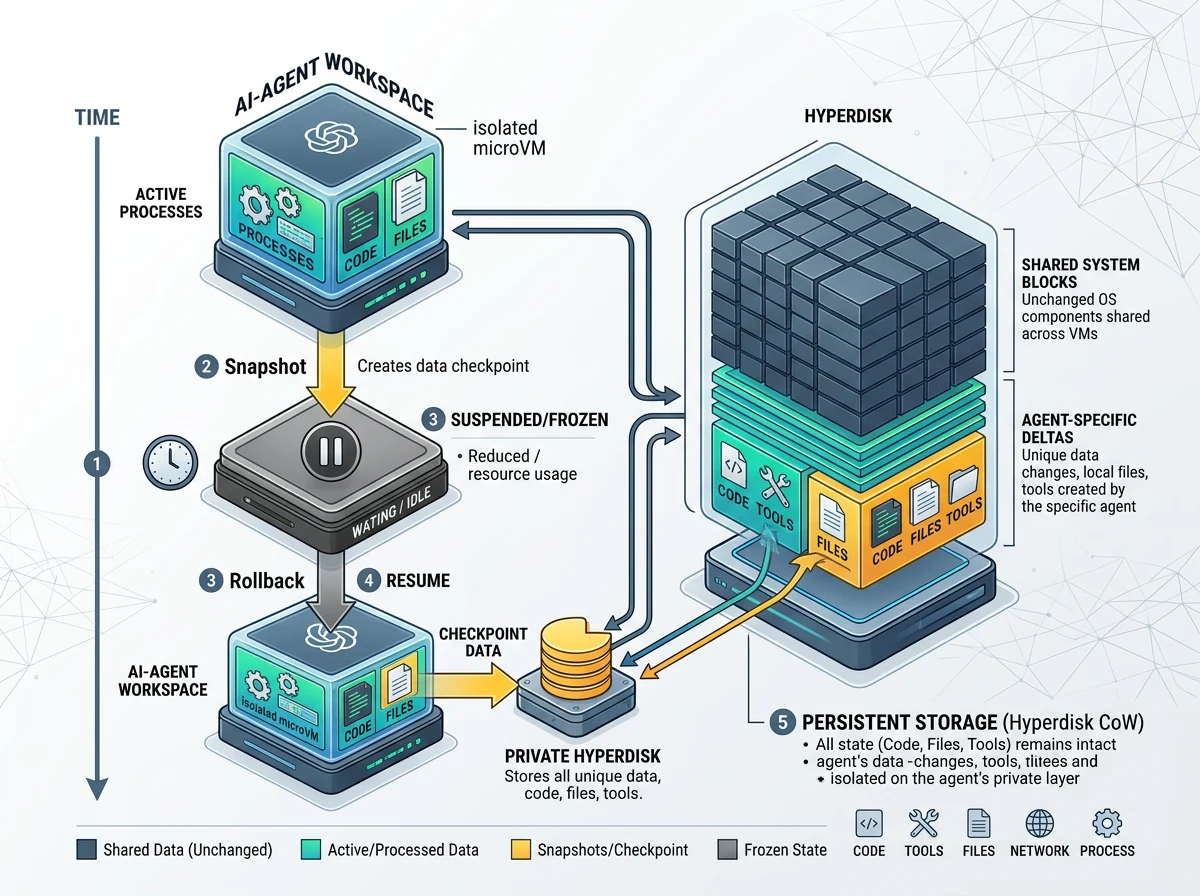
Google prøver å gjøre modellen økonomisk ved å utnytte at agenter venter mesteparten av tiden. De venter på neste modelsvar, et eksternt system eller brukeren. Når kjøremiljøet oppdager at ingen kommandoer eller bakgrunnsjobber er aktive, kan det fryse microVM-en, bevare tilstanden og frigjøre de aktive ressursene.
Når neste verktøykall kommer, gjenopptas miljøet fra et checkpoint. Google sier at en inaktiv agentsesjon dermed kan bruke nær null aktiv datakraft, uten at filene og arbeidstilstanden blir kastet. Det er avgjørende hvis en tjeneste skal ha tusenvis eller millioner av agenter som lever lenge, men bare arbeider i korte rykk.
Aktive microVM-er deler dessuten uendrede deler av operativsystemet, bibliotekene og de forhåndsvarmede programmene gjennom copy-on-write-minne. Bare sidene en bestemt agent endrer, trenger privat fysisk minne. Det er ikke det samme som at agentene deler arbeidsområde eller sikkerhetsgrense. De deler de identiske, statiske byggeklossene under panseret.
Google oppgir ingen pris for Agent Compute Engine ennå. Dermed vet vi heller ikke om de tekniske grepene faktisk gir en attraktiv regning for små utviklere og bedrifter. Arkitekturen forklarer hvordan Google vil få regnestykket til å gå opp, men «effektivt» er fortsatt en leverandørpåstand til previewen kan måles mot alternativer.
Hva skjer med filer og arbeid mellom øktene?
Hver microVM kan få et vedvarende arbeidsområde på Hyperdisk. Det betyr at agenten kan beholde installerte verktøy, kildekode og resultater mellom samtaler og arbeidsøkter, i stedet for å bygge hele miljøet på nytt hver gang. For en kodeagent som arbeider med samme repository over flere dager, er det langt mer nyttig enn en engangssandkasse.
Google beskriver tre typer lagring. Midlertidige logger og byggeartefakter kan ligge i raske lag som kan kastes. Felles basebilder, verktøykjeder og pakkecacher kan monteres skrivebeskyttet. Bare brukerens faktiske arbeidsstatus og lagrede resultater trenger varig, privat lagring.
Dette passer godt med retningen AI-agenter allerede beveger seg i. Jeg har tidligere skrevet om hvordan Google Home åpner for eksterne AI-agenter som kan utføre handlinger. Når agenter får mer enn et chatvindu og faktisk skal gjøre arbeid, blir det raskt nødvendig å vite hvilke filer, verktøy og tilganger som tilhører hvilken agent.
Vedvarende arbeidsområder gir samtidig et nytt ansvar. En disk som husker nyttige filer, kan også huske farlige filer og dårlige endringer. Googles snapshot-, forking-, rewind- og rollback-funksjoner kan derfor bli minst like viktige som selve lagringen. Det må være mulig å spore hva agenten gjorde og gå tilbake til en kjent tilstand.
Er dette bare for Gemini?
Nei, planen er at utviklere skal kunne bruke Agent Compute Engine til egne agenter. Google sier at kundene skal kontrollere miljøbildet, identiteten, nettverkstilgangen og livssyklusen, mens Google drifter den underliggende maskinparken. Tjenesten brukes allerede til Gemini, Antigravity og interne evaluerings- og treningsjobber, men ekstern tilgang kommer først i preview.
Google presenterte samtidig Agent Substrate for team som vil ha mer kontroll eller kjøre på Kubernetes. Det er en åpen kjøretid for GKE og andre Kubernetes-miljøer, med microVM eller gVisor som isolasjon. Google hevder opptil 10 ganger høyere datatetthet enn tradisjonell compute, og oppgir en validering med 200 000 agenter, 500 aktiveringer i sekundet og under 500 millisekunders pause- og gjenopptakstid.
De tallene gjelder Agent Substrate, ikke en offentlig ytelsestest av Agent Compute Engine. Det skillet er viktig. MarkTechPost løftet fram microVM-en per agent i sin omtale av lanseringen, men Google har foreløpig ikke publisert pris eller kundebenchmark som lar oss sammenligne den kommende skytjenesten rettferdig med Firecracker, gVisor, vanlige VM-er eller andre agentsandkasser.
For utviklere betyr det at arkitekturen er verdt å studere nå, mens en kjøpsbeslutning må vente. Agent Substrate kan være relevant for team som allerede driver Kubernetes og vil eksperimentere med samme grunnidé. Agent Compute Engine er den administrerte varianten for dem som heller vil kjøpe kjøremiljøet som en tjeneste.
Hva bør bedrifter se etter før previewen?
Bedrifter bør først se på grensen mellom agentens beslutningslag og kjøremiljøet. Kan kode som agenten starter, nå modellens systeminstruks, brukerens varige legitimasjon eller andre agentsesjoner? Hvis svaret er ja, hjelper det lite at leverandøren kaller miljøet en sandkasse.
Deretter kommer identitet og nettverk. Agenten bør få kortvarig, avgrenset tilgang til akkurat det oppgaven krever. Utgående trafikk bør gå gjennom policyer og logging, ikke en vanlig nettverksport med en API-nøkkel liggende i en miljøvariabel. Google beskriver fire identitetsnivåer for bruker, delegasjon, arbeidslast og en eventuell egen agentkonto. Det kan virke omstendelig, men det er bedre enn å late som alle handlinger fortsatt utføres av mennesket som startet økten.
Til slutt må økonomien måles med ekte arbeidsflyter. Hvor raskt våkner en frosset agent? Hva koster lagringen når arbeidsområdet lever i måneder? Hvor lett kan et team eksportere data, bilder og policyer hvis det vil bytte leverandør? Og hvor tydelig skiller regningen mellom aktiv kjøring, ventetid, disk og nettverk?
Agent Compute Engine løser ikke agentpålitelighet. Den gjør ikke modellen klokere, og den hindrer ikke alle feilhandlinger. Det Google bygger, er et bedre sted å la en upålitelig agent arbeide. Det er en viktig forskjell – og etter min mening en mer moden retning enn å gi stadig kraftigere agenter stadig flere nøkler og håpe at prompten holder.
Ofte stilte spørsmål
Når blir Google Agent Compute Engine tilgjengelig?
Google sier at Agent Compute Engine skal komme i preview i løpet av de kommende månedene etter kunngjøringen 22. oktober 2026. Selskapet har ikke oppgitt en eksakt dato, regionliste eller tidspunkt for generell tilgjengelighet.
Har Agent Compute Engine en offentlig pris?
Nei. Google har foreløpig ikke publisert pris for microVM-kjøring, vedvarende lagring, pausemodus eller nettverkstrafikk. Det er derfor for tidlig å si om tjenesten blir rimeligere enn andre sandkasser og VM-baserte løsninger.
Kan en agent hente API-nøklene fra sin egen microVM?
Arkitekturen er laget for å hindre nettopp det. Varige API-nøkler, OAuth refresh tokens og service account-nøkler skal holdes utenfor sandkassen. En ekstern gateway kontrollerer forespørselen og setter inn nødvendig legitimasjon etter at identitet og policy er godkjent.
Hva er forskjellen på Agent Compute Engine og Agent Substrate?
Agent Compute Engine er Googles kommende administrerte skytjeneste for isolerte agentmiljøer. Agent Substrate er en åpen, Kubernetes-basert kjøretid for team som vil ha mer kontroll og portabilitet. De bygger på lignende ideer, men tilgjengelighet, drift og publiserte ytelsestall er forskjellige.