Innhold Vis
Hvis du har ventet på at Meta skulle komme tilbake i toppkampen for AI-modeller, er Muse Wonder modellen du skal følge med på. Dette er selskapets første egentlige frontier-modell, bygget for langvarige AI-agenter, krevende kodearbeid og oppgaver der modellen må huske hva som skjedde for mange samtaler siden.
Meta lanserte Muse Wonder og den mer kapable Muse Wonder Full 12. oktober 2026. Begge har én million tokens kontekst og kan ta imot tekst, bilder, video og lyd, men leverer tekst som utdata. Vanlige Muse Wonder er tilgjengelig gjennom Meta Model API og Muse Code. Full-utgaven er forbeholdt Muse Code-abonnenter og blir ikke tilbudt gjennom API-et.
Det viktigste er likevel retningen. Muse Spark var laget for lav ventetid og rimeligere oppgaver. Wonder flytter Meta opp i den tyngste modellklassen, der agenten skal holde tråden over tid, bruke verktøy, komme seg rundt hindringer og faktisk fullføre jobben. Det er en stor milepæl for Meta – og potensielt en skikkelig utfordring for selskapene som har fått dominere agentmarkedet.
Hva er Muse Wonder?
Muse Wonder er en multimodal frontier-modell for personlige og profesjonelle AI-agenter. Ifølge Metas modellkort har modellen én million tokens kontekst og er laget for blant annet koding, research, dokumentanalyse, planlegging, verktøybruk og flertrinnsoppgaver.
Familien består av Muse Wonder og Muse Wonder Full. Meta beskriver Full som den mest kapable utgaven, mens den vanlige Wonder-modellen er den utviklere faktisk kan bygge inn i egne tjenester gjennom API. Metas utviklerside peker også til OpenRouter og viser at eksisterende OpenAI-kompatible klienter kan kobles til Meta Model API. Det skillet er viktig. En imponerende modell hjelper lite i en produksjonsflyt hvis den bare finnes inne i leverandørens eget kodeverktøy.
Dette er også et klart brudd med fortellingen om at Meta har blitt stående igjen med lette modeller mens OpenAI, Anthropic og Google drar fra. Muse Spark viste den nye retningen, og Muse Spark 1.3 gjorde Meta til en reell utfordrer i den lettere klassen. Wonder er forsøket på å ta steget helt opp.
Hvorfor er aktivt minne så viktig?
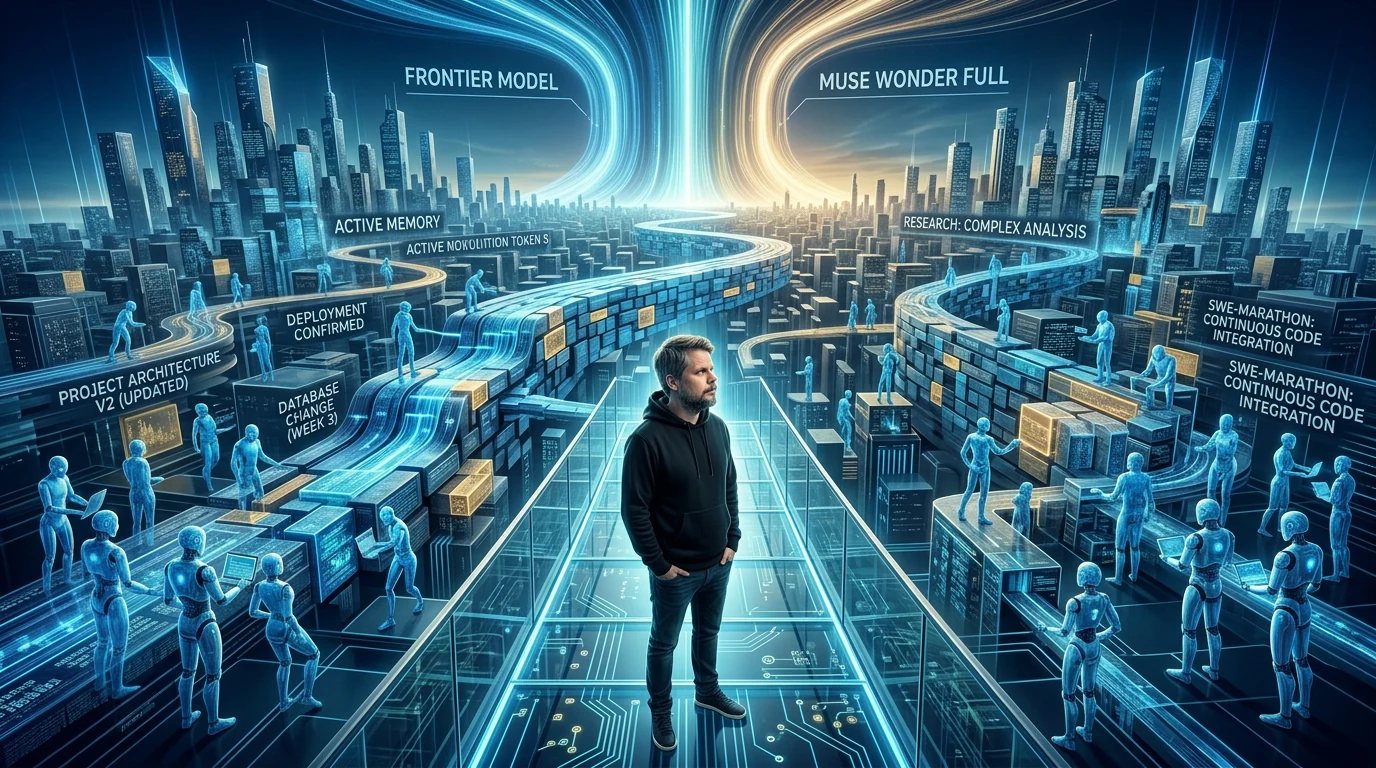
Aktivt minne betyr at agenten skal kunne hente fram relevant informasjon fra tidligere samtaler når den trenger den, ikke bare ha en enorm tekstblokk liggende i kontekstvinduet. Meta tester dette med samtaler på mellom 64 000 og 100 000 tokens, der detaljer kan bli motsagt eller oppdatert underveis.
Det er akkurat denne typen rot en nyttig agent må håndtere. Du kan først fortelle den at et prosjekt bruker én database, senere forklare at arkitekturen er endret, og deretter komme tilbake uker etterpå med en ny oppgave. En god agent må forstå at den nyeste beslutningen gjelder. En dårlig agent finner den gamle opplysningen og bygger videre på feil grunnlag med stor selvtillit. Det siste har vi nok av allerede.
Meta kaller den andre delen «Active Focus». Her skal modellen holde fast ved målet, prøve andre veier når noe stopper opp, be om avklaring når det trengs og kontrollere viktige handlinger før de utføres. På Metas presentasjon av Muse Wonder beskrives oppgaver som programvareutvikling, planlegging på tvers av apper og arbeid som varer lenge nok til at en vanlig chatmodell fort mister både planen og poenget.
Hva betyr modellen for AI-koding?
Muse Wonder er laget for kodearbeid som går langt utover å fylle ut neste funksjon. Meta sier at modellen kan planlegge lange oppgaver, delegere deler av arbeidet til underagenter, gjøre endringer i flere filer parallelt og kjøre gjentatte runder med testing og retting. Det bygger direkte videre på Muse Code og satsingen på store kodebaser.
Modellkortet beskriver DeepSWE v1.1 med 113 oppgaver fra 91 kodebaser og fem programmeringsspråk. Det er mer relevant enn små kodegåter fordi oppgavene blir kontrollert med funksjons- og regresjonstester. SWE-Marathon går enda lenger og prøver å måle om en agent kan holde framdrift i større programvareprosjekter over tid.
Meta hevder at Wonder Full ligger helt i toppen på flere kode- og agentmålinger. Det er lovende, men tallene kommer ikke alle fra én helt kontrollert sammenligning. Meta opplyser selv at noen resultater bruker ulike agentprodukter og testoppsett, mens konkurrentkjøringer gjort internt er «best effort» og ikke nødvendigvis optimalt tilpasset hver modell. Derfor er dette et sterkt signal, ikke en ferdig dom.
For utviklere er den virkelige prøven enklere: Gi Wonder en ekte oppgave i din egen kodebase. Se om den forstår kravene, gjør målrettede endringer, kjører de riktige testene og rydder opp etter seg uten at du må dra den tilbake til planen hvert tiende minutt. Det forteller mer enn en medaljetabell.
Hva koster Muse Wonder?
Muse Wonder koster 4 dollar per million input-token og 20 dollar per million output-token gjennom Meta Model API. Med Norges Banks dollarkurs på 9,5658 kroner 12. oktober 2026 er det cirka 38 kroner inn og 191 kroner ut per million tokens. TechCrunch sammenligner prisnivået med andre tunge frontier-modeller.
Det er ikke en lavprisvariant av Muse Spark. Lange agentløp kan produsere mye tekst, gjøre mange modellkall og sende store mengder kontekst fram og tilbake. Prisen per million tokens er derfor bare starten på regnestykket. Hvor effektivt agentoppsettet gjenbruker kontekst, hvor ofte det kaller modellen og hvor mye den skriver i hver runde, kan bety mer for sluttprisen enn selve listeprisen.
Wonder Full har ingen offentlig API-pris fordi den ikke tilbys gjennom API. Den er knyttet til Muse Code-abonnementet. Hvis du trenger den sterkeste utgaven i en egen tjeneste, er svaret foreløpig nei. Hvis vanlig Wonder holder nivået Meta lover, er det likevel den mest interessante utgaven for utviklere nettopp fordi den kan settes inn i eksisterende systemer.
Er benchmarkene til å stole på?
Benchmarkene er nyttige som dokumentasjon på hva Meta har forsøkt å optimalisere, men de er ikke en uavhengig fasit. Modellkortet sammenligner Muse Wonder med GPT-6 Astra, Claude Fable 5.1 og Claude Opus 5.5 på høyeste reasoning-nivå. Samtidig bruker Meta noen egne tester, noen tredjepartsresultater og noen leverandørrapporterte tall.
MemoryBench er et godt eksempel. Metas variant tester minne i lange samtaler med distraksjoner, motstridende opplysninger og senere oppdateringer. Det treffer et ekte problem. Men når leverandøren både trener modellen, velger oppsettet og presenterer resultatet, bør du lese tallet som en påstand som må bekreftes i praktisk bruk.
Det samme gjelder generalisering. Meta mener større og sterkere grunnmodeller gjør at forbedringer fra ettertreningen overføres bedre til ukjente oppgaver enn de gjorde med Muse Spark 1.3. Det høres rimelig ut, og det er kanskje det mest spennende ved hele lanseringen. Agenten møter tross alt oppgaver utviklerne aldri klarte å skrive inn i treningsplanen. Da er bredde viktigere enn å ha pugget én test.
Hvilke begrensninger har Muse Wonder?
Muse Wonder kan fortsatt gi uriktige, skjeve eller uønskede svar, og Meta advarer spesielt om feil i flertrinnsresonnering på nye oppgaver. Modellkortet peker også på visuell og romlig resonnering – særlig 3D-oppgaver – som en kjent svakhet. Ytelsen kan dessuten endre seg med quantization, serveroppsett, prompt, verktøy og selve agentrammeverket.
Språk er en annen usikkerhet. Modellen er trent på flerspråklige data, men Meta sier at ikke alle språk i treningsgrunnlaget er testet. Norsk ytelse må derfor måles, ikke antas. Én million tokens kontekst betyr heller ikke automatisk at modellen finner riktig detalj i alt du mater inn. Kontekstlengde og pålitelig hukommelse er to forskjellige ting.
Meta anbefaler menneskelig godkjenning før irreversible agenthandlinger. Det er et fornuftig minimum når en modell kan få tilgang til nettleser, dokumenter, meldinger og andre verktøy. Jeg har tidligere skrevet om hvorfor tillit blir selve problemet når Muse får tilgang til e-post og betalinger. Start med avgrensede rettigheter, logg hva agenten gjør og krev bekreftelse før den sender, sletter, kjøper eller endrer noe som ikke lett kan rulles tilbake.
Meta er tilbake i den tyngste modellkampen
Muse Wonder gjør Meta relevant i frontier-klassen igjen. Ikke fordi selskapet har funnet enda et flott navn på en modell, men fordi minne, fokus, verktøybruk og langvarig kodearbeid er akkurat der neste generasjon AI-agenter må bli bedre. Spark handlet mye om fart og pris. Wonder handler om å holde ut og fullføre.
Jeg ville ikke flyttet en kritisk arbeidsflyt til Wonder på grunnlag av Metas egne diagrammer alene. Test den på oppgaver du kjenner, mål kvalitet, tokenbruk og hvor ofte et menneske må gripe inn. Sammenlign særlig den vanlige API-modellen med modellene du allerede bruker, for Wonder Full er foreløpig låst til Muse Code.
Men dette er ingen parentes i Metas AI-satsing. Selskapet har nå en modell som på papiret hører hjemme blant de tyngste konkurrentene, samtidig som den kan brukes gjennom API, OpenRouter og OpenAI-kompatible klienter. Hvis aktivt minne og langvarig fokus fungerer like godt utenfor Metas egne tester, kan Muse Wonder bli modellen som for alvor gjør agentmarkedet trangere. Det er på høy tid.
Ofte stilte spørsmål
Kan jeg bruke Muse Wonder gjennom API?
Ja. Muse Wonder er tilgjengelig gjennom Meta Model API og Muse Code. Muse Wonder Full tilbys derimot bare til Muse Code-abonnenter og har ikke et offentlig API. Utviklere som vil bygge Wonder inn i egne tjenester, må derfor bruke standardutgaven.
Har Muse Wonder åpne vekter?
Nei, ikke per 13. oktober 2026. Meta distribuerer Muse Wonder som en tjeneste gjennom API og Muse Code, ikke som en nedlastbar open-weight-modell. Det skiller Wonder fra Metas tidlige Llama-utgivelser og nyere åpne modeller som Muse Glimmer.
Hvor langt kontekstvindu har Muse Wonder?
Muse Wonder og Muse Wonder Full har et kontekstvindu på én million tokens. Modellen kan ta imot tekst, bilder, video og lyd, men gir tekst som utdata. Lang kontekst er nyttig, men garanterer ikke at modellen husker eller bruker alle detaljer riktig.
Er Muse Wonder bedre enn GPT-6 Astra og Claude?
Metas målinger viser konkurransedyktige resultater mot GPT-6 Astra, Claude Fable 5.1 og Claude Opus 5.5, særlig på agenter, minne og koding. Oppsettene er ikke identiske i alle tester, så praktiske sammenligninger i samme arbeidsflyt er viktigere enn én samlet benchmarktabell.