Innhold Vis
Gemini API Tool Retrieval lar en AI-agent finne og laste verktøyskjemaer først når den trenger dem, i stedet for å sende hele verktøykassa inn i hver forespørsel. For utviklere som kobler agenten til flere titalls funksjoner eller store MCP-servere, kan det bety mindre kontekst, lavere forsinkelse og færre verktøy modellen må velge mellom samtidig.
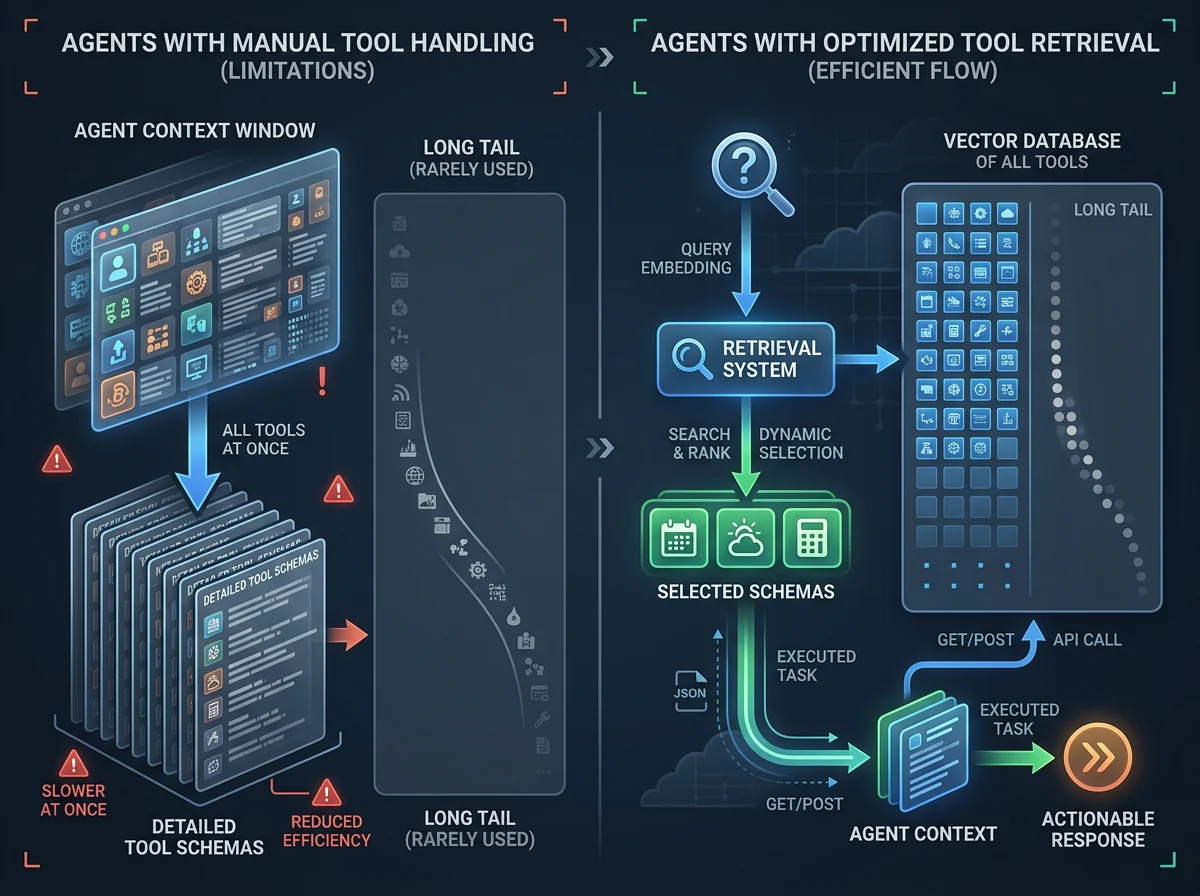
Dette løser et veldig jordnært agentproblem. Hvert verktøy kommer med navn, beskrivelse, parametere og regler som modellen må lese før den gjør noe som helst. Når biblioteket vokser til dusinvis eller hundrevis av verktøy, bruker agenten stadig mer av konteksten på muligheter som ikke har noe med den aktuelle oppgaven å gjøre.
Jeg liker retningen. API-er og verktøykall er det som gjør en modell til noe mer enn en pratsom tekstboks, men et stort verktøysett bør ikke gjøre hver eneste oppgave tyngre. Samtidig er dette en preview-funksjon i en beta-API, ikke dokumentasjon på at alle agenter nå blir raskere eller mer presise. Den gevinsten må måles i den faktiske løsningen.
Hva er Gemini API Tool Retrieval?
Tool Retrieval er en ny funksjon i Gemini Interactions API som lar modellen søke etter et passende verktøy og laste hele parameterskjemaet ved behov. Ifølge Googles kunngjøring 19. november 2026 er funksjonen laget for agenter med dusinvis eller hundrevis av tilgjengelige verktøy.
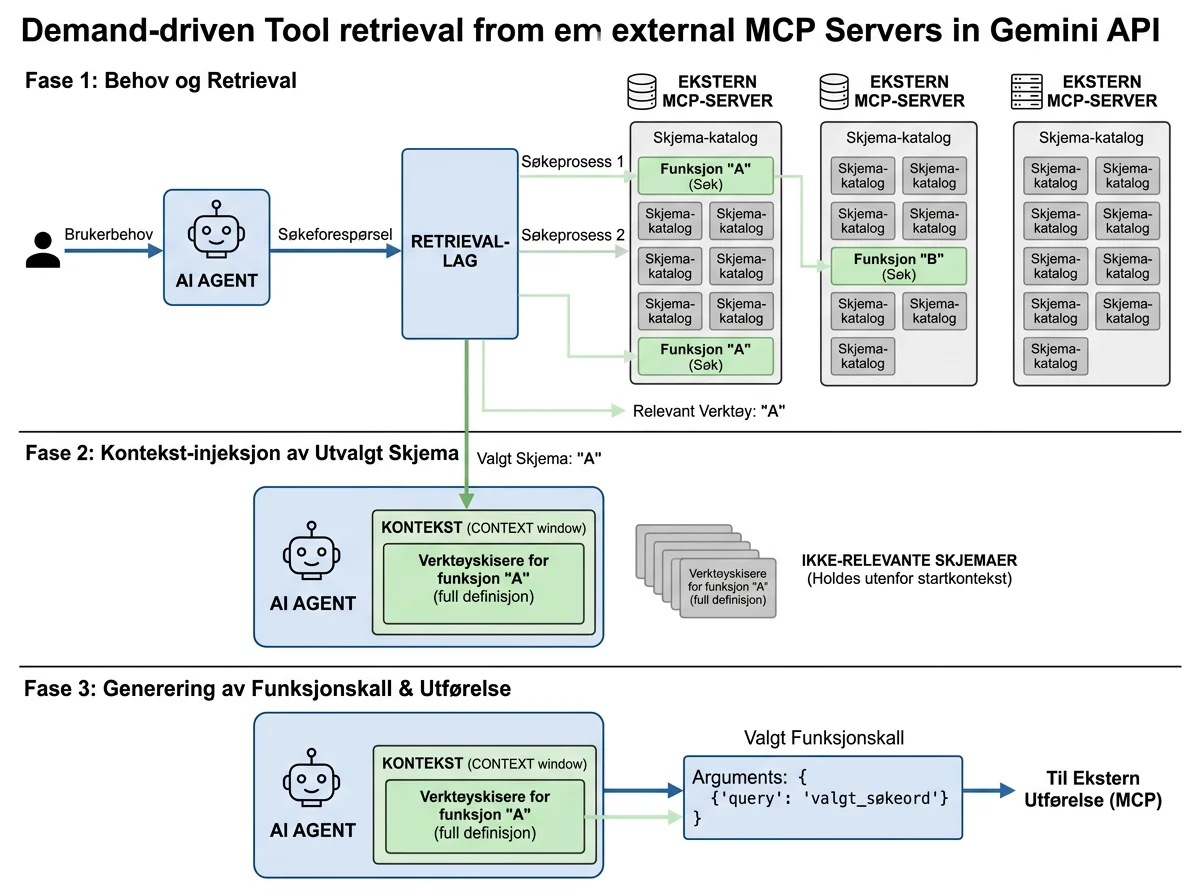
Modellen ser fortsatt navnet og beskrivelsen til utsatte verktøy. Det er nok til at den vet hvilke muligheter som finnes. De større parameterskjemaene holdes derimot utenfor den første konteksten til modellen bestemmer seg for at et bestemt verktøy er relevant.
På serversiden skjer søket, innlastingen av skjemaet og selve funksjonskallet i samme API-forespørsel. Svaret inneholder egne steg for tool_search_call, tool_search_result og function_call. Utvikleren kan dermed se hva modellen søkte etter og hvilket skjema den fikk, før vanlig function calling fortsetter.
Det er en viktig forskjell fra å be modellen velge mellom en lang liste den allerede har fått. Tool Retrieval begrenser mengden detaljert verktøyinformasjon i arbeidskonteksten. Ideen minner om hvordan en agent søker etter dokumenter ved behov, bare at det nå er funksjonsdefinisjonene som hentes fram.
Hvorfor blir store verktøysett et problem?
Et verktøyskjema kan være lite alene, men flere titalls erklæringer kan ifølge Googles tekniske dokumentasjon bruke titusenvis av input-tokens i hver forespørsel. De tokenene må behandles selv om agenten bare trenger én enkel funksjon.
Regningen er ikke bare penger. Et større prompt tar tid å behandle, spiser av kontekstvinduet og gir modellen flere kandidater å skille mellom. Google sier at treffsikkerheten i verktøyvalget faller når kandidatlisten vokser. Det er logisk: En agent med 100 nesten like navn har en vanskeligere sorteringsjobb enn en agent som får se de tre relevante skjemaene.
Dette er også grunnen til at jeg ikke ser Tool Retrieval som en generell bryter alle bør slå på. Google anbefaler vanlig statisk lasting for færre enn omtrent 20 stabile verktøy. Da slipper modellen retrieval-steget, og hele oppsettet er enklere å forstå og feilsøke.
Nyheten blir virkelig nyttig når verktøykassa har en lang hale: noen få funksjoner brukes hele tiden, mens mange spesialfunksjoner bare trengs av og til. De vanligste kan ligge fast i konteksten. Resten kan merkes med defer_loading: true og hentes når oppgaven krever dem.
Hvordan fungerer serverbasert retrieval?
Serverbasert retrieval er standardmodusen og krever to konkrete endringer. Forespørselen må inneholde {"type": "tool_search"}, og hvert funksjonsverktøy som skal holdes tilbake må ha defer_loading: true. Deretter gjør Gemini søket på Googles side.
Fordelen er at det ikke kommer en ekstra tur mellom modellen og applikasjonen. Når Gemini trenger et utsatt verktøy, henter API-et skjemaet internt og fortsetter til et funksjonskall i samme forespørsel. Det finnes heller ingen egen indeks utvikleren må bygge eller drifte.
Det er den enkle varianten, men ikke en magisk en. Navn og beskrivelser må fortsatt være tydelige nok til at modellen finner riktig funksjon. Hvis fem verktøy beskrives som «hent data», har retrieval-laget lite å arbeide med. short_description kan brukes til en kompakt søkebeskrivelse, mens den fulle beskrivelsen følger skjemaet når verktøyet lastes.
Dokumentasjonen sier også at nøyaktig ett tool_search-verktøy er tillatt per forespørsel. Setter du defer_loading uten et serverbasert tool_search, svarer API-et med en 400-feil. Dette er en liten detalj, men akkurat den typen detalj som sparer en utvikler for en unødvendig runde med banning.
Når bør applikasjonen styre søket selv?
Klientbasert retrieval passer når applikasjonen allerede har et eget verktøyregister, en embedding-indeks eller tilgangsregler per bruker. Da settes execution til client, og agenten kaller en søkefunksjon som applikasjonen selv utfører.
Applikasjonen returnerer komplette verktøydefinisjoner som et function_result. De trenger ikke å være deklarert i den opprinnelige forespørselen. Det gjør det mulig å gjøre nye verktøy tilgjengelige midt i en samtale, for eksempel etter at brukeren har koblet til en integrasjon eller fått en ny rolle.
Prisen er én ekstra rundtur for hvert søk. Servermodusen gjør søket internt i ett API-kall, mens klientmodusen venter på at din kode skal finne og returnere resultatene. Det er en fornuftig pris når egne tillatelser, navneregler eller sikkerhetsfiltre er viktigere enn lavest mulig forsinkelse.
Her ligger kanskje den mest interessante arkitekturmessige forskjellen. Servermodus er et praktisk standardvalg for et stort, fast bibliotek. Klientmodus gir kontroll over hvilke verktøy den enkelte bruker får oppdage. Retrieval er dermed ikke bare tokenøkonomi; det kan også bli et lag mellom agentens ønsker og applikasjonens faktiske rettigheter.
Hva betyr dette for MCP-servere?
Tool Retrieval støtter eksterne MCP-servere i Gemini API. En utvikler kan sette defer_loading: true på selve mcp_server-verktøyet, slik at alle verktøyene serveren eksponerer lastes ved behov. Det er langt ryddigere enn å trekke hele katalogen inn i startkonteksten.
Dette er spesielt relevant når én MCP-server har dusinvis av funksjoner, eller når agenten er koblet til flere servere samtidig. Uten retrieval blir et åpent standardgrensesnitt fort en effektiv måte å fylle prompten med skjemaer på. Med retrieval kan integrasjonene være tilgjengelige uten at alle detaljene følger med hver gang.
Google kjører selve kallet mot en ekstern MCP-server når den valgte funksjonen tilhører serveren. Egne lokale funksjoner returneres fortsatt som vanlige function_call-steg som applikasjonen må utføre. Responsen viser begge typene, slik at det fortsatt er mulig å følge kjeden.
Jeg ville likevel ikke koblet til en stor MCP-server og antatt at jobben er gjort. Gode navn, presise beskrivelser, minst mulige tilganger og logging er fortsatt nødvendig. Retrieval reduserer hva modellen må lese samtidig. Det avgjør ikke om verktøyet burde få lov til å slette en database.
Koster Tool Retrieval ekstra?
Tool Retrieval har ingen egen stykkpris. Google fakturerer input- og output-tokens etter den vanlige prisen for Gemini-modellen som brukes. tool_search legger til en liten, fast blokk med input-tokens, og hvert skjema som faktisk lastes blir fakturert som input resten av samtalen.
Besparelsen kommer derfor ikke gratis i hvert kall. Den oppstår når skjemaene som aldri lastes er større enn retrieval-overhodet og skjemaene modellen faktisk trenger. For store biblioteker med mange sjelden brukte verktøy er det et godt utgangspunkt. For ti små funksjoner kan regnestykket like gjerne gå motsatt vei.
Funksjonen kan kombineres med prefix caching. Utsatte skjemaer ligger ikke i begynnelsen av prompten, og skjemaer som hentes legges til senere i samtalen. Dermed kan den cachede starten være lik fra tur til tur, i stedet for å bli endret av hvilke verktøy som ble aktuelle underveis.
Google publiserer ikke et universelt prosenttall for sparte tokens eller lavere forsinkelse. Det er bra, for et slikt tall ville vært nesten meningsløst uten antall verktøy, størrelsen på skjemaene og bruksmønsteret. Mål minst input-tokens, responstid og feil verktøyvalg før og etter endringen. Ellers vet du bare at retrieval finnes, ikke at det hjelper.
Hvilke begrensninger må utviklere kjenne til?
Tool Retrieval er i preview og krever v1beta-versjonen av API-et. Det støttes i Interactions API, men ikke i den eldre generateContent-metoden. Google oppgir støtte fra Gemini 3.6 og nyere modeller, inkludert alle Gemini 4-modellene.
API-flaten kan endres før funksjonen blir allment tilgjengelig. Jeg ville derfor lagt integrasjonen bak et tydelig lag i egen kode, ikke spredd tool_search-spesifikke antakelser over hele applikasjonen. Preview betyr at funksjonen kan brukes og måles nå, men også at vedlikehold hører med i pakken.
Ved samtaler over flere turer må hele tools-listen sendes på nytt i hver forespørsel, også når previous_interaction_id brukes. Interactions API lagrer steghistorikken, men tar ikke automatisk med alle verktøydeklarasjonene videre. Utelatte verktøy kan føre til at modellen fortsetter å forsøke funksjoner den ikke lenger har fått deklarert.
Tool Retrieval løser heller ikke kvaliteten på selve funksjonskallingen. En modell kan fortsatt velge feil verktøy, sende dårlige argumenter eller misforstå oppgaven. Den nye funksjonen handler om å gi modellen et mer håndterlig utvalg av skjemaer, ikke om å gjøre utførelsen feilfri. Det er samme grunn til at en liten modell som Needle kan være interessant for spesialisert tool calling: Verktøyvalg er et eget problem, ikke bare en fotnote til språkmodellen.
Hvem bør prøve funksjonen nå?
Utviklere med store og forholdsvis stabile verktøybiblioteker er den tydeligste målgruppen. Har agenten færre enn omtrent 20 enkle verktøy, er statisk lasting fortsatt det naturlige utgangspunktet. Har den 50, 100 eller flere funksjoner, er det verdt å sammenligne serverbasert retrieval mot dagens oppsett.
Applikasjoner med egne registre og brukeravhengige rettigheter bør vurdere klientmodusen. Da kan søket respektere tenant, rolle, abonnement og integrasjoner før modellen får se hele skjemaet. Ulempen er en ekstra rundtur og mer kode som må driftes.
Jeg ville startet med å la de mest brukte og mest tidskritiske verktøyene ligge fast, og utsette den lange halen. Deretter ville jeg logget hvilke verktøy retrieval finner, hvor mange skjemaer som lastes og om agenten faktisk velger bedre. Det er en liten, kontrollert endring som kan reverseres hvis resultatene ikke holder.
Google har allerede laget smalere API-er for agentarbeid, blant annet Gemini Decisions API for raske, avgrensede valg. Tool Retrieval angriper et annet lag: hvordan en generell agent finner fram i et stort handlingsrom uten å få hele bruksanvisningen på fanget hver gang. Det er ikke spektakulært på en scene. I en ekte agentarkitektur kan det være langt mer verdifullt.
Min foreløpige dom er derfor positiv og praktisk: Dette er en fornuftig måte å skalere verktøysett på, særlig sammen med MCP. Men ikke gjør preview om til produksjonsgevinst på tro alene. Bruk funksjonen der biblioteket faktisk er stort, behold en enkel kontrollgruppe og la målingene avgjøre.
Ofte stilte spørsmål
Må jeg bygge en egen søkeindeks for Gemini Tool Retrieval?
Nei, ikke i servermodus. Gemini søker i de deklarerte verktøyene på Googles side og laster skjemaet i samme API-forespørsel. En egen indeks er aktuell i klientmodus, når applikasjonen selv skal styre søk, tilgang og hvilke verktøy som kan dukke opp.
Fungerer Tool Retrieval med alle Gemini-endepunkter?
Nei. Funksjonen krever Interactions API og beta-versjonen v1beta. Den støttes ikke av generateContent. Google oppgir Gemini 3.6 og nyere, inkludert Gemini 4-modellene, som støttede modeller mens funksjonen er i preview.
Er Tool Retrieval nyttig med bare noen få funksjoner?
Som regel ikke. Google anbefaler statisk lasting for færre enn omtrent 20 stabile verktøy. Retrieval gir mest mening når store skjemaer og mange sjelden brukte funksjoner ellers fyller konteksten og gjør verktøyvalget vanskeligere.
Kan Gemini hente verktøy fra en MCP-server ved behov?
Ja. Sett defer_loading: true på et eksternt mcp_server-verktøy. Da holdes serverens verktøyskjemaer utenfor startkonteksten og lastes når modellen trenger dem. Tilganger, logging og sikker utførelse må fortsatt håndteres som før.