Innhold Vis
CLM-8B er en åpen AI-modell som hjelper en agent med å velge mellom mulige handlinger, uten å bruke tid på å generere et nytt tekstsvar. I stedet sammenligner den agentens nåværende tilstand med en liste over kandidater og gir hver handling en poengsum.
Det høres kanskje ut som en liten komponent ved siden av de store språkmodellene. I en agent som skal velge verktøy, rute en oppgave eller plukke den beste av flere løsninger, kan akkurat denne komponenten bli spurt igjen og igjen. Da betyr latenstid mye. Teamet bak CLM-8B oppgir opptil ni ganger lavere latenstid enn TypeSafes Jev i zero-shot-testene sine.
Jeg liker retningen. Ikke alle avgjørelser i en AI-agent trenger en modell som tenker høyt og skriver et lite essay før den trykker på riktig knapp. Men CLM-8B er heller ikke en ny generell språkmodell eller en magisk autopilot. Den er en spesialisert dommer som foreløpig bare er testet av utviklerne for valg som allerede finnes.
Hva er CLM-8B?
CLM-8B er en såkalt System One-modell for raske beslutninger. Den bruker en fryst Qwen3-8B som encoder og to små projeksjonshoder: ett for tilstanden og ett for handlingene. Ifølge det offisielle CLM-repositoriet er hvert hode på rundt 20 millioner parametere.
«System One» betyr her at modellen skal gjøre et raskt valg uten en lang genererings- og resonneringsrunde. Du gir den en tilstand, for eksempel en kundemelding eller statusen i en kodeoppgave, og et avgrenset sett med handlinger. Modellen rangerer handlingene etter hvor godt de passer til tilstanden.
Det gjør CLM-8B egnet til oppgaver som verktøyvalg, ruting, guardrails, søk i en kandidatpool og best-of-N, der flere mulige svar eller løsninger allerede er laget. Den kan også svare gjennom tre strukturerte typer: ja eller nei, valg mellom navngitte alternativer og en gradert poengsum. Grensesnittet er laget for å være kompatibelt med TypeSafes API-format.
Hvorfor kan den være raskere enn Jev?
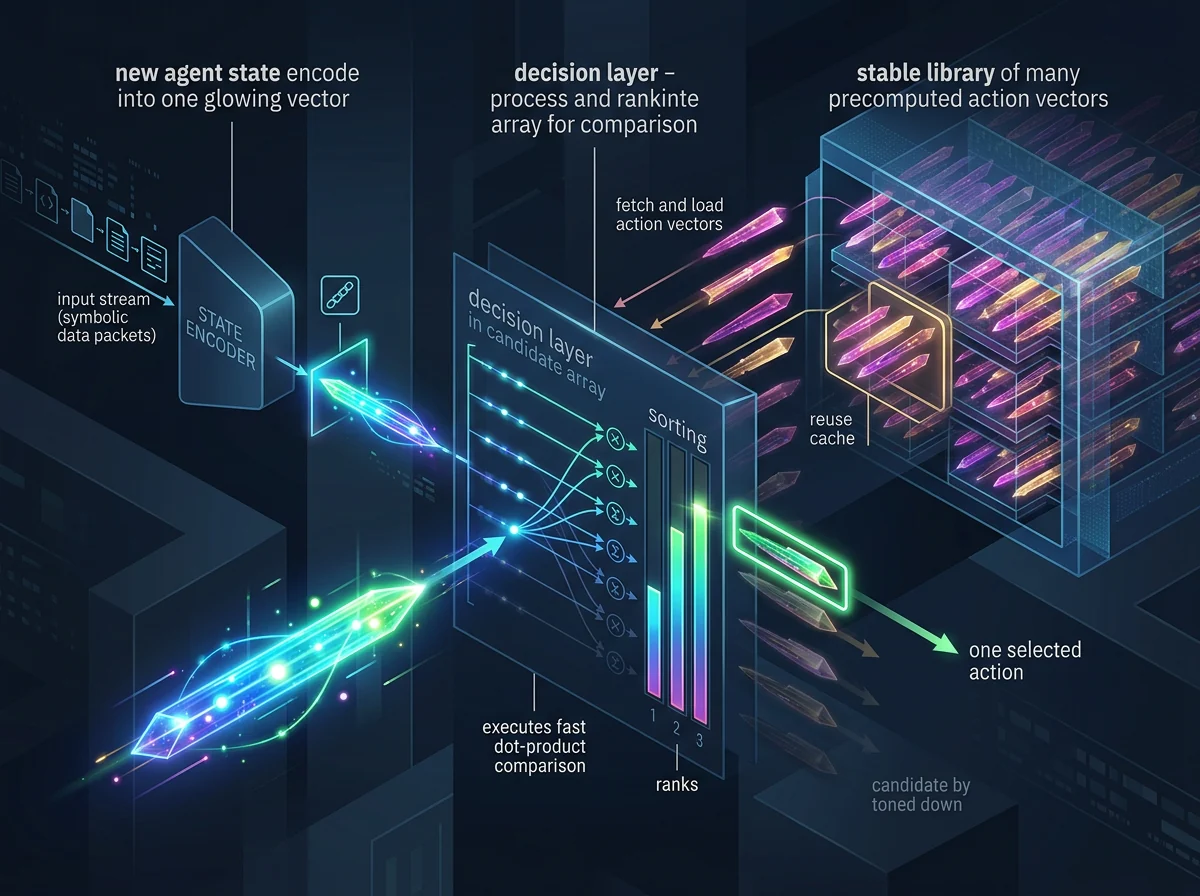
Fartsfordelen kommer først og fremst av at tilstand og handling blir kodet hver for seg. Handlingsvektorene kan dermed lagres og brukes på nytt. Når en agent vurderer de samme verktøyene eller valgene mot en ny tilstand, slipper systemet å beregne hele kandidatlisten fra bunnen av.
Selve sammenligningen blir i praksis et skalarprodukt mellom vektoren for tilstanden og vektoren for hver handling. Det er langt mindre arbeid enn å be en generativ språkmodell lese alt og produsere en ny tekstsekvens for hvert valg. Gevinsten skal være størst når kandidatlisten er lang, eller når de samme kandidatene brukes i mange steg.
I teamets zero-shot-evalueringer på spill, verktøykall og computer use leverte CLM-8B ifølge modellkortet på Hugging Face resultater på nivå med Jev og opptil ni ganger lavere latenstid. Med rundt 1 000 kandidater oppgir modellkortet en forskjell på 13 ganger. Dette er tall fra utviklerne selv, ikke en uavhengig test, så de bør leses som lovende målinger og ikke som en universell fartsfasit.
Det er også viktig å forstå når hurtigbufferen faktisk hjelper. Har agenten en stabil verktøykasse eller en fast liste med mulige handlinger, kan de samme vektorene brukes mange ganger. Hvis både tilstanden og alle kandidatene er nye i hvert eneste steg, må mer av arbeidet gjøres på nytt. Da blir den praktiske fordelen mindre.
Hvordan lærer modellen å velge en handling?
CLM-8B er trent med en toveis kontrastiv InfoNCE-målfunksjon. En riktig kombinasjon av tilstand og handling trekkes nærmere hverandre i et felles vektorrom, mens feil handlinger skyves bort. Målet er ikke å lære modellen å skrive handlingen, men å kjenne igjen hvilken av de oppgitte handlingene som passer best.
Treningen er delt i tre trinn. Teamet oppgir omtrent 60 millioner spørsmål-og-svar-par fra Nemotron DQA i første runde, rundt 30 millioner syntetiske og vanskelige feilalternativer i neste, og cirka én million agentforløp til slutt. De vanskelige feilalternativene er viktige fordi en agent sjelden velger mellom ett åpenbart riktig og ti komisk dårlige svar. De farlige feilene er de som nesten ser riktige ut.
Qwen3-8B-delen holdes fryst. Det er projeksjonshodene som trenes til å plassere tilstand og handling riktig i forhold til hverandre. Dermed kan et spesialisert hode finjusteres uten å trene hele 8B-modellen på nytt. Det offisielle referansehodet er oppgitt til 75 MB, men det er fortsatt avhengig av Qwen3-8B-encoderen og den samme pooling-metoden det ble trent mot.
Arkitekturen er smart fordi den skiller språkforståelsen fra selve beslutningslaget. Den gjør også begrensningen tydelig: Kvaliteten kan aldri bli bedre enn kandidatene modellen får. Hvis riktig handling mangler i listen, kan CLM-8B bare rangere de gale alternativene.
Hva viser testene på kodeagenter?
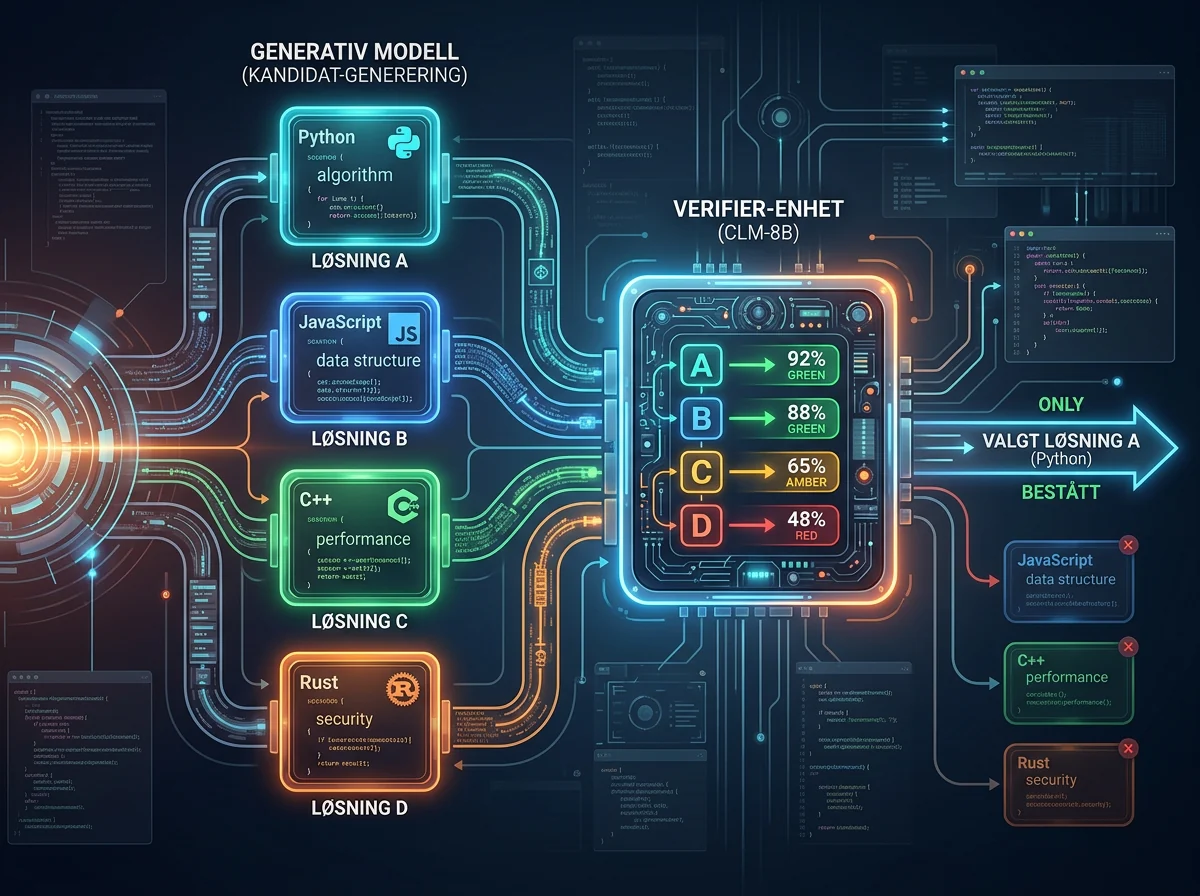
Som finjustert verifier oppgir teamet 81,6 prosent på 38 hold-out-oppgaver fra DeepSWE og 87,6 prosent på 30 hold-out-oppgaver fra Terminal-Bench 2.1. I disse forsøkene ble flere løsninger først generert av andre modeller, før CLM-8B valgte kandidaten den vurderte som best.
Dette er en annen oppgave enn zero-shot-rangeringen. De høye kodeagentresultatene kommer fra egne finjusterte hoder, ikke fra referansemodellen rett ut av boksen. Den forskjellen står også uttrykkelig i modellkortets begrensninger. Å installere standardversjonen betyr altså ikke at du automatisk får 81,6 prosent på dine egne kodeoppgaver.
Teamet melder samtidig at den finjusterte modellen kjørte 4,1 til 5,7 ganger raskere enn Jev i verifier-oppsettet. Jev skal ha havnet under vanlig pass@1 i disse langvarige oppgavene, mens CLM valgte riktig løsning oftere. Det er et interessant resultat, men utvalgene på 38 og 30 hold-out-oppgaver er små. Oppgavene, kandidatgeneratorene og finjusteringen betyr mye.
Det praktiske poenget er derfor ikke at CLM-8B «løser» kodeagenter. Poenget er at en agent kan bruke mer beregning på å lage flere mulige løsninger, og deretter bruke en raskere spesialist til å velge. Det ligner arbeidsdelingen i flere agentsystemer, blant annet når en forskningsagent lar ulike komponenter planlegge, søke og kontrollere. Jeg har tidligere skrevet om Nvidia AI-Q som en åpen fleragent-arkitektur; CLM-8B passer inn som en mulig beslutningskomponent i slike kjeder, ikke som en erstatning for hele kjeden.
Hva er begrensningene?
Den største begrensningen er enkel: CLM-8B genererer ikke. Den kan ikke finne opp et nytt verktøy, skrive løsningen eller formulere en handling som mangler. Den gir relative sannsynligheter innenfor kandidatsettet du sender inn. Et høyt tall betyr at én kandidat ser best ut blant de tilgjengelige, ikke at handlingen er korrekt i absolutt forstand.
Referansehodet er også låst til embeddings fra Qwen3-8B med last-token pooling. Du kan ikke uten videre bytte inn en annen encoder og forvente at det samme hodet virker. Teamet beskriver dette som ett trinn på en skaleringsstige og varsler sterkere og multimodale varianter senere. Det er en plan, ikke en funksjon i modellen som er tilgjengelig nå.
Jeg er generelt skeptisk til å trekke store konklusjoner fra utviklernes egne benchmarks, og det gjelder også her. «Opptil ni ganger» beskriver det beste utslaget i en samling tester, ikke en garanti for alle agenter. Ytelsen avhenger blant annet av antall kandidater, hvor ofte de kan gjenbrukes, maskinvaren, cache-treff og hvor godt treningsdataene ligner oppgaven.
Qwen3-8B som grunnmodell er heller ikke en uvesentlig detalj hvis du vurderer modellen for sensitiv drift. CLM-koden og vektene er publisert under Apache 2.0, og lokal kjøring gir kontroll over dataflyten. Men åpen lisens erstatter ikke en vanlig vurdering av modellopphav, avhengigheter og hva du faktisk sender inn.
Kan CLM-8B kjøres lokalt?
Ja. Kode, modellhode og vekter er åpent tilgjengelige under Apache 2.0, og oppsettet er laget for egen drift. Den offisielle installasjonen krever Python 3.10 eller nyere, Linux og en Nvidia-GPU. Qwen3-8B kjøres som en pooling-encoder gjennom vLLM, mens CLM-serveren tilbyr API, hurtigbuffer og et enkelt webgrensesnitt.
At hodet bare er 75 MB betyr ikke at hele løsningen er en 75 MB-modell. Du må fortsatt kjøre Qwen3-8B og ha infrastrukturen rundt. Derimot er det lite å laste og bytte når du trener et nytt hode for en bestemt verifier- eller rangeringsoppgave.
API-et støtter Choice, Noul og Score, i tillegg til direkte rangering av frie kandidater. En forespørsel skrevet for TypeSafe-formatet skal kunne spilles av mot CLM-serveren. Det gjør det enklere å sammenligne de to i den samme applikasjonen, men kompatibelt grensesnitt betyr ikke identisk oppførsel eller kvalitet.
For utviklere som allerede kjører lokale modeller, er dette en overkommelig komponent å eksperimentere med. Det finnes likevel ingen dokumentert inference-leverandør på Hugging Face-modellkortet ved lansering. Den mest konkrete bruken nå er derfor selvhosting og testing, ikke å bytte én sky-URL med en annen.
Når gir en egen beslutningsmodell mening?
CLM-8B gir mest mening når agenten tar mange gjentatte valg fra et kjent sett. Det kan være ruting mellom avdelinger, valg av verktøy, prioritering av dokumenter eller rangering av flere ferdige kodeforslag. Da kan lav latenstid og gjenbruk av handlingsvektorer gi en reell fordel.
Hvis oppgaven krever en ny plan, kreativ tekst eller en handling som ikke er definert på forhånd, trenger du fortsatt en generativ modell. Mange systemer vil derfor bruke begge deler: En språkmodell lager alternativer eller oppdaterer planen, mens en rask scorer velger blant alternativer som allerede finnes.
Dette kan også gjøre arkitekturen lettere å måle. I stedet for at én enorm modell både foreslår, vurderer og godkjenner sitt eget arbeid, kan beslutningspunktet testes separat. Du kan logge kandidatene, se rangeringen og sammenligne valget med fasiten. En åpen modell gjør det mulig å finjustere og kjøre denne delen lokalt.
Men start med et konkret problem, ikke med modellnavnet. Lag et representativt datasett med faktiske tilstander og handlinger. Sammenlign CLM-8B med en enkel regel, en embedding-basert baseline og modellen du bruker i dag. Mål både kvalitet, halen på latenstiden og hva som skjer når riktig handling ikke er med. Hvis hurtigbufferen er hele poenget, må testen også ligne produksjonen nok til at kandidatene faktisk blir gjenbrukt.
En rask dommer er nyttig – når dommeren får gode valg
CLM-8B viser en fornuftig vei videre for AI-agenter: Bruk den dyre generative modellen der det trengs, og bruk en mindre beslutningskomponent når jobben bare er å velge. At tilstander og handlinger kan lagres hver for seg, er ikke bare en pen teknisk detalj. Det er selve grunnen til at modellen kan kutte ventetiden i agentløkker med gjentatte valg.
Lanseringen er samtidig et godt eksempel på hvorfor benchmarktall må pakkes ut. Opptil ni ganger raskere gjelder teamets zero-shot-oppsett. Resultatene på 81,6 og 87,6 prosent gjelder egne, finjusterte verifier-hoder på små hold-out-sett. Standardmodellen arver ikke automatisk disse resultatene på en annen kodebase.
Likevel er dette mer enn enda en 8B-modell med en lang tabell. CLM-8B forsøker ikke å være en ny chatbot. Den gjør én avgrenset jobb, den kan kjøres på egen maskinvare, og både kode og vekter er åpne. For agenter som stadig må velge mellom de samme verktøyene og handlingene, kan akkurat det være langt mer nyttig enn enda en modell som er flink til å prate.
Ofte stilte spørsmål
Er CLM-8B en vanlig språkmodell?
Nei. CLM-8B genererer ikke fritekst som en chatbot. Den sammenligner en tilstand med handlinger du allerede har definert, og rangerer dem. Qwen3-8B brukes som encoder, mens egne projeksjonshoder lærer sammenhengen mellom tilstand og handling.
Er CLM-8B virkelig ni ganger raskere enn Jev?
Teamet bak modellen rapporterer opptil ni ganger lavere latenstid i sine zero-shot-tester. Det er ikke en garanti for alle oppsett. Gevinsten avhenger særlig av hvor mange kandidater agenten vurderer, og om handlingsvektorene kan lagres og brukes på nytt.
Kan CLM-8B erstatte modellen i en kodeagent?
Ikke alene. CLM-8B kan velge mellom flere ferdige løsningsforslag, men den skriver ikke selve løsningen. I en kodeagent fungerer den derfor som rangeringsmodell eller verifier ved siden av en generativ modell som lager kandidatene.
Hva trenger jeg for å kjøre CLM-8B selv?
Det offisielle oppsettet krever Linux, Python 3.10 eller nyere og en Nvidia-GPU. Du må kjøre Qwen3-8B som pooling-encoder i tillegg til det lille CLM-hodet. Koden og modellvektene er publisert under Apache 2.0.