Innhold Vis
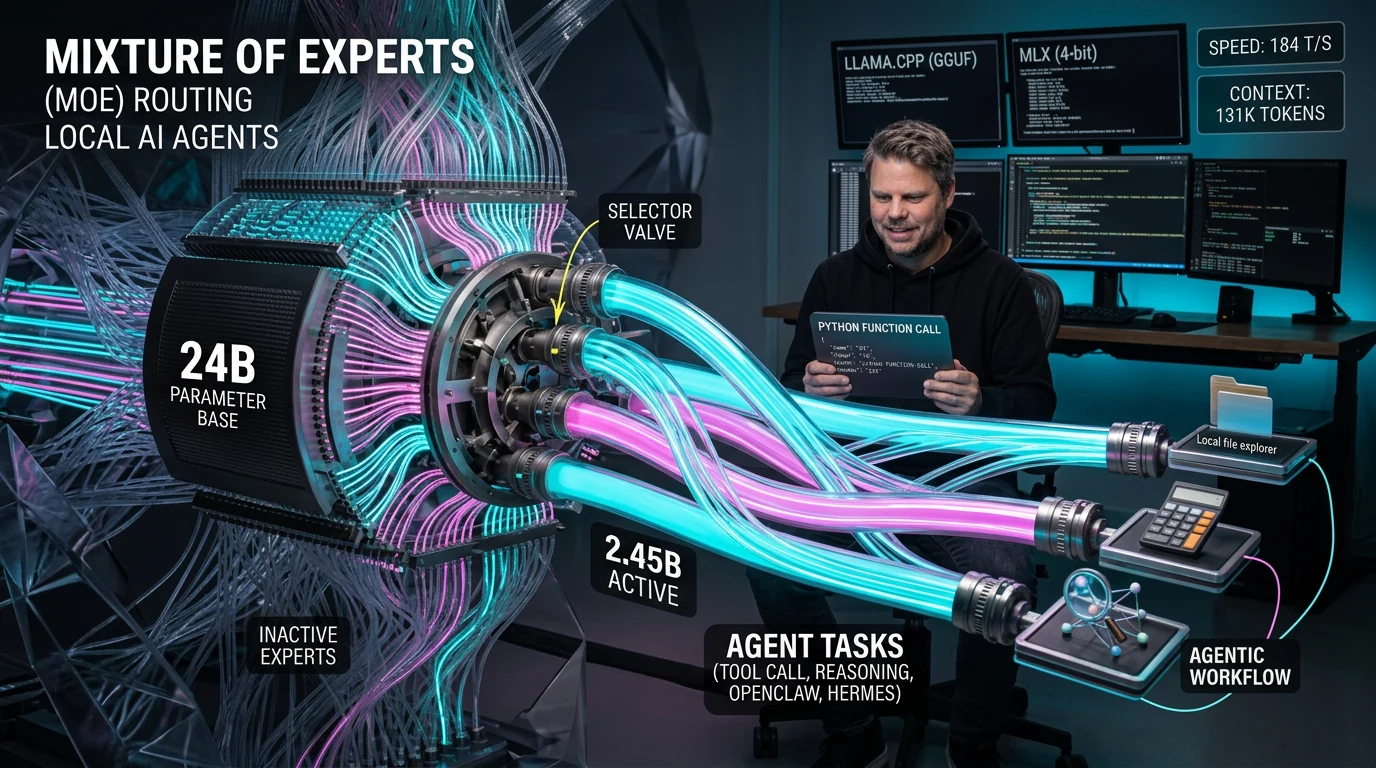
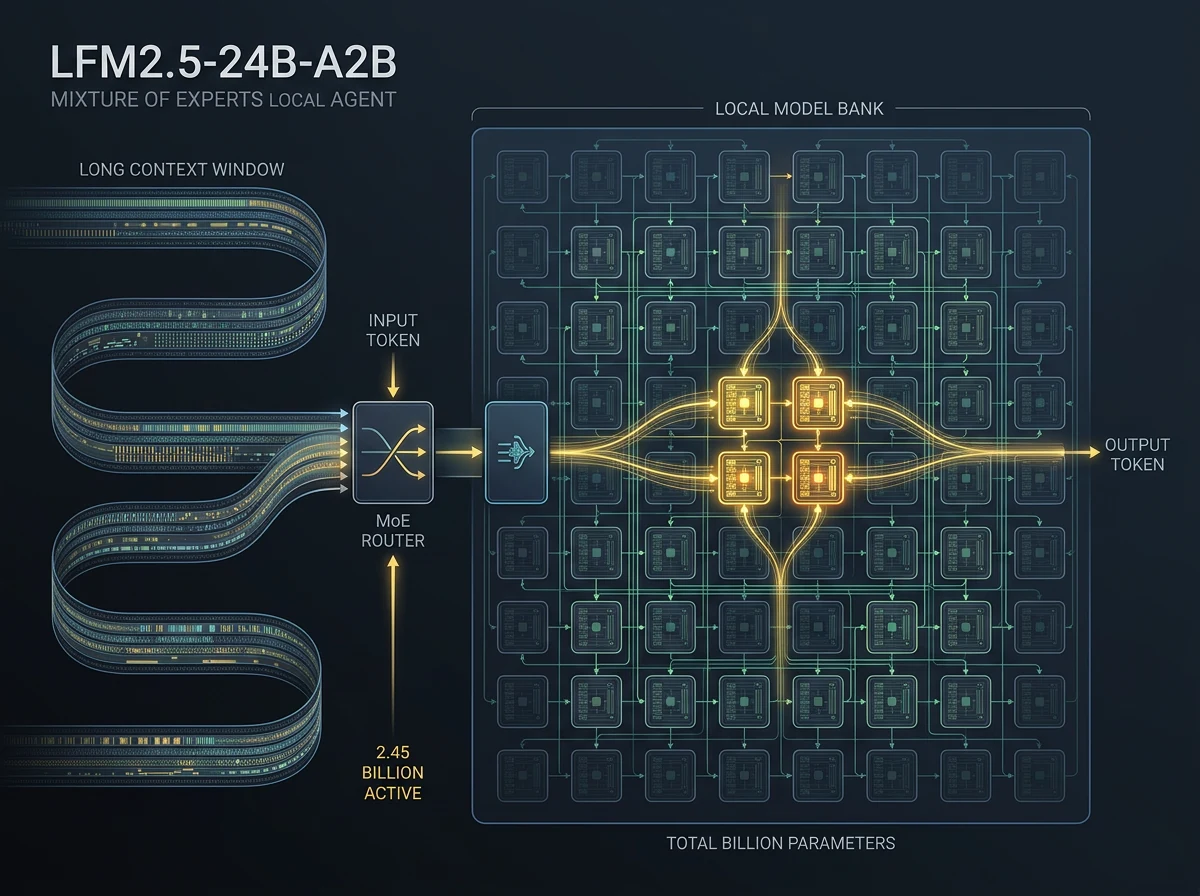
LFM2.5-24B-A2B er bygget for deg som vil kjøre raske, private AI-agenter på egen maskin uten å sende hver oppgave til en ekstern API-tjeneste. Modellen har 24 milliarder parametere totalt, men aktiverer bare 2,45 milliarder for hvert token. Det gjør langvarig agentarbeid langt mer realistisk på lokal maskinvare enn størrelsen først antyder.
Dette er ikke først og fremst en modell som skal kunne litt av alt og vinne hvert eneste benchmark. Liquid AI har spisset den mot resonnering, verktøykall og flertrinnsoppgaver i agentrammeverk som Hermes Agent, OpenClaw, Pi og OpenCode. Den kan serveres lokalt gjennom blant annet llama.cpp, MLX, vLLM og SGLang.
Det er en fornuftig prioritering. En lokal agent trenger ikke nødvendigvis å kunne svare på ethvert faktaspørsmål fra hukommelsen. Den må forstå instruksjonen, velge riktig verktøy, tolke resultatet og holde stø kurs gjennom flere steg. Der ser LFM2.5-24B-A2B svært lovende ut – med det viktige forbeholdet at fartstallene og testresultatene foreløpig kommer fra Liquid AI selv.
Hva er LFM2.5-24B-A2B?
LFM2.5-24B-A2B er en tekstbasert resonneringsmodell med Mixture of Experts-arkitektur. Ifølge det offisielle modellkortet har den 24 milliarder parametere totalt, 2,45 milliarder aktive parametere, 40 lag og et kontekstvindu på 131 072 tokens.
Navnet A2B er altså en avrunding av hvor mye av modellen som arbeider per token. Hver MoE-blokk har 64 eksperter, men bare fire rutes inn om gangen. Du må fortsatt lagre modellvektene, så dette er ikke en modell på bare to milliarder parametere i vanlig forstand. Gevinsten ligger i at langt mindre av modellen regner på hvert token.
Modellen er alltid i resonneringsmodus og produserer en eksplisitt tenkedel før sluttsvaret. Kontekstvinduet har økt fra 32 000 tokens i forgjengeren til 131 072, mens vokabularet er doblet fra 65 000 til 128 000 tokens. Den støtter 16 språk, men norsk står ikke på den oppgitte språklisten. Det betyr ikke at norsk er umulig, men kvaliteten må testes før modellen får ansvar for norske kundedialoger eller dokumenter.
Hvorfor passer modellen til lokale AI-agenter?
Modellen er trent for flertrinnsarbeid, verktøykall og samspill med agentrammeverk. Liquid AI har brukt agentiske forløp både under trening og ettertrening, og den siste fasen omfattet forsterkende læring inne i OpenClaw, Hermes Agent, Pi og OpenCode. Det er mer relevant for en agent enn å være flink til å fullføre enkeltstående spørsmål i et chattevindu.
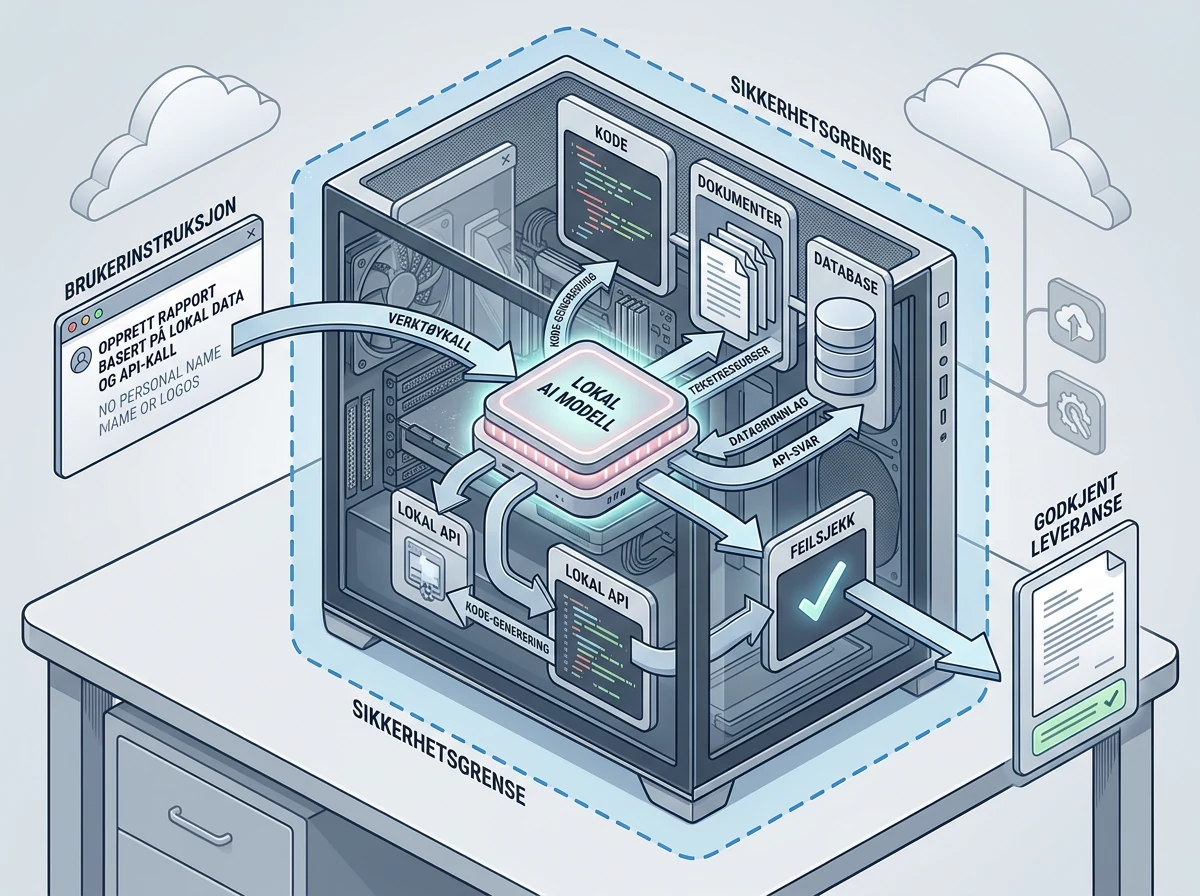
Verktøystøtten følger en tydelig kjede: Agenten får funksjonsdefinisjoner, lager et verktøykall, mottar resultatet med rollen tool og bruker dette til å formulere sluttsvaret. Standardformatet er Python-lignende funksjonskall, men systemprompten kan be om JSON. Det siste er viktig hvis rammeverket ditt forventer et bestemt format og ellers bare sitter der og ser dumt på et helt gyldig svar.
Modellen kan ligge bak et lokalt OpenAI-kompatibelt endepunkt. Da kan et eksisterende agentrammeverk kobles til en lokal adresse i stedet for en ekstern modellleverandør. Liquid AI har ferdige oppsett for flere populære rammeverk, og modellkortet viser konfigurasjon for blant annet Hermes Agent, OpenClaw og Pi.
Personverngevinsten er enkel å forstå: Prompt, dokumenter og verktøyresultater kan bli på maskinen eller i eget nettverk. Men «lokal» gjør ikke hele agenten privat av seg selv. Kobler du agenten til nettsøk, skytjenester, eksterne databaser eller andre API-er, forlater data fortsatt maskinen gjennom disse verktøyene. Modellen er lokal. Resten av arbeidsflyten må vurderes separat.
Hvor rask er LFM2.5-24B-A2B?
Liquid AI måler 184 tokens per sekund på en Apple M5 Max og 114 tokens per sekund på en AMD Ryzen AI Max+ 395. Testene ble kjørt med llama.cpp, Q4_K_M-kvantisering og en prompt på 4 000 tokens. Selskapet hevder at modellen er opptil 1,7 ganger raskere enn de sammenlignbare MoE-modellene i samme test.
På en NVIDIA B300 oppgir Liquid AI over 21 000 output-tokens per sekund ved høy samtidighet. Det tallet beskriver samlet gjennomstrømming med mange forespørsler i arbeid samtidig, ikke hvor fort én person får svar på én prompt. Målingen brukte BF16-vekter, SGLang 0.5.22, 1 024 input-tokens og opptil 256 output-tokens.
De to tallene svarer derfor på helt forskjellige spørsmål. For en agent på en lokal Mac eller PC er hastigheten per enkelt strøm mest relevant. For en server som betjener mange agenter samtidig er samlet gjennomstrømming viktigere. Ikke legg 21 000 tokens per sekund inn i budsjettet for en vanlig arbeidsstasjon og bli skuffet når fysikken møter markedsføringen.
Den faktiske farten vil også avhenge av kvantisering, minnebåndbredde, kontekstlengde, backend og hvor mye modellen resonnerer. En agent som tenker lenge og gjør fem verktøykall kan bruke mer tid enn en modell som leverer et kort direkte svar, selv om selve tokenproduksjonen er raskere.
Er den god nok til verktøybruk og koding?
På Liquid AIs egne tester leder eller matcher modellen konkurrentene på fem av åtte tester for verktøybruk og agentarbeid. Den får 80,71 poeng på ToolSandbox og 65,01 på BFCLv4. På LiveClaw får den 48,09 poeng mot 38,19 for Qwen3.6-35B-A3B. Tallene tyder på at den lille aktive delen ikke hindrer modellen i å håndtere verktøy og instrukser.
Bildet er mindre imponerende på alle områder. Qwen-modellen gjør det bedre på WebArena Verified, og større modeller beholder et forsprang på kunnskapstunge oppgaver og kodearbeid. På SWE-Bench Verified med OpenCode får LFM2.5-modellen 51,0, mens Qwen3.6-35B-A3B får 66,2. Det er ikke en katastrofe. Det er et ganske tydelig kart over hva modellen er laget for.
Jeg ville derfor ikke valgt den som eneste hjerne i en arbeidsflyt der omfattende kodeendringer eller bred faktakunnskap er hovedjobben. Som lokal agentmodell for tydelige oppgaver, faste verktøy og kontrollerbare datakilder er den langt mer interessant. Liquid AI anbefaler selv å koble inn RAG eller nettsøk ved kunnskapstunge oppgaver.
Benchmarker er uansett ikke det samme som ditt arbeid. Den nyttige testen er om agenten velger riktig verktøy, sender riktige argumenter, oppdager feil og fullfører hele jobben uten at du må redde den halvveis. Mål godkjente leveranser og feilrate, ikke bare tokens per sekund.
Hva kreves for å kjøre modellen lokalt?
Liquid AI tilbyr originalmodellen for Transformers, vLLM og SGLang, en FP8-utgave for høy GPU-gjennomstrømming, GGUF-kvantiseringer for llama.cpp og kompatible verktøy, en 4-bits MLX-utgave for Apple Silicon og ONNX for kjøring på flere typer maskinvare. Modellkortet samler de offisielle variantene.
Liquid AI oppgir ikke ett universelt minnekrav, og det ville også vært misvisende. Minnebruken avhenger av format, kvantisering, backend og hvor mye av kontekstvinduet du faktisk bruker. At bare 2,45 milliarder parametere er aktive per token betyr heller ikke at bare disse vektene må ligge tilgjengelig. Velg derfor variant etter maskinen, ikke etter A2B-navnet alene.
For direkte bruk med Transformers kreves transformers>=5.0.0. Den grunnleggende kommandoen er pip install -U transformers, før modellen lastes som LiquidAI/LFM2.5-24B-A2B. På kompatibel GPU kan Flash Attention 2 aktiveres, men det er en valgfri innstilling – ikke en forutsetning for å laste modellen.
Vil du bruke modellen som agent, er det ryddigst å servere den bak et OpenAI-kompatibelt API. Porten avhenger av backend: llama.cpp og MLX bruker typisk 8080, vLLM 8000, SGLang 30000 og LM Studio 1234. Agentrammeverket må peke til riktig base_url, bruke modellnavnet LFM2.5-24B-A2B og settes opp med kontekstvinduet på 131 072 tokens.
Hva er begrensningene?
Dette er en tekstmodell. Den tar ikke bilder, lyd eller video som input. Den er heller ikke anbefalt som frittstående løsning for kunnskapstunge oppgaver, og norsk er som nevnt ikke blant de 16 språkene Liquid AI oppgir. I tillegg tenker modellen før hvert svar. Det er nyttig i agentarbeid, men kan være unødvendig kostbart i tokens for helt enkle oppgaver.
Modellen er tilgjengelig med åpne vekter under Liquid AI sin LFM1.0-lisens. Åpne vekter er ikke automatisk det samme som en klassisk open source-lisens uten særvilkår. Skal modellen bygges inn i et produkt eller brukes kommersielt, bør lisensen leses før du investerer tid i integrasjonen.
Resultatene er dessuten leverandørmålinger. Liquid AI oppgir evalueringsinnstillingene ganske detaljert, og det er bra, men uavhengige tester vil gi et sikrere bilde. Sammenlign modellen med det du allerede bruker på de samme oppgavene, med samme verktøy og samme stoppkriterier.
Det finnes også en mer praktisk begrensning: Et kontekstvindu på 131 072 tokens frister folk til å dytte inn absolutt alt. Det kan øke minnebruken, senke farten og gjøre agenten mindre presis. Ryddig kontekst, gode verktøybeskrivelser og målrettet gjenfinning slår ofte en diger usortert prompt.
Hvem bør prøve LFM2.5-24B-A2B?
Modellen er mest interessant for utviklere og mindre bedrifter som vil beholde data lokalt, har tydelige verktøy en agent kan bruke og ønsker lav kostnad per resonneringstoken. Den passer også godt som eksperimentmodell for deg som allerede bruker llama.cpp, MLX, LM Studio, vLLM eller SGLang og vil koble en lokal modell til et eksisterende agentrammeverk.
Vil du sammenligne med en annen modell som er laget for lokalt agentarbeid, har jeg også skrevet om Muse Glimmer som lokal 30B-agentmodell. De bør vurderes på de samme faktiske oppgavene, ikke bare på hvert sitt sett med leverandørtester.
Start med riktig kvantisering for maskinen din. Koble deretter modellen til ett avgrenset verktøysett og en oppgave du kan kontrollere. Logg verktøykall, feil, tidsbruk og hvor ofte resultatet faktisk kan godkjennes. Først da vet du om modellen er rask i betydningen som teller.
Har arbeidsflyten behov for fersk eller omfattende faktakunnskap, legg inn søk eller RAG fra starten. Er tung koding hovedoppgaven, sammenlign med en sterkere kodemodell før du bestemmer deg. LFM2.5-24B-A2B ser ikke ut som den nye kongen av alt. Den ser ut som et uvanlig målrettet verktøy for lokale agenter, og akkurat det kan være mer verdifullt.
Jeg liker retningen. Lokale modeller blir virkelig nyttige når de kan gjøre arbeid, ikke bare svare i et chattevindu. LFM2.5-24B-A2B kombinerer lav aktiv størrelse, lang kontekst og praktisk støtte for agentrammeverk på en måte som fortjener en ordentlig test på egen maskin. Bare behold målebåndet framme. Leverandørtall er starten på vurderingen, ikke slutten.
Ofte stilte spørsmål
Kan LFM2.5-24B-A2B kjøre uten internett?
Ja. Selve modellen kan lastes ned og kjøres lokalt gjennom blant annet llama.cpp, MLX, Transformers, vLLM eller SGLang. Agenten trenger likevel nettilgang hvis du gir den verktøy som nettsøk, eksterne API-er eller skytjenester.
Er LFM2.5-24B-A2B egentlig en modell på to milliarder parametere?
Nei. Modellen har 24 milliarder parametere totalt, men aktiverer 2,45 milliarder for hvert token. Hele modellen må fortsatt være tilgjengelig, mens MoE-rutingen reduserer hvor mye beregning som brukes under generering.
Kan modellen brukes med LM Studio?
Ja. Liquid AI oppgir LM Studio som en støttet måte å kjøre modellen lokalt på, og GGUF-utgavene er laget for llama.cpp og kompatible programmer. Kontroller at programmet og den valgte kvantiseringen støtter modellen før nedlasting./
Er modellen et godt valg til norsk?
Norsk står ikke blant de 16 offisielt oppgitte språkene. Modellen kan fortsatt håndtere norsk, men kvaliteten bør testes på egne tekster, verktøykall og faguttrykk før den brukes i produksjon.