Step 5 Preview åpner vektene – 600B-modellen er bygget for AI-agenter
StepFun har publisert vektene til Step 5 Preview. 27 milliarder parametere er aktive per token, men hele 600B-modellen må fortsatt få plass.
15. oktober 2026
5 visninger
7 minutter lesetid
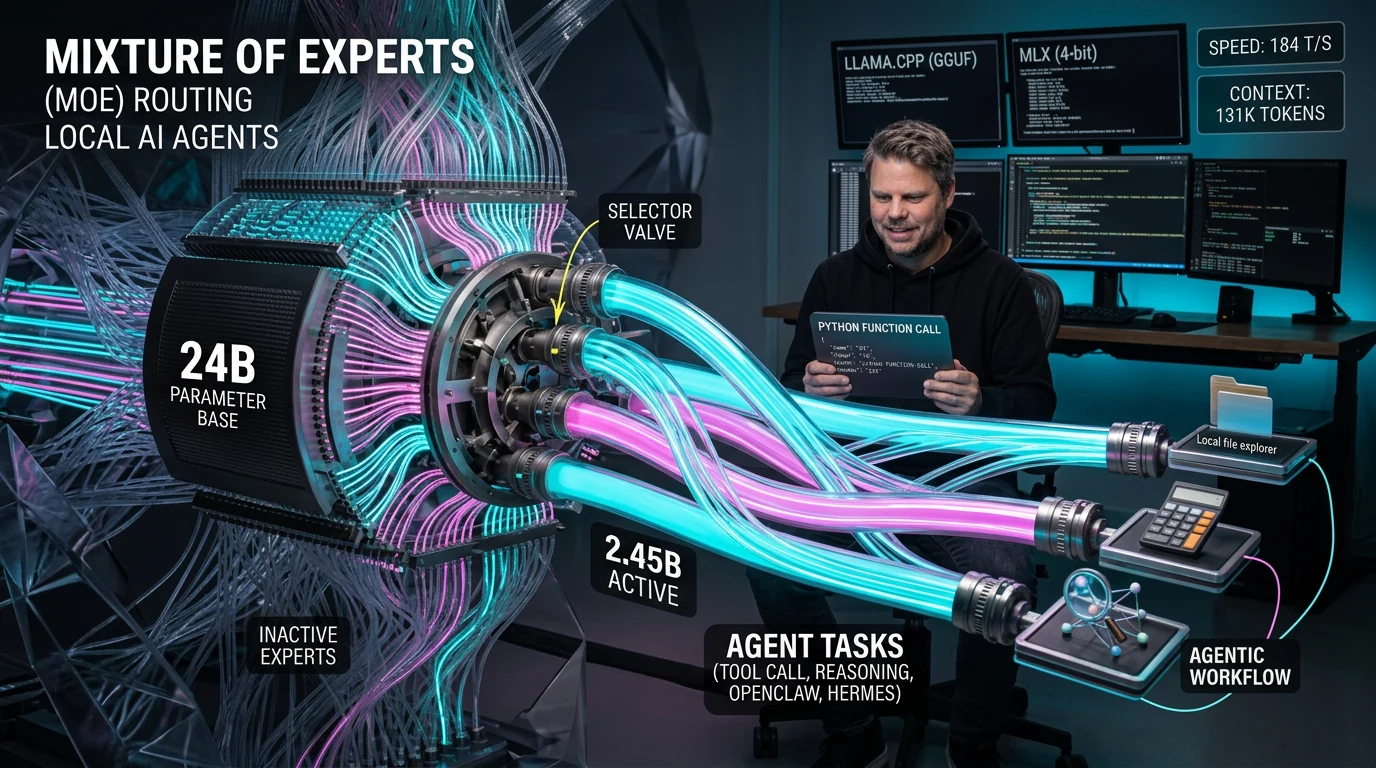
LFM2.5-24B-A2B gjør lokale AI-agenter langt mer interessante
LFM2.5-24B-A2B har 24 milliarder parametere, men bruker bare 2,45 milliarder per token. Se fart, lokal agentstøtte, maskinvarekrav og klare begrensninger.
14. oktober 2026
11 visninger
7 minutter lesetid
Qwen3.8-Flash-Next viser Qwen4-arkitekturen – men dette er ingen liten 6B-modell
Qwen3.8-Flash-Next gir en åpen forhåndsvisning av Qwen4-arkitekturen. Her er hva 6B aktive parametere, QSA og 262 144 token betyr for lokal kjøring i praksis.
26. august 2026
68 visninger
7 minutter lesetid
Z.AI bekrefter Ox Alpha – åpne modellvekter kommer
Ox Alpha fra Z.AI får åpne modellvekter. Se hva som er bekreftet om lokal kjøring, databruk, GLM-5.3 og påstanden om at modellen faktisk utfordrer DeepSeek.
26. august 2026
74 visninger
7 minutter lesetid
IBM Granite 4.2 gjør lokale AI-agenter mer praktiske
IBM Granite 4.2 har 3B-, 8B- og 30B-modeller for lokale AI-agenter, med justerbar reasoning og agenttrening. Se hvorfor 8B er det naturlige startpunktet.
26. august 2026
88 visninger
7 minutter lesetid
Qwen passerer 3 milliarder nedlastinger – slår Meta og Google
Qwen har passert 3 milliarder nedlastinger på seks måneder og gått forbi Meta og Google. Slik ble Alibaba størst blant åpne AI-modeller på Hugging Face.
17. august 2026
82 visninger
7 minutter lesetid
Muse Glimmer: lokal 30B-agentmodell for 24 GB VRAM
Muse Glimmer er Metas 30B-modell med åpne vekter for lokale AI-agenter. Den offisielle 4-bit-utgaven på 17 GB er laget for maskinvare med 24 GB minne.
10. august 2026
136 visninger
8 minutter lesetid
AI-musikk er musikk – men et tastetrykk gjør deg ikke til komponist
AI-musikk har lav terskel, men resultatet er fortsatt musikk. Det interessante er hvem som har formet uttrykket, hvor mye arbeid som ligger bak, og om opphavsretten er respektert.
25. juli 2026
129 visninger
8 minutter lesetid
Solar Open 2 gir AI-agenter én million tokens – men krever fire H200
Solar Open 2 kombinerer én million tokens med 15B aktive parametere for AI-agenter. Den fulle 250B-modellen krever minst fire Nvidia H200-kort lokalt.
22. juli 2026
105 visninger
6 minutter lesetid
MTP merget inn i llama.cpp – nå kan alle kjøre det
PR 22673 er merget inn i llama.cpp master. MTP-støtte gir 1,9x til 2,5x raskere inferens lokalt – her er hva du trenger å vite og hvordan du aktiverer det.
18. mai 2026
462 visninger
3 minutter lesetid
Gemma-4-31B-it-DFlash – spekulativ dekoding for Googles åpne modell
Gemma-4-31B-it-DFlash er en ny variant av Googles Gemma 4 31B utgitt av Z Lab, med DFlash spekulativ dekoding som kan gi opptil 8x raskere inferens. Llama.cpp-støtte er under utvikling via PR #22105.
1. mai 2026
230 visninger
4 minutter lesetid
Gemma 4 – Google lanserer åpne AI-modeller med Apache 2.0-lisens
Google lanserte Gemma 4 den 2. april 2026 med Apache 2.0-lisens – den første Gemma-modellen som er fullt åpen for kommersiell bruk. Fire varianter fra 2,3 til 31 milliarder parametere, multimodal støtte og 128-256K kontekstvindu.