Innhold Vis
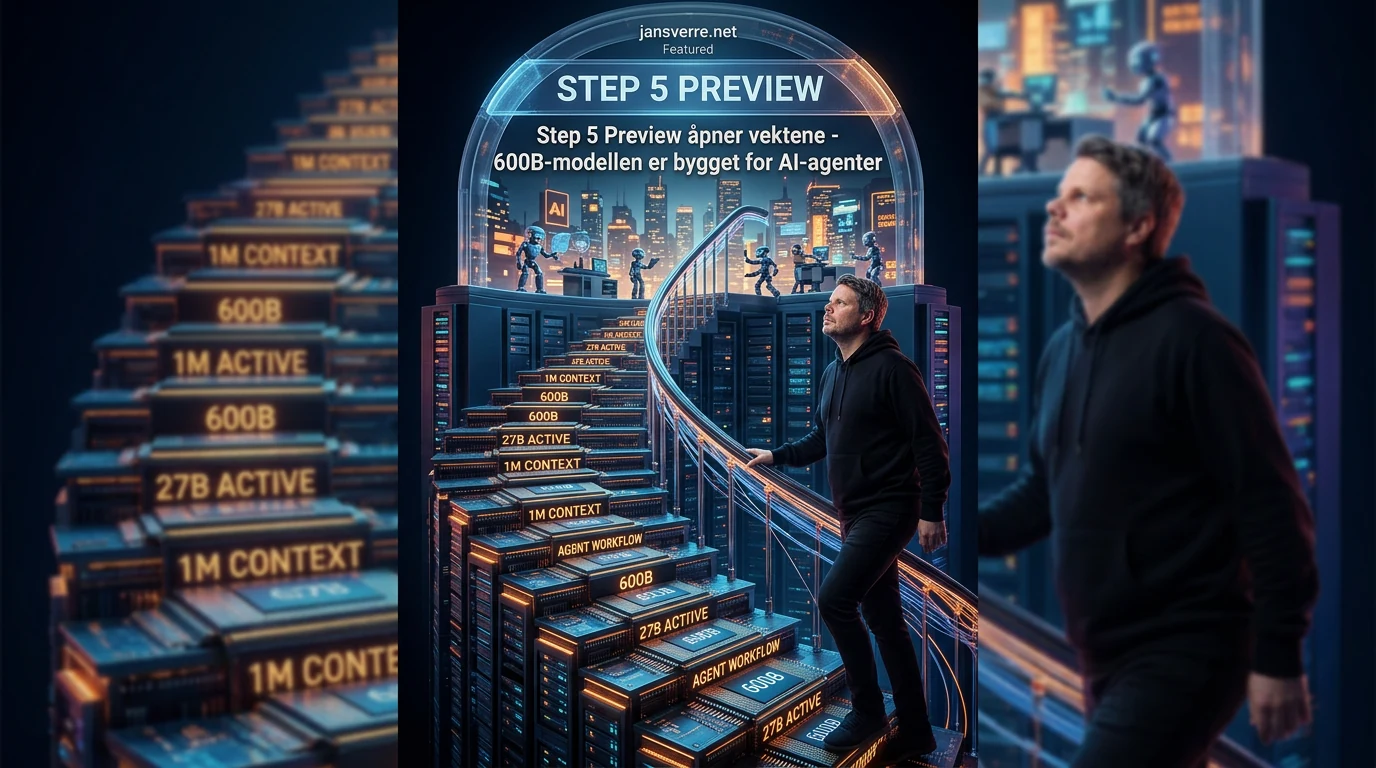
Hvis du følger åpne AI-modeller for koding og agentarbeid, er Step 5 Preview en lansering det er verdt å få med seg. StepFun har nå publisert modellvektene til en Mixture-of-Experts-modell med 600 milliarder parametere, 27 milliarder aktive parametere per token og opptil 1 million tokens kontekst.
Modellen ble først tilgjengelig gjennom StepFuns produkter og API i september. Selskapet lovet samtidig at vektene skulle komme 15. oktober, og nå ligger både FP8- og BF16-versjonene på Hugging Face. Det gjør Step 5 Preview mulig å kjøre på egen infrastruktur, men «lokalt» betyr her et rack med svært kostbare datasenterkort. Dette er ikke en modell du laster inn på en vanlig spill-PC mens kaffen blir kald.
Det mest interessante er derfor ikke bare størrelsen. StepFun har bygd modellen for lange oppgaver der en agent må lese store mengder materiale, bruke verktøy, kontrollere resultatet og rette egne feil over mange steg. Ambisjonen er høy. Samtidig bør ingen blande publiserte vekter, lovende testresultater og dokumentert pålitelighet i praktisk arbeid. Det er tre forskjellige ting.
Hva er Step 5 Preview?
Step 5 Preview er StepFuns nye flaggskipmodell for agentarbeid. Den offisielle presentasjonen av Step 5 Preview beskriver en modell for programvareutvikling, profesjonelt kunnskapsarbeid og finans, med støtte for tekst og bilder som input og tekst som output.
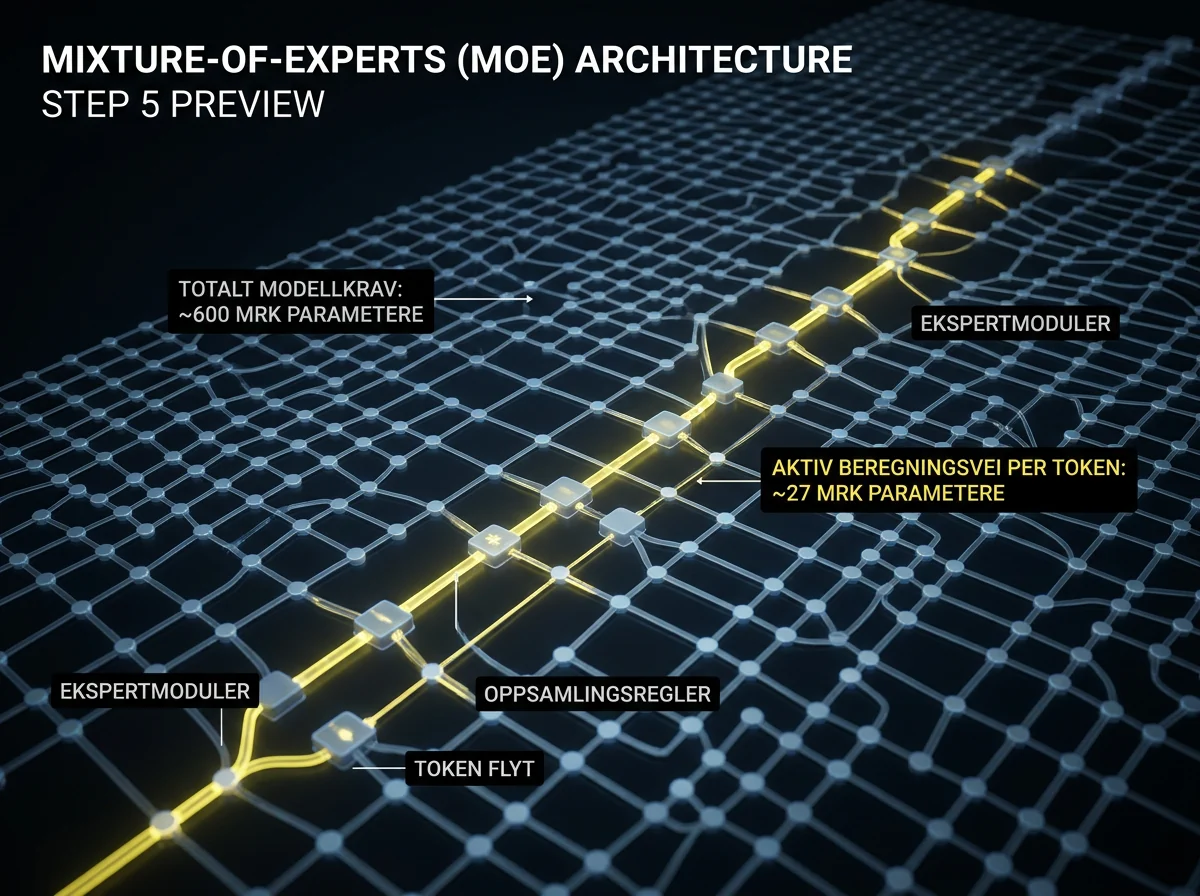
Arkitekturen er en sparsom Mixture-of-Experts, ofte forkortet MoE. Modellen inneholder totalt 600 milliarder parametere, men bruker rundt 27 milliarder for hvert token den behandler. Tanken er å få tilgang til mye samlet kapasitet uten at alle delene av modellen må gjøre arbeid hele tiden.
Det betyr ikke at Step 5 Preview kan lastes og kjøres som en vanlig 27B-modell. Alle de 600 milliardene må fortsatt lagres, og infrastrukturen må ha plass til vekter, hurtigbuffer og resten av kjøringen. «27B aktive» beskriver beregningen per token. Det beskriver ikke hvor liten nedlastingen eller minnebruken er.
Hvorfor betyr 1 million tokens noe for agenter?
Et kontekstvindu på opptil 1 million tokens gir en agent rom til store kodebaser, lange dokumenter, skjermbilder og historikken fra en omfattende arbeidsøkt. Ifølge det offisielle modellkortet på Hugging Face er maksimal output også oppgitt til opptil 1 million tokens, innenfor den samlede grensen for input og output.
For agentarbeid er dette mer enn en konkurranse om et stort tall på modellkortet. En agent som undersøker en kodebase må holde rede på filer, tidligere verktøykall, testresultater og endringer den allerede har gjort. En finansagent kan måtte koble tabeller, rapporter, forutsetninger og kilder sammen uten å miste tråden halvveis.
Men lang kontekst er bare nyttig når modellen faktisk finner og bruker riktig informasjon. StepFun sier at modellen kan utføre gjentatte verktøykall, kontrollere kjøring og revidere resultatet over lange forløp. Det er leverandørens beskrivelse, ikke min egen test. Jeg har ikke kjørt Step 5 Preview gjennom en lang kodeoppgave, og denne artikkelen skal ikke late som noe annet.
Det er også en praktisk hake: 1 million tokens krever betydelig plass til KV-cache. StepFun presiserer selv at de oppgitte maskinoppsettene ikke garanterer at hele kontekstvinduet får plass. Brukbar kontekst og samtidighet varierer med presisjon, rammeverk og hvor mye minne som er satt av til cache.
Hva kan modellen gjøre i praksis?
StepFun retter modellen mot kodearbeid på tvers av et helt repository, frontend-utvikling, bruk av verktøy og analyser av store dokumentmengder. Modellen skal kunne navigere mellom filer, gjennomføre endringer, kjøre kode, undersøke resultatet og prøve på nytt når noe ikke virker.
Det er akkurat den typen arbeid som skiller en nyttig agentmodell fra en chatbot som er flink til å forklare kode i ett svar. En agent må ikke bare foreslå neste steg. Den må tåle at virkeligheten svarer med en feilmelding, forstå hva som gikk galt og fortsette uten at et menneske må holde den i hånden for hvert verktøykall.
StepFun fremhever også finans. Modellen er laget for oppgaver som krever innhenting og kontroll av fersk informasjon, sammenligning av rapporteringsperioder og bygging av analyser der kilder og forutsetninger kan spores. Det er et fornuftig mål, men interne finansmålinger bør ikke behandles som et bevis på at modellen kan få ansvar for økonomiske beslutninger.
Uavhengige målinger gir i det minste et holdepunkt utenfor StepFuns egne figurer. Artificial Analysis målte Step 5 Preview til 44 poeng på sin Intelligence Index og 89,3 tokens i sekundet via StepFuns API. Modellen brukte også uvanlig mange output-tokens i evalueringen. Den ser altså både sterk og rask ut, men den kan være pratsom – og lange resonnementer koster tid og penger selv når prisen per token er lav.
Kan Step 5 Preview kjøres lokalt?
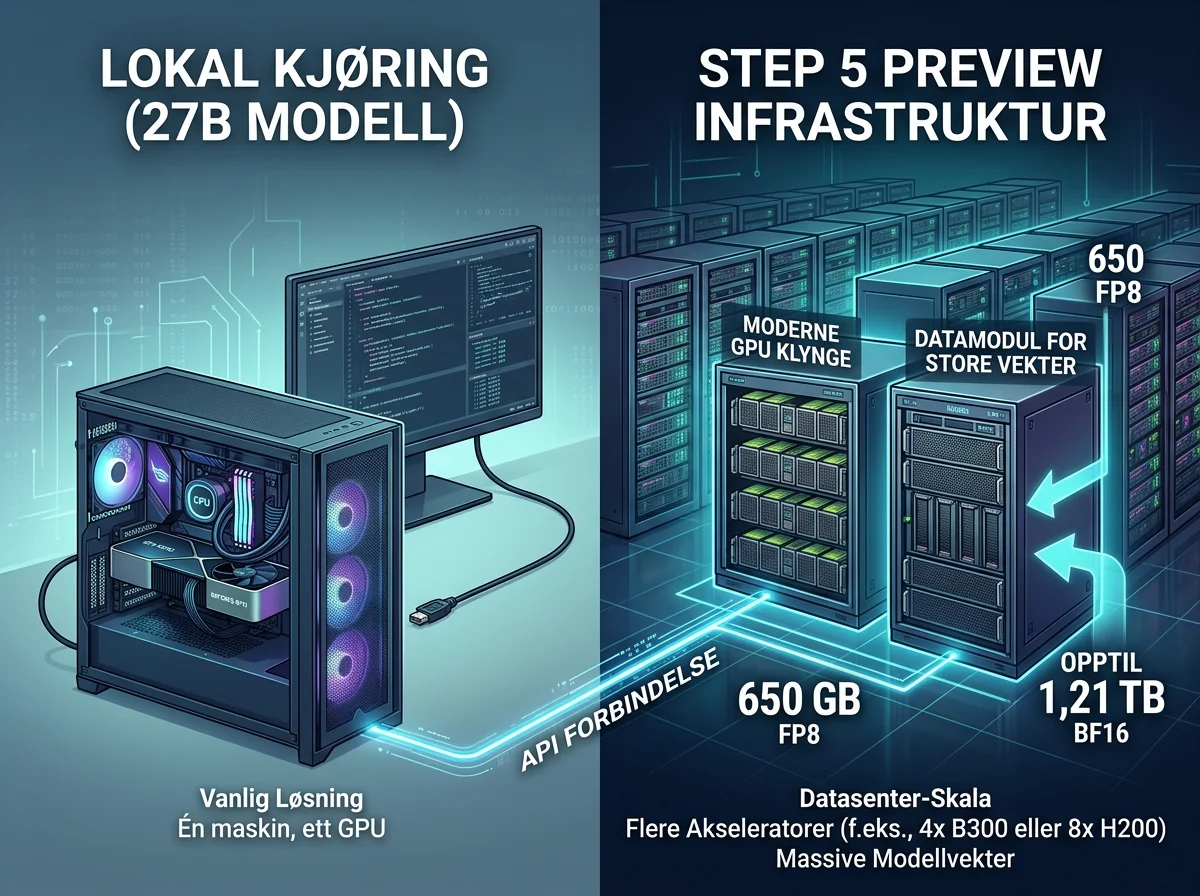
Ja, i betydningen at vektene kan lastes ned og kjøres på egen infrastruktur. Nei, hvis du med «lokalt» mener en kraftig PC under skrivebordet. FP8-pakken på Hugging Face er omtrent 650 GB, mens BF16-pakken er rundt 1,21 TB før du har tatt høyde for resten av kjøringen.
StepFuns anbefalte oppsett gjør størrelsesordenen tydelig. FP8 med vLLM eller SGLang er dokumentert på fire Nvidia B300-kort eller åtte H200-kort. BF16-oppsettet bruker åtte B300-kort eller 16 H200-kort fordelt på to noder. Selv en RTX 4090 med 24 GB minne er i en helt annen klasse enn dette behovet.
MoE-arkitekturen hjelper på beregningskostnaden fordi bare 27 milliarder parametere aktiveres per token. Den fjerner ikke behovet for å ha ekspertene tilgjengelige. Det er forskjellen mange overskrifter om store MoE-modeller hopper lett over: aktiv parameterstørrelse sier noe viktig om arbeidet, mens total størrelse fortsatt slår inn når modellen skal lagres og lastes.
For de fleste utviklere vil API derfor være den realistiske inngangen. StepFun tilbyr et OpenAI-kompatibelt endepunkt, og modellen er også tilgjengelig via OpenRouter. Egen kjøring kan eksponeres på samme måte gjennom vLLM eller SGLang. Det gjør Step 5 Preview enklere å koble til eksisterende verktøy, men kompatibelt API betyr ikke at verktøykall og resonnering oppfører seg identisk med andre modeller.
Er dette en åpen modell?
Vektene er offentlig tilgjengelige, men Step 5 Preview bruker StepFun Model License 1.0 og ikke Apache 2.0. Lisensen gir brede rettigheter til å bruke, endre og distribuere modellen, men legger på egne krav til navngivelse og enkelte former for kommersiell bruk.
Det er særlig relevant for store tjenester som tilbyr modellen videre som Model as a Service, og for produsenter som bygger modellfunksjonene inn i maskinvare for sluttbrukere. Slike aktører kan måtte inngå en egen kommersiell avtale. Den fullstendige StepFun-lisensen må derfor leses før modellen blir del av et kommersielt produkt.
Jeg ville kalt dette åpne vekter med en egendefinert lisens, ikke ubetinget open source. Det er ikke ordkløveri. Muligheten til å laste ned modellen er verdifull, men retten til å bruke den akkurat som du vil er en egen sak.
Hvor sterke er resultatene?
StepFun presenterer sterke resultater innen programvareutvikling, langvarige agentoppgaver og profesjonelt kunnskapsarbeid. Modellkortet oppgir blant annet 67,7 på DeepSWE v1.1 med høy resonneringsinnstilling. Det plasserer modellen tett på andre ledende modeller i selskapets sammenligning.
Dette er nyttig som et første signal, ikke som fasiten på hvor godt modellen arbeider i din kodebase. Resultatene påvirkes av verktøyoppsett, resonneringsnivå, temperatur og hvor mye modellen får lov til å prøve. StepFun anbefaler selv temperature=1.0 og top_p=0.95 for de publiserte evalueringene.
En million tokens og gode kodepoeng kan heller ikke dokumentere at modellen fullfører lange oppgaver uten tilsyn. Det er nettopp stabilitet over tid som er den vanskelige delen av agentarbeid. Jeg ville testet den på en faktisk oppgave med klare akseptansekriterier, logget alle verktøykall og kontrollert om sluttresultatet virker – ikke bare om modellen produserer et overbevisende resonnement.
Step 5 Preview føyer seg samtidig inn i en tydelig utvikling blant kinesiske modeller. StepFun har tidligere vist at selskapet kan presse mye kapasitet ut av en langt mindre aktiv modell. Jeg skrev om det da Step 3.5 Flash utfordret DeepSeek og GLM. Step 5 Preview flytter innsatsen fra en rask modell til et langt tyngre flaggskip for agenter.
Hvem er modellen aktuell for?
Step 5 Preview er mest aktuell for utviklere og virksomheter som allerede bygger agentbaserte arbeidsflyter og trenger lang kontekst, verktøykall eller multimodal analyse. Den kan også være relevant for forskere som vil undersøke en svært stor MoE-modell med tilgjengelige vekter og mulighet for egen drift.
For en vanlig lokalmodell-bruker er dette først og fremst en API-modell. Har du ikke tilgang til minst fire B300- eller åtte H200-kort, er den offisielle FP8-konfigurasjonen utenfor rekkevidde. Kvantiseringer fra miljøet kan senke terskelen senere, men de må vurderes på egne premisser. En mindre fil er ikke automatisk samme kvalitet, fart eller støttede kontekst.
For profesjonell bruk ville jeg kontrollert tre ting før modellen får en viktig jobb: kvalitet på egne oppgaver, faktisk kostnad når resonneringen blir lang og lisensvilkårene for måten modellen skal tilbys på. Og hvis hele poenget er selvstendig agentarbeid, må testen vare lenge nok til at modellen rekker å gjøre feil. En pen første respons sier nesten ingenting om hvor stabil den er etter 40 verktøykall.
Dette er likevel et spennende slipp. StepFun har faktisk levert vektene på datoen selskapet lovet, sammen med oppsett for vLLM, SGLang og offline kjøring. Step 5 Preview gir utviklere noe konkret å undersøke. Nå må modellen bevise at kombinasjonen av 27 milliarder aktive parametere, 1 million tokens og agentfokus holder når den møter virkelige prosjekter – ikke bare en resultattabell.
Ofte stilte spørsmål
Hvor stor er Step 5 Preview?
Step 5 Preview har 600 milliarder parametere totalt og aktiverer rundt 27 milliarder per token. FP8-vektene er omtrent 650 GB, mens BF16-versjonen er rundt 1,21 TB. Aktiv parameterstørrelse betyr derfor ikke at modellen kan lagres som en vanlig 27B-modell.
Kan Step 5 Preview kjøre på en RTX 4090?
Ikke med de offisielle FP8- eller BF16-oppsettene. StepFun dokumenterer minst fire B300- eller åtte H200-kort for FP8. En RTX 4090 har 24 GB minne og er langt unna behovet for hele den publiserte modellen.
Er Step 5 Preview gratis å bruke kommersielt?
Lisensen gir brede, vederlagsfrie rettigheter, men har egne vilkår for blant annet store MaaS-aktører og maskinvareprodusenter. Vektene er åpne, men lisensen er ikke vanlig Apache 2.0. Les vilkårene før modellen brukes i et kommersielt produkt.
Er Step 5 Preview bedre enn Claude eller GPT?
Det kan ikke fastslås generelt fra de publiserte testene. StepFun og Artificial Analysis viser sterke resultater, men kvaliteten avhenger av oppgaven, verktøyene og hvor lenge agenten må arbeide. En representativ test på egne oppgaver er mer nyttig enn én samlet benchmarkplassering.