Innhold Vis
Edge0-145B gjør det mulig å kjøre en agentmodell med 145 milliarder parametere lokalt på én kraftig PC. På en RTX 4090 oppgir utviklerne 69,9 tokens i sekundet i chat og 91,7 tokens i sekundet i agentmodus. På papiret er dette en lokal AI-milepæl, og tallene får meg til å sperre opp øynene.
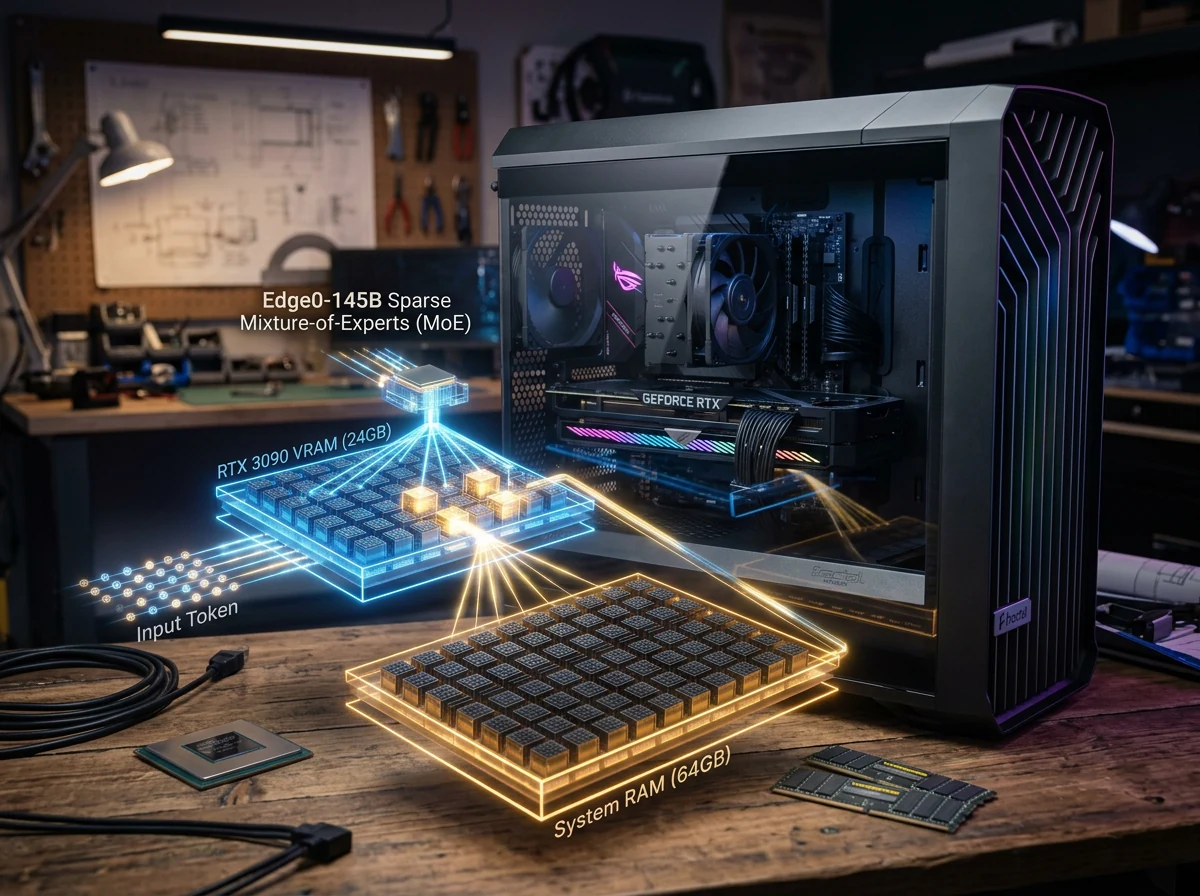
Trikset er at hele modellen ikke må ligge i videominnet samtidig. Edge0 kombinerer VRAM, systemminne og en sparsom Mixture-of-Experts-arkitektur der bare en liten del av modellen jobber med hvert token. Dermed kan en modellfil på over 40 GiB kjøres på et skjermkort med 24 GiB VRAM.
Dette er akkurat den retningen jeg vil se mer av: kraftige AI-agenter som kan arbeide lokalt, bruke verktøy og holde dataene på din egen maskin. Men «frontier» er fortsatt utviklernes egen merkelapp, ytelsen er målt av Edge0, og selskapets lansering har noen praktiske haker. De hakene gjør ikke modellen mindre spennende. De avgjør bare hvem som faktisk bør laste den ned i dag.
Hva er Edge0-145B?
Edge0-145B er en lokal agentmodell med 145 milliarder parametere, 10,12 milliarder aktive parametere per token og en kontekstmengde på 256 000 tokens. Modellen er avledet fra Qwen3.8-Flash-Next og kommer i formatene Q3_K og NVFP4, ifølge det offisielle modellkortet på Hugging Face.
«Aktive parametere» er nøkkelen. Dette er en sparsom Mixture-of-Experts-modell med 512 eksperter i hvert lag. For hvert token velger ruteren 10 eksperter, mens én felles ekspert også er aktiv. Du laster altså ned en enorm modell, men maskinen regner ikke gjennom alle 145 milliarder parameterne for hvert eneste ord.
Modellen er laget for mer enn spørsmål og svar. Edge0 viser arbeidsflyter der den planlegger, skriver og kjører kode, oppdager feil og vurderer resultatet visuelt. Demonstrasjonene omfatter blant annet Blender-scener, spill, videoproduksjon og kretskortdesign. Dette plasserer modellen i samme spennende lokale agentkategori som Metas frontiermodell Muse Wonder, men med en helt annen maskinvarehistorie.
Hvordan kjører Edge0-145B med 24 GiB VRAM?
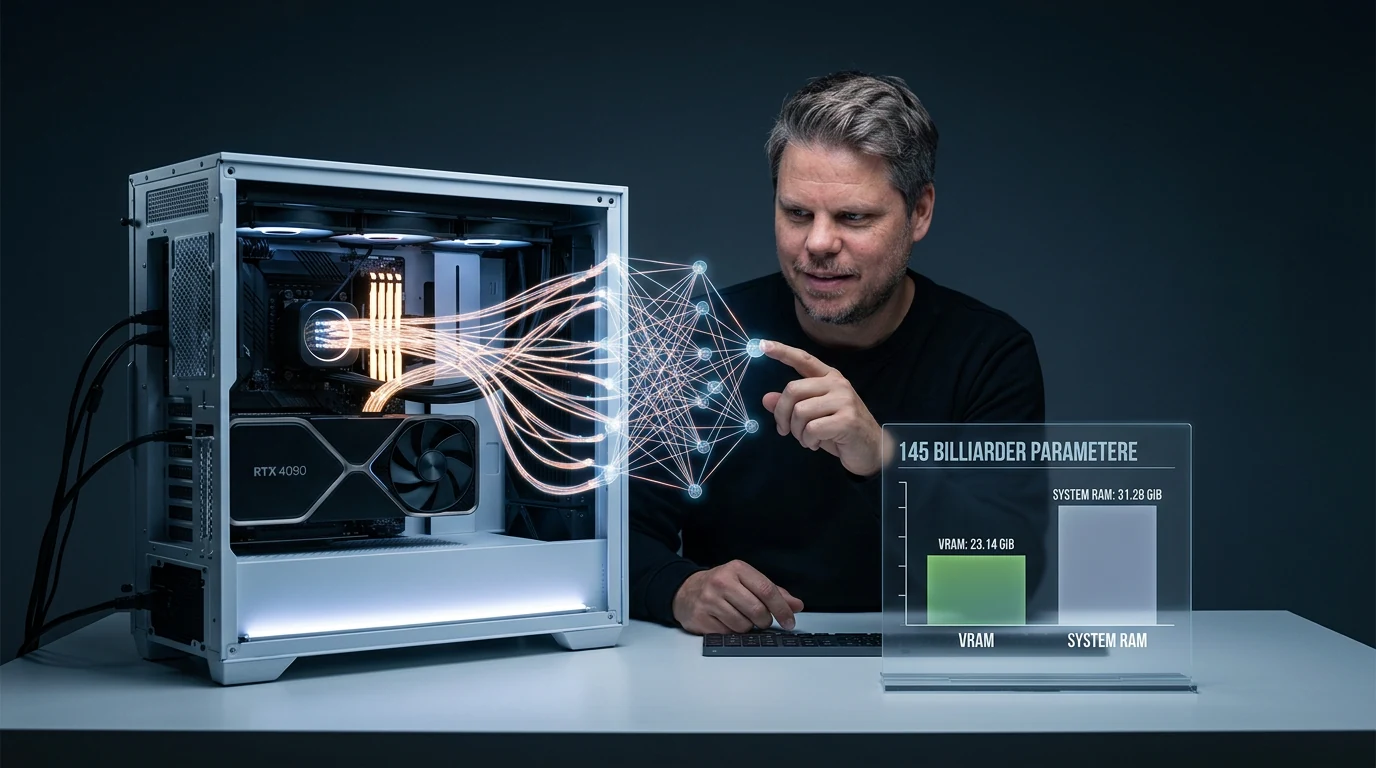
Edge0-145B får plass ved å dele arbeidet mellom GPU-minne og vanlig systemminne. Q3_K-versjonen består av 40,81 GiB modellvekter. I Edge0s måling med minneopphold aktivert brukte den 23,14 GiB VRAM og 31,28 GiB RAM. Tallene kan ikke summeres som om de var to kopier av de samme dataene; ulike ekspertsett ligger i de to minnenivåene.
Arkitekturen komprimerer inngangen til ekspertene til en latent bredde på 1792, samtidig som oppmerksomhetsdelen beholder full bredde. De 512 ekspertene er små, faste blokker som motoren kan flytte mellom systemminnet og skjermkortet etter behov. En egen MTP-modell på 1,26 milliarder parametere foreslår flere tokens framover, slik at spekulativ dekoding kan få mer arbeid ut av hver innlasting.
Det er denne helheten som betyr noe. «145B på én GPU» høres først ut som om hele modellen magisk er presset inn i 24 GiB VRAM. Det er ikke det som skjer. Maskinen bruker både skjermkort og systemminne, og motoren sørger for at de riktige ekspertene er tilgjengelige når de trengs. Smart programvare og en modell bygget for lokal kjøring gjør jobben sammen.
Edge0 har også testet en stram ramme på 16 GiB VRAM og 20 GiB RAM. Da sank chatfarten til 36,8 tokens i sekundet og agentfarten til 44,9. Det viser at 24 GiB skjermkort ikke er en absolutt nedre grense i deres testoppsett, men det er ikke det samme som en garanti for at enhver 16 GiB GPU fungerer. Målingen ble gjort ved å begrense en RTX 5090 D med cgroups.
Hvor rask er Edge0-145B på en RTX 4090?
På RTX 4090 med 24 GiB VRAM rapporterer Edge0 2 042 tokens i sekundet for prefill med 4 000 tokens, 3 179,4 med 16 000 tokens, 69,9 tokens i sekundet i chat og 91,7 i agentmodus. Prosjektets GitHub-dokumentasjon viser også 99,7 tokens i sekundet i chat og 121,2 i agentmodus på en RTX 5090 D.
Prefill er farten når modellen leser inn teksten før den begynner å svare. Dekodingsfarten er det du merker mens svaret skrives. Nesten 70 tokens i sekundet i chat på en 4090 er derfor langt mer enn et teknisk kuriosum. Hvis målingen holder i vanlige oppgaver, er modellen rask nok til at lokal kjøring ikke føles som venting på en stor servermodell som har gått seg bort i kjelleren.
Men dette er leverandørens egne resultater på et bestemt bygg. Lagringshastighet, RAM-kapasitet, minnebåndbredde, operativsystem, promptlengde og hvor mange eksperter som får bli i VRAM, kan endre resultatet. Jeg har ikke testet Edge0-145B selv. Derfor omtaler jeg disse tallene som Edge0s målinger, ikke som en egen bekreftelse.
For Apple-maskiner viser modellkortet 60,9 tokens i sekundet i chat på en M2 Ultra. Samtidig sier den oppdaterte dokumentasjonen at dette er en Metal-måling, ikke dokumentasjon på at 145B-utgaven er tilgjengelig for macOS nå. Byggeinstruksjonene for dagens utgave gjelder NVIDIA med CUDA 13 på Linux eller Windows. Det er en viktig forskjell mellom en måling og en støttet utgivelse.
Er modellen virkelig på nivå med de beste skymodellene?
Edge0-145B ser sterk ut i Edge0s egne tester, særlig på kode- og agentarbeid. Det mest konkrete tallet er 86,5 på Terminal-Bench 2.1, der modellen ligger foran både Qwen3.8-Flash-Next og Claude Opus 4.6 Max i Edge0s tabell.
Det er lovende, men benchmarktabellen er ikke et frikort til å erklære modellen best. Edge0 opplyser selv at resultatene for Edge0, Qwen, DeepSeek og Claude kommer fra selskapets interne evalueringer. Modellen vinner heller ikke alt: Qwen3.8-Flash-Next ligger foran på GPQA-Diamond og IFBench, mens Claude ligger foran på Humanity’s Last Exam.
Den mer interessante påstanden er at Edge0-145B kombinerer høy kapasitet med et minneoppsett som gjør lokal bruk realistisk. Sammenligningen mot Qwen og DeepSeek bruker derimot estimerte minnetall for standard 4-biters kjøring. Her blandes altså målte og beregnede verdier, og det bør stå med liten skrift – helst så liten at den fortsatt er lesbar.
Jeg er begeistret for hva arkitekturen kan bety, ikke fordi én benchmarktabell har kåret en vinner. Den virkelige prøven er om modellen kan fullføre lange kode- og agentoppgaver på en vanlig kraftig arbeidsstasjon uten at kvaliteten faller sammen eller minnesystemet blir en flaskehals.
Hva trenger du for å kjøre Edge0-145B?
Dagens dokumenterte hovedløp krever Linux eller Windows, en NVIDIA-GPU og CUDA 13. Modellmappen kjøres gjennom Edge0s egen edge0-strata-motor via edge0-infer. Q3_K-versjonen er 40,81 GiB, så du trenger også nok rask lagring og systemminne til å håndtere vektene og ekspertene som ikke ligger i VRAM.
Etter at motoren og edge0-infer er bygget, startes modellen med edge0-infer serve eller edge0-infer chat. Servermodusen eksponerer både OpenAI- og Anthropic-kompatible endepunkter lokalt. Det gjør modellen langt enklere å koble til eksisterende verktøy enn om hvert prosjekt måtte lære et eget, eksotisk API.
Windows-brukere kan også bruke Edge0 Chat og velge modellmappen i et grafisk grensesnitt. Dokumentasjonen er imidlertid fersk og har allerede blitt strammet inn rundt plattformstøtte. Jeg ville behandlet dette som en utgivelse for tekniske brukere ennå, ikke som en problemfri ettklikksmodell for alle med en gaming-PC.
Har du riktig maskin, bør du teste med oppgaver der du kjenner fasiten: en faktisk kodebase, en feil modellen må finne, eller en agentjobb som krever flere verktøykall. Mål tid til ferdig resultat, hvor ofte du må gripe inn, RAM- og VRAM-bruk og om modellen holder retningen over lange oppgaver. Tokens i sekundet er fint. Ferdig arbeid er bedre.
Åpen kildekode har en lisenshake
Inferensrammeverket er åpen kildekode under Apache 2.0, mens Strata-delen beholder MIT-lisensen. Modellvektene har andre vilkår. Edge0s egne modellbidrag ligger under Edge0 Community Model License 1.0, og Qwen-delene beholder Qwen Community License 1.0.
Edge0-lisensen tillater personlig bruk, forskning, endringer, ikke-kommersiell deling, intern bruk og kommersiell bruk av modellens resultater. Skal du selge eller kommersielt distribuere modellen, drive en betalt modelltjeneste eller tilby en selvstendig kommersiell kode- eller kontorassistent, kreves en egen skriftlig avtale med Edge0. Qwens vilkår gjelder i tillegg.
Jeg ville derfor omtalt Edge0-145B som en modell med tilgjengelige vekter, ikke som friksjonsfri open source for alle kommersielle formål. Det er fortsatt verdifullt å kunne laste ned, undersøke og kjøre modellen lokalt. Men en bedrift som bygger et produkt på toppen av den, må lese begge lisensene før utviklingen løper av gårde.
Hvorfor Edge0-145B er en milepæl for lokal AI
Edge0-145B flytter grensen for hva én kraftig arbeidsstasjon kan gjøre. En RTX 4090 er dyr maskinvare, men det er fortsatt et forbrukerkort du kan ha i én PC. At en 145B-modell kan levere brukbar fart på den, er noe helt annet enn en lokal demonstrasjon som krever en stabel datasenterkort.
Det minner om utviklingen rundt Perplexitys lokale agentmaskin på NVIDIA DGX Spark: stadig mer av agentens arbeid kan flyttes fra en lukket skytjeneste til maskinvare du selv kontrollerer. Forskjellen her er at Edge0 også retter seg mot utbredte forbrukerkort.
Jeg ville ikke kjøpt ny maskinvare bare på grunnlag av lanseringstallene. Jeg ville heller ikke avfeid dette som enda en modell med et stort tall i navnet. Har du en 4090 eller 5090, nok RAM og lyst til å prøve lokale agenter, er Edge0-145B en av de mest spennende modellene å måle på egne oppgaver akkurat nå.
På papiret er dette allerede en lokal AI-milepæl. Hvis uavhengige tester bekrefter kombinasjonen av agentkvalitet, fart og minnebruk, har Edge0 også gjort en modell i denne størrelsesklassen praktisk relevant for folk som eier én PC. Det er lokal AI slik jeg liker den – ikke bare privat og offline, men kraftig nok til å gjøre ordentlig arbeid.
Ofte stilte spørsmål
Kan Edge0-145B kjøre på en RTX 4090?
Ja. Edge0 oppgir 69,9 tokens i sekundet i chat og 91,7 i agentmodus på RTX 4090 med 24 GiB VRAM. Modellen bruker også systemminne, så skjermkortet er ikke hele maskinvarekravet. Resultatene er leverandørmålinger og kan variere med oppsettet.
Hvor mye RAM trenger Edge0-145B?
Det finnes ikke ett enkelt offisielt minimum for alle maskiner. I en Q3_K-måling brukte Edge0 23,14 GiB VRAM og 31,28 GiB systemminne. En begrenset test med 16 GiB VRAM og 20 GiB RAM fungerte også, men ble kjørt på en strupet RTX 5090 D.
Fungerer Edge0-145B på Mac?
Edge0 har målt Q3_K-utgaven på en Apple M2 Ultra med Metal, men prosjektet presiserer at målingen ikke dokumenterer tilgjengelig macOS-støtte. De publiserte byggeinstruksjonene for 145B-utgaven gjelder foreløpig NVIDIA med CUDA 13 på Linux eller Windows.
Kan Edge0-145B brukes kommersielt?
Intern bruk og kommersiell bruk av genererte resultater er tillatt, men betalte modelltjenester, kommersiell modelldistribusjon og selvstendige kommersielle kode- eller kontorassistenter krever skriftlig tillatelse fra Edge0. Qwen-lisensen gjelder også, så begge avtalesettene må kontrolleres.