Hy-Memory-30B-A3B er en åpen spesialmodell for langtidsminne i AI-agenter. Tencent måler 55,49 mot 54,62 for Opus 5, men testen er smal.
16. oktober 2026
2 visninger
8 minutter lesetid
Nemotron 3.5 Super VL – 120B-modellen som kjører på én DGX Spark
Nemotron 3.5 Super VL er en åpen 120B multimodal agentmodell som kjører på én DGX Spark. Se hva 12B aktive parametere og NVFP4 betyr i praksis for deg.
16. oktober 2026
5 visninger
8 minutter lesetid
FLUX 3 Image Klein kjører lokalt med 8 GB VRAM
FLUX 3 Image Klein har åpne vekter, 5,6 milliarder parametere, støtte for ti referansebilder og en INT8-variant som kan kjøre med 8 GB VRAM.
16. oktober 2026
5 visninger
7 minutter lesetid
Nemotron 3.5 Bolt får 74 milliarder parametere inn i 24 GB
Nemotron 3.5 Bolt 74B-A9B pakker 74 milliarder parametere i 24 GB med 2-bit QAT. Se hvem modellen passer for, og hvorfor kvaliteten må testes grundig.
15. oktober 2026
11 visninger
6 minutter lesetid
Anthropic vil regulere hvordan du snakker til Claude – dette er ikke greit
Anthropic får nye Claude-regler 12. november 2026. De gjelder «grusom» oppførsel mot modellen. Her er hva som endres – og hvorfor dette ikke er greit.
14. oktober 2026
12 visninger
7 minutter lesetid
Decision 3.0 gir AI-agenter raske valg uten tekstgenerering
Decision 3.0 er en åpen familie av multimodale beslutningsmodeller fra 0,6B til 27B. Modellene velger, scorer og svarer ja eller nei uten å generere tekst.
12. oktober 2026
25 visninger
7 minutter lesetid
Qwen-Image-2.1-Turbo kutter bildegenereringen fra 40 til 8 steg
Qwen-Image-2.1-Turbo kutter fra 40 til 8 steg, men fem ganger færre steg er ikke det samme som fem ganger høyere fart. Her er pris, tilgang og lisens.
12. oktober 2026
28 visninger
7 minutter lesetid
Mellum2.1 er bygget for raske, lokale kodeagenter
Mellum2.1 er JetBrains’ åpne MoE-modell for kodeagenter. Den har 12 milliarder parametre, bruker 2,5 milliarder per token og kan kjøres på egen maskinvare.
9. oktober 2026
43 visninger
6 minutter lesetid
EmbeddingGemma 2 gir lokalt søk i tekst, bilder, video og lyd
EmbeddingGemma 2 er en lokal multimodal embedding-modell for tekst, kode, bilder, video og lyd. Se modellstørrelser, lokal RAG og tekniske fallgruver.
7. oktober 2026
39 visninger
6 minutter lesetid
Mistral Large 4 går for toppsjiktet – åpne vekter kommer senere
Mistral Large 4 har én million tokens kontekst og åpne vekter på vei. Se API-pris, kapasitet, maskinvarekrav og hva som må bevises i praksis før lokal drift.
7. oktober 2026
50 visninger
7 minutter lesetid
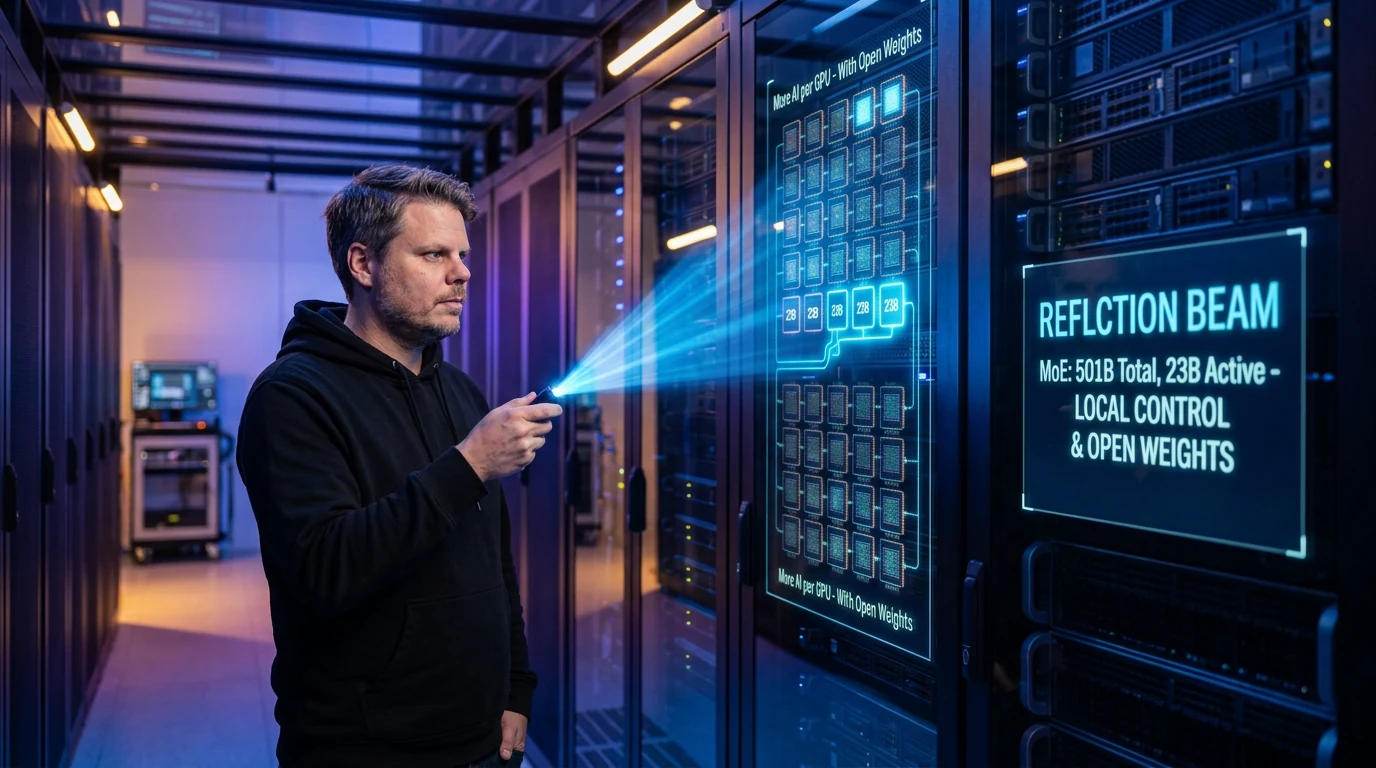
Reflection Beam lover mer AI per GPU – vektene kommer senere
Reflection Beam er en varslet open-weight-modell med 501 milliarder parametere. Den lover mer AI per GPU, lokal kontroll og lavere inferensarbeid for bedrifter.
6. oktober 2026
56 visninger
6 minutter lesetid
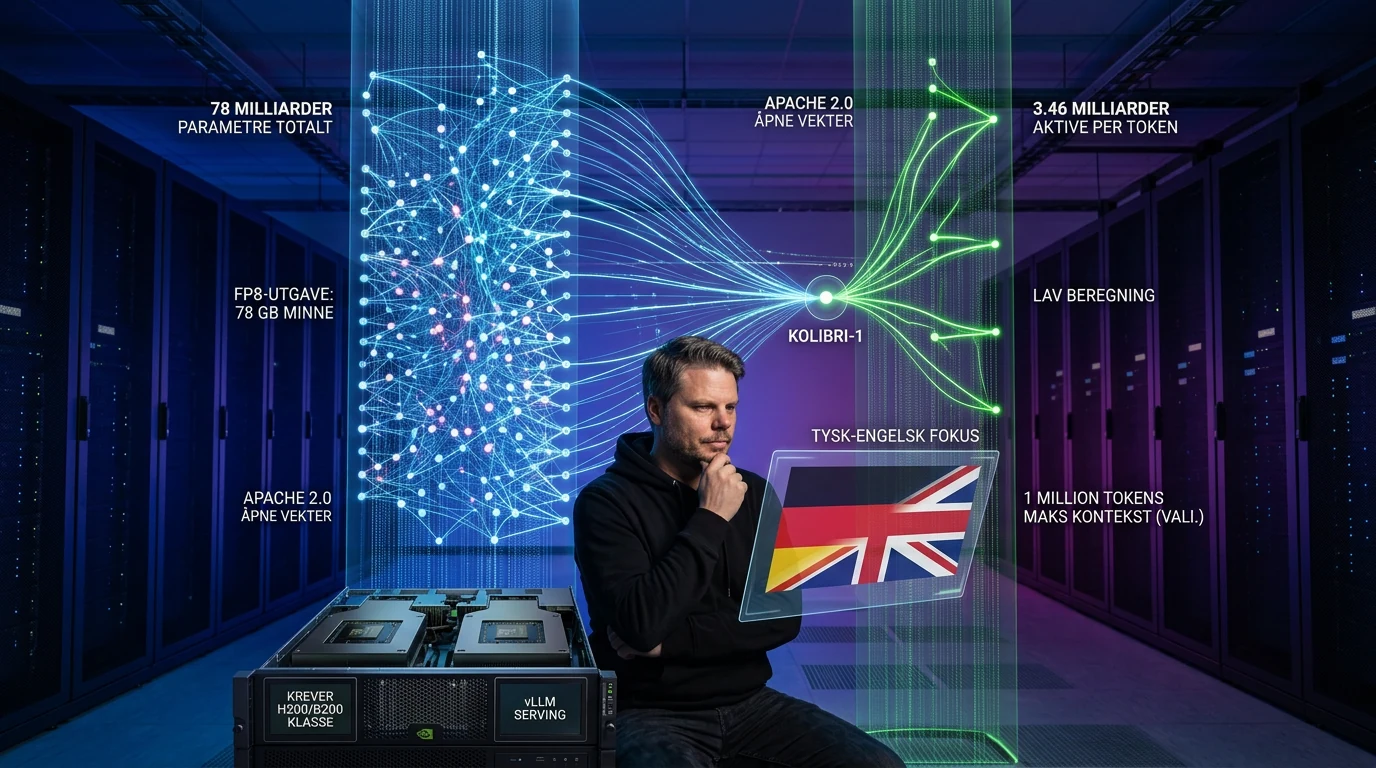
Kolibri-1 bruker 3,46 av 78 milliarder parametre per token
Kolibri-1 har 78,1 milliarder parametre, men bruker bare 3,46 milliarder per token. Se maskinvarekrav, kontekst, reasoning og åpne vekter for egen drift.
5. oktober 2026
41 visninger
7 minutter lesetid
Ming-Image-0.1-Design gjør flate design om til redigerbare lag
Ming-Image-0.1-Design kombinerer en åpen 6B-designmodell med en egen modell som deler flate design i redigerbare RGBA-lag. Lokal kjøring krever 80 GiB VRAM.
23. september 2026
66 visninger
7 minutter lesetid
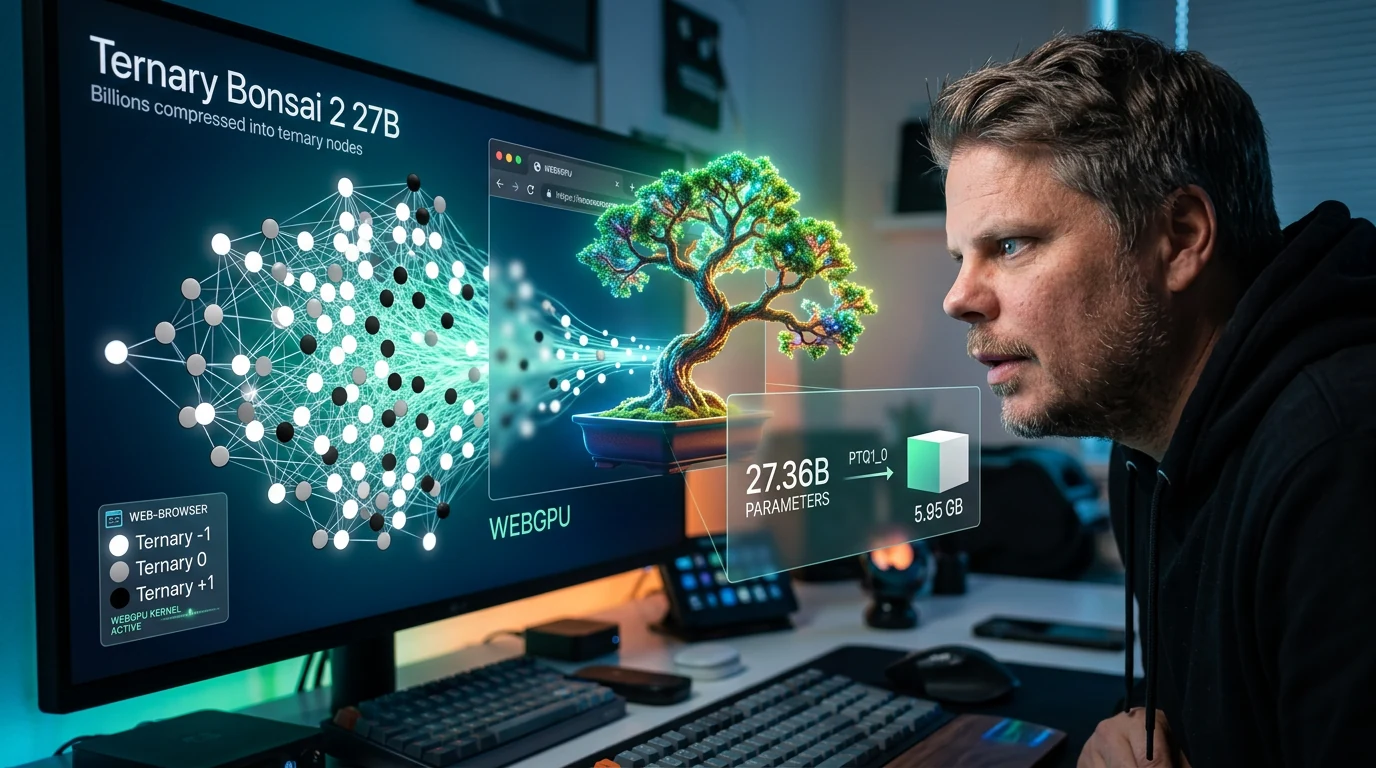
Ternary Bonsai 2 – 27B-modell på 5,95 GB i nettleseren
Ternary Bonsai 2 presser en Qwen3.8-basert 27B-modell ned til 5,95 GB. Hele modellen kan nå kjøre lokalt i nettleseren med WebGPU. Se hva som kreves her.