Innhold Vis
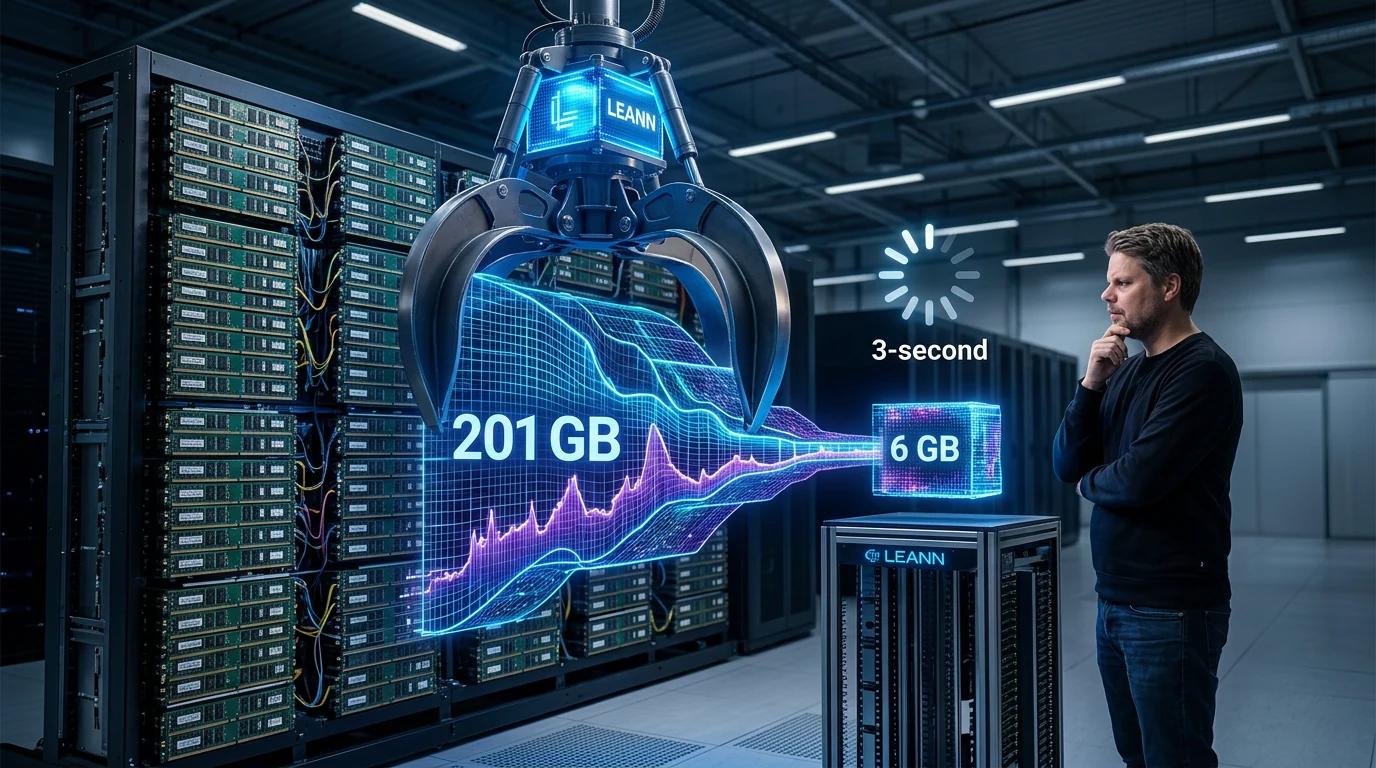
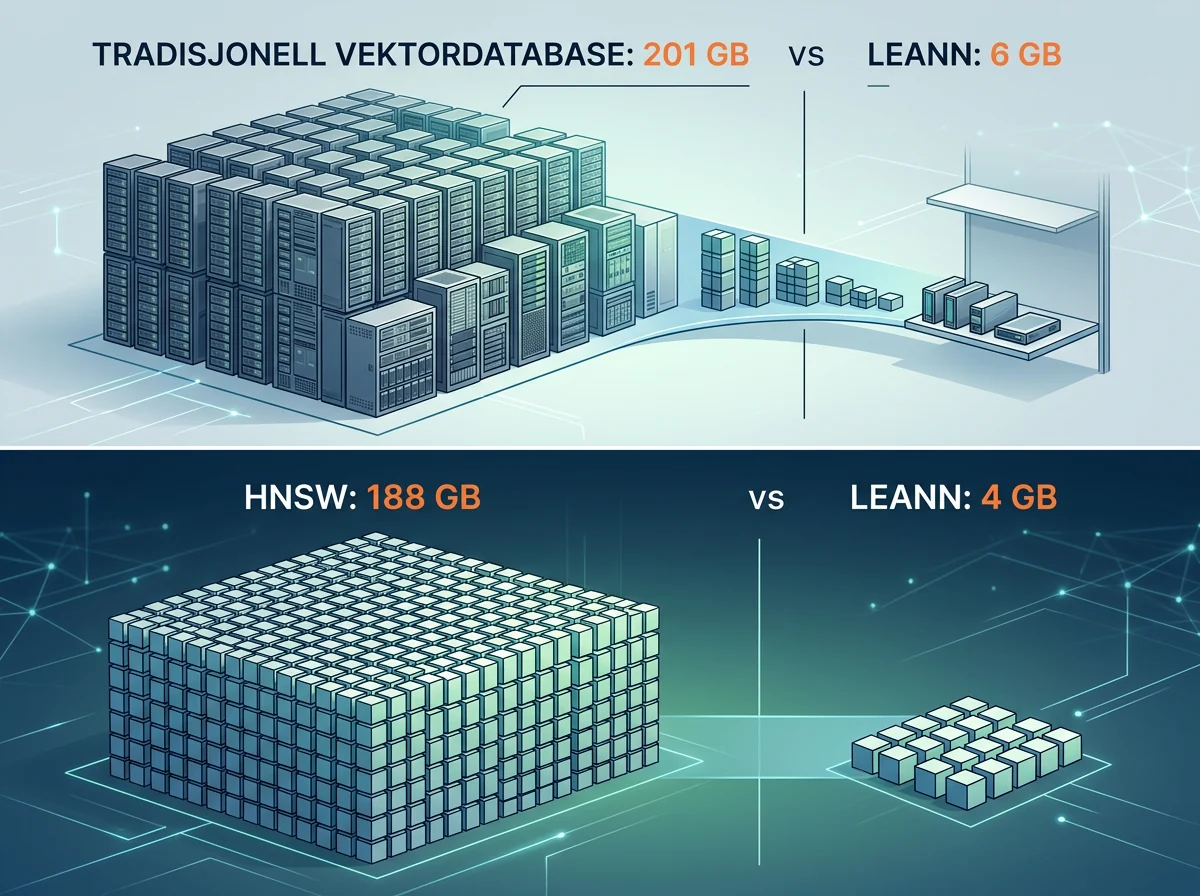
Hvis lagringsplassen stopper deg fra å kjøre en stor RAG-løsning lokalt, angriper LEANN akkurat den dyreste delen: selve vektorindeksen. I prosjektets egen måling krymper en indeks med 60 millioner tekstbiter fra 201 GB til 6 GB.
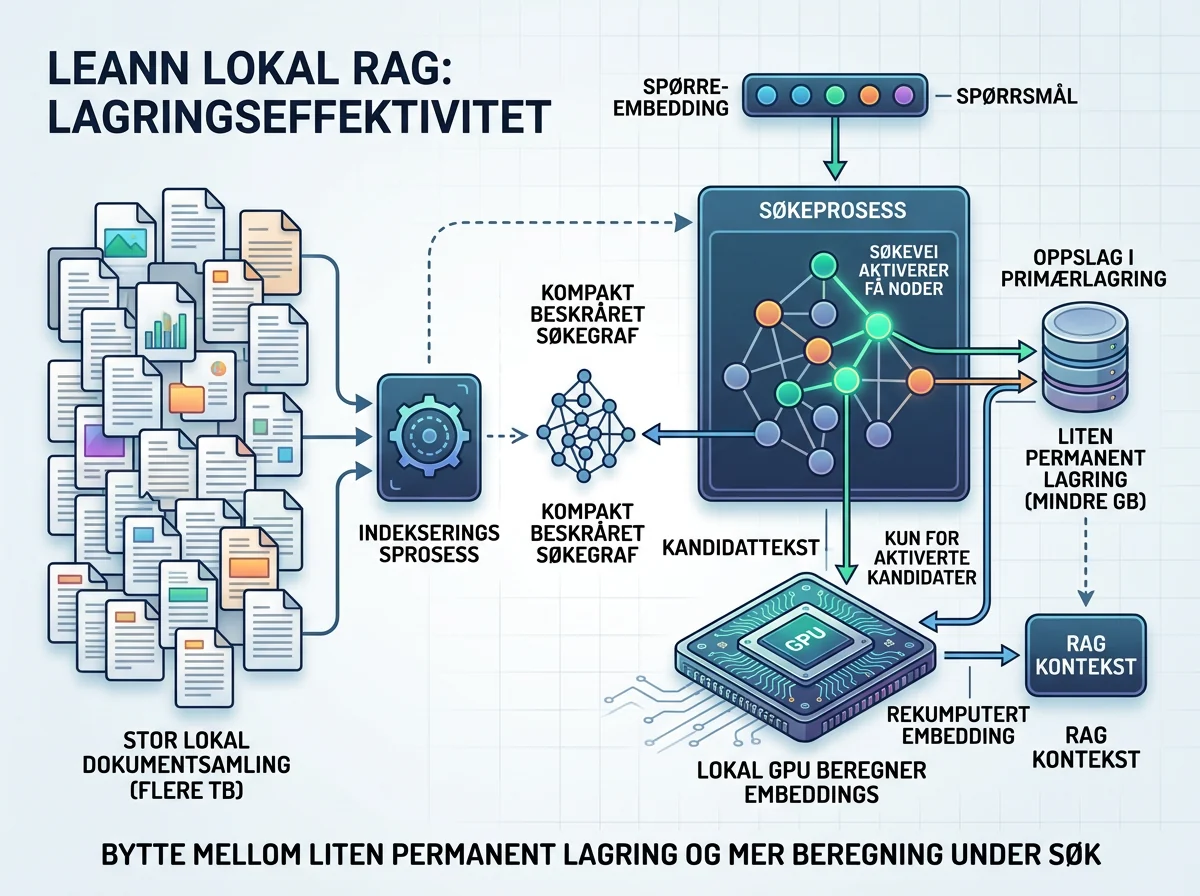
Grepet er både enkelt å forklare og teknisk ganske frekt. LEANN lagrer ikke alle embeddings etter at indeksen er bygget. I stedet beholder verktøyet en kompakt og beskåret graf, og beregner bare de embeddingene som trengs mens et søk pågår.
Du får ikke den enorme lagringsgevinsten gratis. Søket går fra hundredeler av et sekund til sekunder i forskernes målinger. For lokal RAG, personlige kunnskapsbaser og store dokumentsamlinger kan det likevel være en svært fornuftig handel: litt ventetid er bedre enn en indeks som ikke får plass på maskinen i det hele tatt.
Hva er LEANN?
LEANN er en open source-indeks for approximate nearest neighbor-søk, laget for å redusere lagringsbehovet i blant annet RAG. MLSys 2026-papiret beskriver en indeks som kan bli opptil 50 ganger mindre enn vanlige alternativer, samtidig som søkekvaliteten beholdes på et sammenlignbart nivå.
Vanlige vektorindekser lagrer en embedding for hver tekstbit, i tillegg til metadataene som gjør raske nabosøk mulig. Når datasettet vokser, kan indeksen bli langt større enn teksten den bygger på. Forskerne brukte 76 GB Wikipedia-tekst delt i 60 millioner biter på 256 tokens. Bare embeddingene tok 173 GB.
LEANN bygger først en grafbasert indeks omtrent som andre løsninger. Deretter kaster den de tette embeddingvektorene, beskjærer grafen og lagrer den kompakte strukturen. Originalteksten og embeddingmodellen må fortsatt være tilgjengelige, men den ferdige vektorindeksen trenger ikke lenger bære rundt på alle vektorene.
Fra 201 GB til 6 GB – men tallene kommer fra to målinger
Prosjektets GitHub-repo viser den mest slående sammenligningen: 60 millioner tekstbiter tar 201 GB i en tradisjonell vektordatabase og 6 GB med LEANN. Det tilsvarer en oppgitt besparelse på 97 prosent. Repoet viser også 400 000 chatmeldinger som går fra 1,8 GB til 64 MB.
Papiret bruker en litt annen oppstilling. Der sammenlignes LEANN på 4 GB med en HNSW-indeks på 188 GB for det samme Wikipedia-grunnlaget. HNSW-tallet består av rundt 173 GB embeddings og en graf på omtrent 15 GB. Begge sammenligningene dokumenterer det samme hovedpoenget, men 201 mot 6 GB og 188 mot 4 GB bør ikke blandes til én måling.
Dette er forskernes og prosjektets egne resultater, ikke min egen test eller en uavhengig reproduksjon. Tallene er likevel konkrete nok til å vise hvorfor ideen er interessant. Når en vanlig indeks krever mer enn dobbelt så mye lagring som de 76 GB med kildetekst, er det selve indeksen som har blitt problemet.
Hvordan kan LEANN søke uten å lagre alle embeddings?
LEANN utnytter at et grafbasert vektorsøk bare besøker en liten del av hele datasettet for hvert spørsmål. Verktøyet beregner embeddings på nytt for nodene langs den aktuelle søkeveien, i stedet for å hente millioner av ferdiglagde vektorer fra disken. Det flytter kostnaden fra lagring til beregning.
En lett produktkvantisert representasjon brukes først til å rangere mulige naboer. Bare de mest lovende kandidatene sendes videre til nøyaktig beregning. LEANN samler dessuten kandidater fra flere steg i søket i dynamiske batcher, slik at GPU-en får mer arbeid per kjøring og slipper å behandle én liten forespørsel om gangen.
Grafen blir også beskåret. I stedet for å kutte forbindelser likt overalt, bevarer LEANN flere kanter rundt de best tilkoblede knutepunktene. Papiret beskriver disse som hub-noder. I eksperimentene ga det et godt arbeidspunkt å la de øverste 3 til 5 prosentene beholde høyere grad. Dermed kan grafen halveres uten at de viktigste snarveiene gjennom datasettet forsvinner.
Prisen er søketid i sekunder
På Natural Questions ved 90 prosent Recall@3 brukte LEANN 2,48 sekunder på uthentingen, mens HNSW brukte 0,05 sekunder. Begge ga 25,5 prosent downstream-nøyaktighet med Qwen3-4B i målingen, men LEANN brukte 4 GB lagring mot HNSWs 188 GB. Dette er ikke en gratis komprimering. Det er et tydelig bytte mellom plass og fart.
Forskjellen varierer med oppgaven. På RTX 4090 oppga forskerne uthenting fra 1,12 sekunder på GPQA til 7,12 sekunder på HotpotQA. Selve embeddingsberegningen stod for rundt 76 prosent av søketiden, så en raskere embeddingmodell eller en bedre cache kan ha stor effekt.
Forskerne mener forsinkelsen er akseptabel når neste steg er tekst- eller bildegenerering som allerede tar mange sekunder. Det kan være riktig for en personlig dokumentassistent, men ikke nødvendigvis for autosøk, anbefalinger eller tjenester med mange samtidige brukere. Kravet ditt til svartid avgjør om 97 prosent mindre lagring er verdt prisen.
Hva betyr dette for lokal RAG?
For lokal RAG er den praktiske gevinsten at en stor semantisk indeks kan få plass på en vanlig arbeidsstasjon. I forskernes Mac-oppsett med 128 GB minne kunne verken HNSW eller IVF laste den fulle matrisen på over 171 GB. LEANN kunne kjøre fordi den slapp å holde alle embeddingene tilgjengelige.
Det åpner for søk i dokumentarkiver, e-post, chathistorikk, nettleserhistorikk og kode uten at innholdet må sendes til en ekstern vektordatabase. Repoet har ferdige eksempler for flere slike kilder og støtter blant annet Ollama, Hugging Face og OpenAI-kompatible API-er til genereringsdelen. LEANN er selve søkeindeksen, ikke språkmodellen som svarer.
Det er også en naturlig videreføring av ideen bak lokalt websøk med 203 millioner sider for RAG: store datamengder blir langt mer nyttige når søket kan bo nær dataene. LEANN løser ikke hele RAG-stakken, men reduserer en av de mest konkrete tersklene.
Hva må du ha for å kjøre LEANN?
LEANN er tilgjengelig med MIT-lisens og kan installeres fra PyPI med uv pip install leann. Repoet har bygginstruksjoner for macOS, flere Linux-varianter og Windows. HNSW er standard backend, mens DiskANN kan velges når arbeidsflyten passer bedre til diskbasert søk.
Du trenger fortsatt rådataene og embeddingmodellen som ble brukt da indeksen ble bygget. LEANN beregner nemlig kandidatene på nytt med den samme modellen under søket. Bytter du embeddingmodell, er ikke den gamle grafen automatisk et nøytralt skall som passer til den nye modellen.
Prosjektet tilbyr CPU-installasjon på Linux, men det publiserte materialet gir ikke tilsvarende CPU-tall for den store testen. De mest omtalte målingene bruker en RTX 4090-maskin med 32 GB systemminne og en M1 Ultra Mac. Ikke les GPU-resultatene som et løfte om samme responstid på en liten hjemmeserver uten akselerasjon.
Indeksbyggingen krever også at alle embeddings blir laget minst én gang før de kan kastes. LEANN reduserer altså den varige lagringen, men gjør ikke den første byggingen gratis. For et datasett med 60 millioner tekstbiter må du fortsatt planlegge tid, midlertidig kapasitet og tilgang til modellen. Gevinsten kommer når den ferdige indeksen skal lagres, flyttes, oppdateres og brukes over tid.
Når er LEANN et bedre valg enn HNSW?
LEANN passer best når lagring eller minne er den harde grensen, datasettet er stort og noen sekunders søketid er akseptabelt. Personlige kunnskapsbaser, lokale dokumentarkiver og RAG på én arbeidsstasjon er opplagte kandidater. Her kan alternativet være å redusere datasettet kraftig eller flytte hele indeksen til skyen.
HNSW er fortsatt et bedre utgangspunkt når du trenger søk på millisekundnivå, har nok minne og skal betjene mange forespørsler samtidig. LEANN fjerner ikke fysikken. Hver forespørsel utløser nytt arbeid i embeddingmodellen, og belastningen vokser når flere søker på én gang.
Jeg ville derfor vurdert LEANN ut fra den faktiske flaskehalsen, ikke ut fra ett imponerende prosenttall. Mål hvor stor den vanlige indeksen blir, hvor lang ventetid arbeidsflyten tåler, og om maskinen kan beregne embeddings raskt nok. Kjør deretter prosjektets evalueringsoppsett på egne data før en produksjonsbeslutning.
En smart retning for personlig AI
Det mest lovende med LEANN er ikke at én benchmark har fått et stort komprimeringstall. Det er at verktøyet snur et gammelt designvalg: embeddings må ikke nødvendigvis ligge ferdig på disk bare fordi de er dyre å beregne.
Når lagring er billig og svartid er alt, gir det mening å lagre vektorene. Når en personlig maskin skal søke i titalls millioner tekstbiter, kan regnestykket bli motsatt. Da er det ganske elegant å bruke GPU-en noen sekunder i stedet for å kreve nær 200 GB til indeksen.
LEANN er ikke en automatisk erstatning for HNSW, og prosjektets tall trenger reproduksjon i din egen arbeidsflyt. Men for lokal RAG løser det et reelt problem med en klar og forståelig handel: mye mindre lagring mot merkbart tregere søk. Det er en handel mange faktisk kan leve godt med.
Ofte stilte spørsmål
Er LEANN en vektordatabase?
LEANN er først og fremst en lagringseffektiv vektorindeks for semantisk søk og RAG. Repoet pakker den inn i ferdige apper og integrasjoner, men verktøyet erstatter ikke automatisk alle funksjonene i en komplett administrert vektordatabase.
Må LEANN ha en GPU?
Ikke nødvendigvis. Prosjektet tilbyr en CPU-installasjon for Linux, men de store publiserte ytelsestallene er blant annet målt på RTX 4090. Uten GPU må du regne med en annen søketid og måle den på egen maskin.
Kan LEANN brukes helt lokalt?
Ja. Indeks, embeddingmodell, kildedata og genereringsmodell kan kjøres lokalt, blant annet med Ollama eller Hugging Face. Velger du en ekstern OpenAI-kompatibel tjeneste til generering eller embeddings, er ikke hele arbeidsflyten lenger lokal.
Hvorfor er LEANN tregere enn HNSW?
LEANN sparer plass ved å ikke lagre alle ferdigberegnede embeddings. Under søket må verktøyet derfor beregne embeddings på nytt for kandidatene det besøker. HNSW kan hente lagrede vektorer direkte, men trenger til gjengjeld mye mer lagring og minne.