Innhold Vis
Hvis du vil kjøre tekst, bilde, video og lyd lokalt, er Liquid AI LFM3 en modellfamilie det er verdt å følge med på. Seks modeller rundt 2 milliarder parametere dekker ulike oppgaver uten at du må dra inn én enorm universalmodell.
Det er den praktiske ideen som gjør lanseringen spennende. LFM3-1.7B er en ren tekstmodell, mens egne varianter tar seg av syn, lyd, kombinasjonen av flere modaliteter og raske beslutninger. Alle bygger på den samme kompakte grunnmodellen, og Liquid AI sier at hver av dem kan finjusteres på én GPU.
Dette er en kildebasert nyhet, ikke min egen test. Tallene kommer i stor grad fra Liquid AI, og de må leses som leverandørens egne målinger. Likevel er retningen god: mindre modeller som er laget for bestemte jobber, kan være langt mer nyttige lokalt enn en større modell som prøver å være best til alt.
Hva er Liquid AI LFM3?
Liquid AI LFM3 er en familie med seks open-weight-modeller for tekst, bilder, video, lyd og strukturerte beslutninger. Ifølge Liquid AIs lansering 27. oktober 2026 er alle modellene bygget fra LFM3-1.7B-Base og ligger omtrent i 2B-klassen.
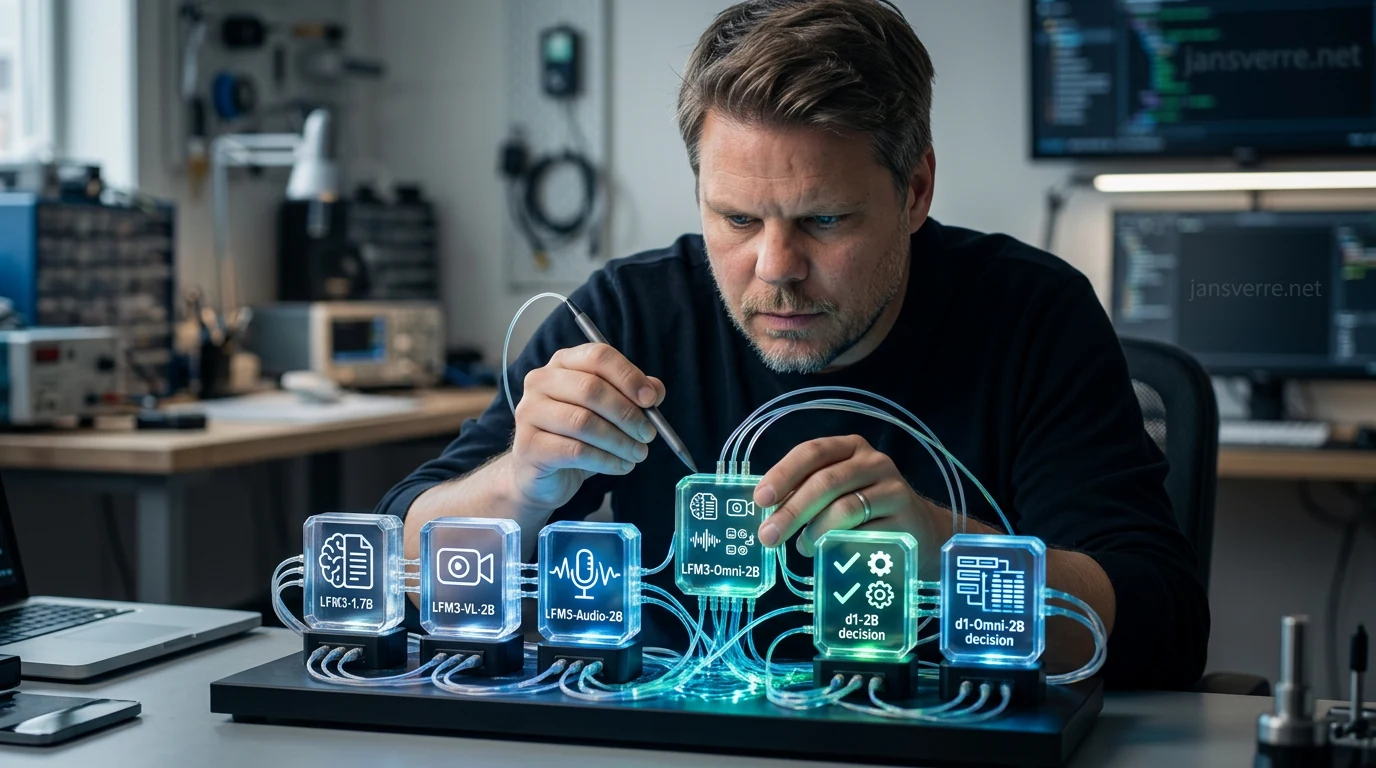
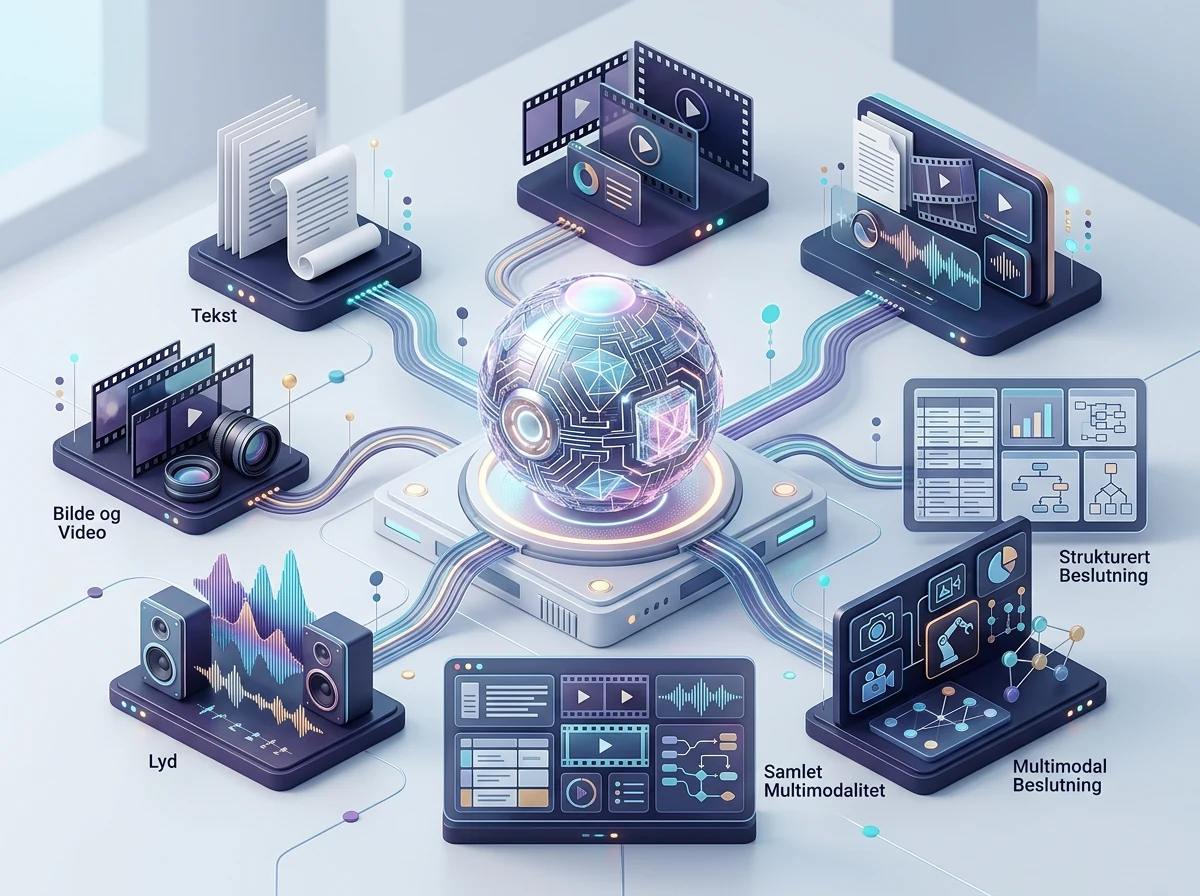
Familien består av LFM3-1.7B for tekst, LFM3-VL-2B for tekst, bilder og video, LFM3-Audio-2B for tekst og lyd, og LFM3-Omni-2B som kombinerer tekst, bilder, video og lyd. I tillegg kommer d1-2B og d1-Omni-2B, som er laget for å gi raske, strukturerte avgjørelser med sannsynlighet i stedet for lange fritekstsvar.
Poenget er ikke at du skal laste alle seks hver gang. Du velger modellen som passer til oppgaven. En lokal dokumentassistent trenger kanskje bare tekstmodellen, mens et system som skal forstå et bilde og en muntlig beskjed kan bruke omni-varianten. Det er en mer fornuftig måte å bygge lokal AI på enn å betale minne- og strømregningen for egenskaper du ikke bruker.
Seks modeller med hver sin jobb
De seks variantene deler en teknisk grunnmur, men de er ikke seks navn på den samme modellen. Liquid AIs tekniske gjennomgang på Hugging Face viser at variantene har egne innganger, utganger og enkodere tilpasset oppgaven.
LFM3-VL-2B kan lese tekst, bilder og video og svare med tekst. LFM3-Audio-2B kan ta imot tekst eller lyd og levere tekst, tale eller begge deler. LFM3-Omni-2B samler syn og hørsel i én modell, slik at den blant annet kan svare på et muntlig spørsmål om et bilde eller forstå video sammen med lydsporet.
Beslutningsmodellene er en litt annen type verktøy. Du kan gi d1-2B en faktura, et skjermbilde eller en videosnutt sammen med flere spørsmål. Modellen kan svare på dem i én kjøring, peke på objekter, lese ut verdier, anslå et tallområde og gi sannsynlighet for svarene. Det kan passe bedre til sortering, kvalitetskontroll og dokumentflyt enn en modell som absolutt skal skrive et lite essay hver gang.
Hvor liten er LFM3-1.7B i praksis?
LFM3-1.7B har 1,73 milliarder parametere og et kontekstvindu på 256K tokens. Det offisielle modellkortet oppgir at en 4-bit-versjon trenger omtrent 1 GB minne, og at modellen kan kjøres gjennom blant annet Transformers, vLLM, SGLang og kompatible llama.cpp-oppsett.
Rundt 1 GB for selve den kvantiserte tekstmodellen er lite nok til at den kan være aktuell på en vanlig laptop eller telefon. Det betyr ikke at hele arbeidslasten alltid bruker nøyaktig 1 GB. Lang kontekst, KV-cache, kjøremotor og resten av programmet krever også minne. Et kontekstvindu på 256K er en maksimal kapasitet, ikke en gratis standardinnstilling.
Her er størrelsen viktigere enn et tilfeldig topptall i en benchmark. En modell som faktisk får plass på enheten, starter raskt og kan stå og gjøre en avgrenset jobb i bakgrunnen, kan være mer verdifull enn en bedre modell du bare har råd til å kalle av og til. Det er den samme lokale retningen som gjør små multimodale modeller på en vanlig laptop interessant.
Hva er tri-hybrid-arkitekturen?
Tri-hybrid betyr at LFM3-1.7B fordeler arbeidet mellom tre typer lag: 13 korte, gatede konvolusjonslag, fem lag med sliding-window attention og seks lag med global attention. Til sammen har grunnmodellen 24 lag, ifølge den tekniske presentasjonen fra Liquid AI.
Konvolusjonslagene håndterer mye lokal behandling effektivt. Sliding-window attention ser på et begrenset vindu på 256 tokens, mens global attention kan knytte sammen informasjon over større avstander. Ideen er å bruke den dyrere globale oppmerksomheten der den trengs, i stedet for å betale samme pris i alle lag.
Liquid AI har også lagt inn gating per attention-hode, delvis RoPE og normalisering både før og etter blokkene. Selskapet sier at arkitekturen ble søkt fram mot 14 kombinasjoner av enheter og kjøremotorer – fra Raspberry Pi 5 og telefoner til GPU-er og Qualcomm Hexagon NPU. Det er mer relevant for lokal kjøring enn en modell som først og fremst er optimalisert for én stor server.
Tekstmodellen er bygget for lokale agenter
LFM3-1.7B er ettertrent for verktøykall, strukturerte svar og agentrammeverk. Liquid AI trekker fram oppgaver som å sortere e-post, håndtere kalender, hente informasjon og velge riktig verktøy fra en stor samling. Modellen støtter også utsatte verktøydefinisjoner, slik at hele verktøykatalogen ikke må presses inn i prompten på forhånd.
Det passer godt til små, vedvarende agenter som gjør én tydelig jobb lokalt. Når hvert kall ikke går gjennom en betalt skytjeneste, kan flere prosesser arbeide i bakgrunnen uten at hvert lille steg blir en ny API-kostnad. Lokale data kan også bli på maskinen når hele arbeidsflyten faktisk kjøres lokalt.
Men liten er fortsatt liten. Modellkortet sier uttrykkelig at LFM3-1.7B ikke anbefales til agentisk koding eller komplisert resonnering over mange steg. For kunnskapstunge oppgaver anbefaler Liquid AI søk eller RAG. Jeg ville derfor sett på den som en spesialist og verktøybruker, ikke som en lokal erstatning for de største resonneringsmodellene.
Syn og lyd er mer enn pynt rundt en språkmodell
LFM3-VL-2B bruker en ny synsenkoder med 164 millioner parametere. Liquid AI hevder at den bruker tre ganger mindre regnekraft enn SigLIP2-enkoderen i tidligere LFM-modeller. For video slås to samplede bilder sammen til én tidsenhet, slik at lengden på den visuelle sekvensen halveres før videre behandling.
Lydsiden har fått både en kausal lydkoder og LiquidCodec for generert tale. Selskapet oppgir tid til første token ned mot 50 millisekunder for lydinngang og dekoding av tale rundt 87 ganger raskere enn sanntid på én CPU-tråd på Apple M4 Max. Dette er leverandørmålinger på bestemte oppsett, ikke et løfte om samme fart på enhver maskin.
Den mest spennende varianten kan derfor være LFM3-Omni-2B. En kompakt modell som kan se, lytte, svare med tale og sende strukturerte verktøykall, åpner for lokale assistenter på maskiner som aldri skal kjøre en kjempemodell. Samtidig finnes det ikke dokumentasjon her som gir grunnlag for å vurdere norsk tale, dialekter, avbrytelser eller bruk i støy. Modellen oppgir 18 språk på lydsiden, men norsk er ikke blant språkene som listes i lanseringsmaterialet.
Open-weight betyr ikke uten vilkår
Alle LFM3-modellene er tilgjengelige som open-weight på Liquid AIs LFM3-samling på Hugging Face. Der ligger base-, tekst-, syn-, lyd-, omni- og beslutningsmodellene, med flere formater for lokal kjøring. Det gjør dem mulige å laste ned, undersøke og finjustere.
Open-weight er likevel ikke det samme som at alt er sluppet under en helt fri open source-lisens. Modellkortene bruker LFM Open License v1.0. Skal modellen inn i et produkt eller en kommersiell tjeneste, må du lese de faktiske vilkårene for bruken din i stedet for å anta at «åpne vekter» betyr «gjør hva du vil».
Det er heller ingen grunn til å laste ned alle variantene bare fordi de finnes. Velg tekstmodellen for tekst og verktøykall, VL-modellen for bilder og video, Audio-modellen for lyd og Omni når oppgaven faktisk krever modalitetene sammen. Spesialiseringen er hele poenget.
Hva viser Liquid AIs egne målinger?
Liquid AI oppgir at LFM3-1.7B bruker 35 prosent færre parametere enn LFM2.5-2.6B og likevel slår forgjengeren i selskapets evalueringer. Med 8K tokens i konteksten skal den være omtrent 25 prosent raskere per parameter enn LFM2-1.2B på de testede edge-enhetene.
På synssiden oppgir selskapet at LFM3-VL-2B går fra 57,6 til 71,4 i gjennomsnitt over 62 evalueringer sammenlignet med LFM2.5-VL-3B. Det høres imponerende ut, men slike samlede gjennomsnitt skjuler hvilke oppgaver som passer modellen og hvilke som ikke gjør det. Modellkortets konkrete begrensninger er mer nyttige enn en seiersrunde rundt ett snitt.
Derfor ville jeg ikke valgt modell fra en resultatgraf alene. Se først på modaliteten, lisensen, formatet som finnes for maskinvaren din, og om oppgaven krever presis kunnskap eller lang resonnering. Har du behov for større lokal kapasitet, er det mer relevant å sammenligne med modeller i en annen klasse, som Muse Glimmer på 30B for 24 GB VRAM, enn å late som 1,7B og 30B er samme type verktøy.
Dette er den praktiske verdien
LFM3 viser en retning jeg liker: bygg en liten felles grunnmur, lag tydelige spesialister og gjør dem tilgjengelige på maskinvaren folk faktisk har. Det er ikke like enkelt å selge som «én modell kan gjøre alt», men det er ofte en bedre oppskrift når programmet skal være raskt, privat og billig å kjøre.
Den rene tekstmodellen kan bli nyttig til lokale verktøykall og strukturerte oppgaver. VL- og beslutningsmodellene kan passe til dokumenter, skjermbilder, kontroll og sortering. Audio og Omni peker mot lokale talegrensesnitt, men norsk kvalitet er ikke dokumentert i materialet og skal ikke antas.
LFM3 er fersk, og de mest fristende ytelsestallene kommer fra selskapet selv. Det riktige er derfor å behandle familien som et lovende sett med byggeklosser, ikke som seks ferdig beviste vinnere. Men en tekstmodell med 256K kontekst rundt 1 GB i 4-bit, pluss egne 2B-modeller for syn, lyd og beslutninger, er mer enn en kosmetisk oppdatering. Lokal multimodal AI blir ganske enkelt lettere å få plass til.
Ofte stilte spørsmål
Kan Liquid AI LFM3 kjøres på en vanlig laptop?
Ja, særlig tekstmodellen er laget for lokal kjøring. LFM3-1.7B bruker ifølge modellkortet omtrent 1 GB minne i 4-bit, men kjøremotor, kontekst og øvrige data krever ekstra minne. De multimodale variantene har andre krav.
Er LFM3 gratis og helt åpen kildekode?
Modellvektene kan lastes ned fra Hugging Face under LFM Open License v1.0. Det er mer presist å kalle dem open-weight enn helt fri open source. Les lisensen før kommersiell bruk eller distribusjon.
Hvilken LFM3-modell bør jeg velge?
Velg LFM3-1.7B til tekst og verktøykall, VL-2B til bilder og video, Audio-2B til lyd, Omni-2B når syn og lyd må kombineres, og d1-variantene til raske strukturerte beslutninger.
Støtter LFM3 norsk tale?
Norsk er ikke blant de 18 lydspråkene som oppgis i lanseringsmaterialet. Kildene dokumenterer heller ikke norsk uttale, dialektforståelse, støy eller avbrytelser. Det finnes derfor ikke grunnlag for å gi modellen en positiv eller negativ norsk kvalitetsdom.