Liquid AI LFM3 gjør multimodal AI liten nok for lokal kjøring
Liquid AI LFM3 samler seks små modeller for tekst, bilde, video og lyd. Tekstmodellen har 256K kontekst og bruker rundt 1 GB i 4-bit.
28. oktober 2026
14 visninger
7 minutter lesetid
d1-ultra gir AI-agenter sannsynligheter i stedet for tekst
d1-ultra vurderer tekst og bilder i ett pass og gir kalibrerte sannsynligheter uten tekstgenerering. Modellen er tilgjengelig via Liquid API og listet hos OpenRouter.
16. oktober 2026
46 visninger
6 minutter lesetid
Nemotron 3.5 Super VL – 120B-modellen som kjører på én DGX Spark
Nemotron 3.5 Super VL er en åpen 120B multimodal agentmodell som kjører på én DGX Spark. Se hva 12B aktive parametere og NVFP4 betyr i praksis for deg.
16. oktober 2026
49 visninger
8 minutter lesetid
Decision 3.0 gir AI-agenter raske valg uten tekstgenerering
Decision 3.0 er en åpen familie av multimodale beslutningsmodeller fra 0,6B til 27B. Modellene velger, scorer og svarer ja eller nei uten å generere tekst.
12. oktober 2026
54 visninger
7 minutter lesetid
EmbeddingGemma 2 gir lokalt søk i tekst, bilder, video og lyd
EmbeddingGemma 2 er en lokal multimodal embedding-modell for tekst, kode, bilder, video og lyd. Se modellstørrelser, lokal RAG og tekniske fallgruver.
7. oktober 2026
54 visninger
6 minutter lesetid
Mistral Large 4 går for toppsjiktet – åpne vekter kommer senere
Mistral Large 4 har én million tokens kontekst og åpne vekter på vei. Se API-pris, kapasitet, maskinvarekrav og hva som må bevises i praksis før lokal drift.
7. oktober 2026
61 visninger
7 minutter lesetid
Reka Rho-1 samler AI-video og robotstyring i én modell
Reka Rho-1 er en 19B-modell som forstår og lager tekst, bilder og video, og sender robothandlinger fra samme tilstand. Dette er løftet og begrensningene.
6. oktober 2026
53 visninger
7 minutter lesetid
Qwen3.8-Omni-Flash leter målrettet i lange videoer
Qwen3.8-Omni-Flash analyserer lange lyd- og videofiler målrettet, bruker verktøy og har 1 million tokens kontekst. Se pris, tilgang og viktige begrensninger.
18. september 2026
77 visninger
7 minutter lesetid
GLM-5.3-Flash gir deg én million tokens til småpenger
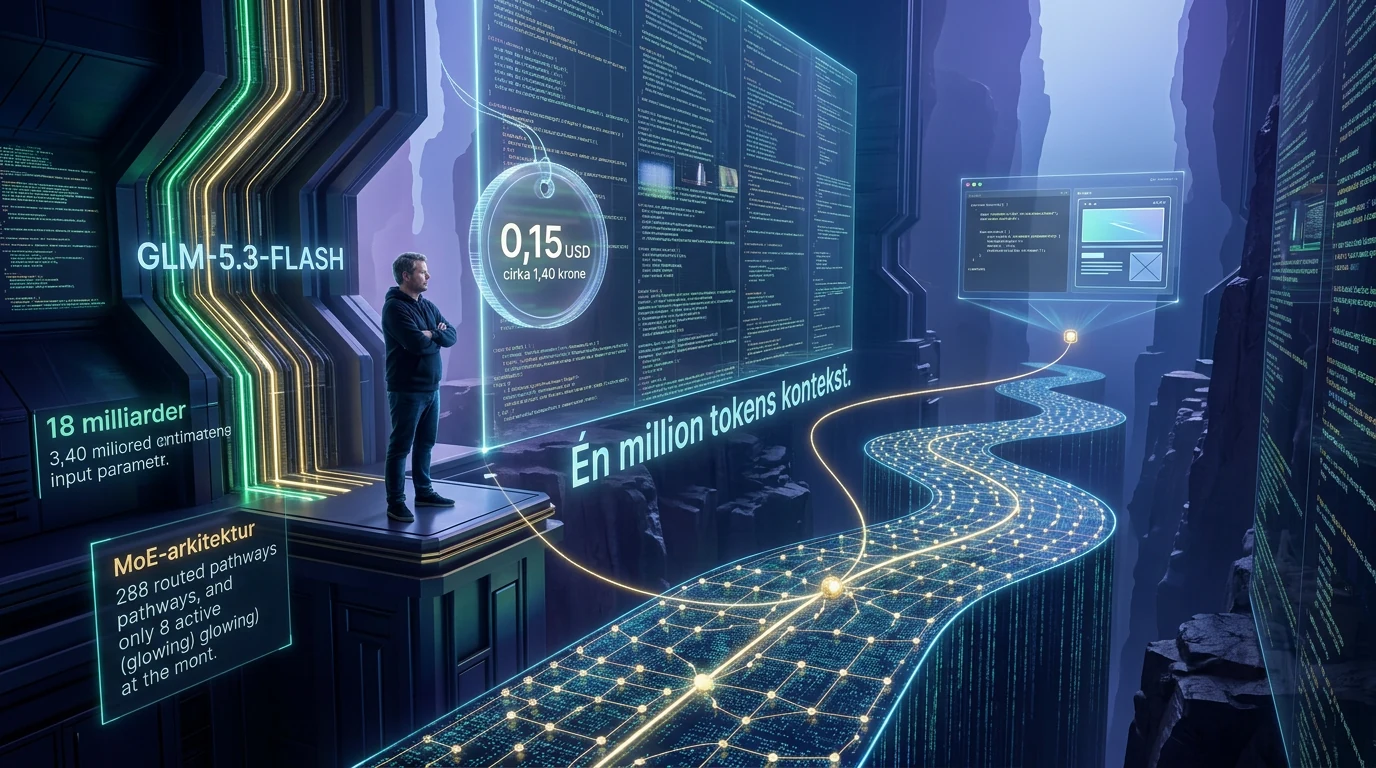
GLM-5.3-Flash gir én million tokens, multimodal agentbruk og åpne vekter til lav API-pris. Se hva modellen koster, krever og egner seg til i praksis nå.
27. august 2026
121 visninger
8 minutter lesetid
Apertus 1.5 blir multimodal – men åpenheten er fortsatt hovedsaken
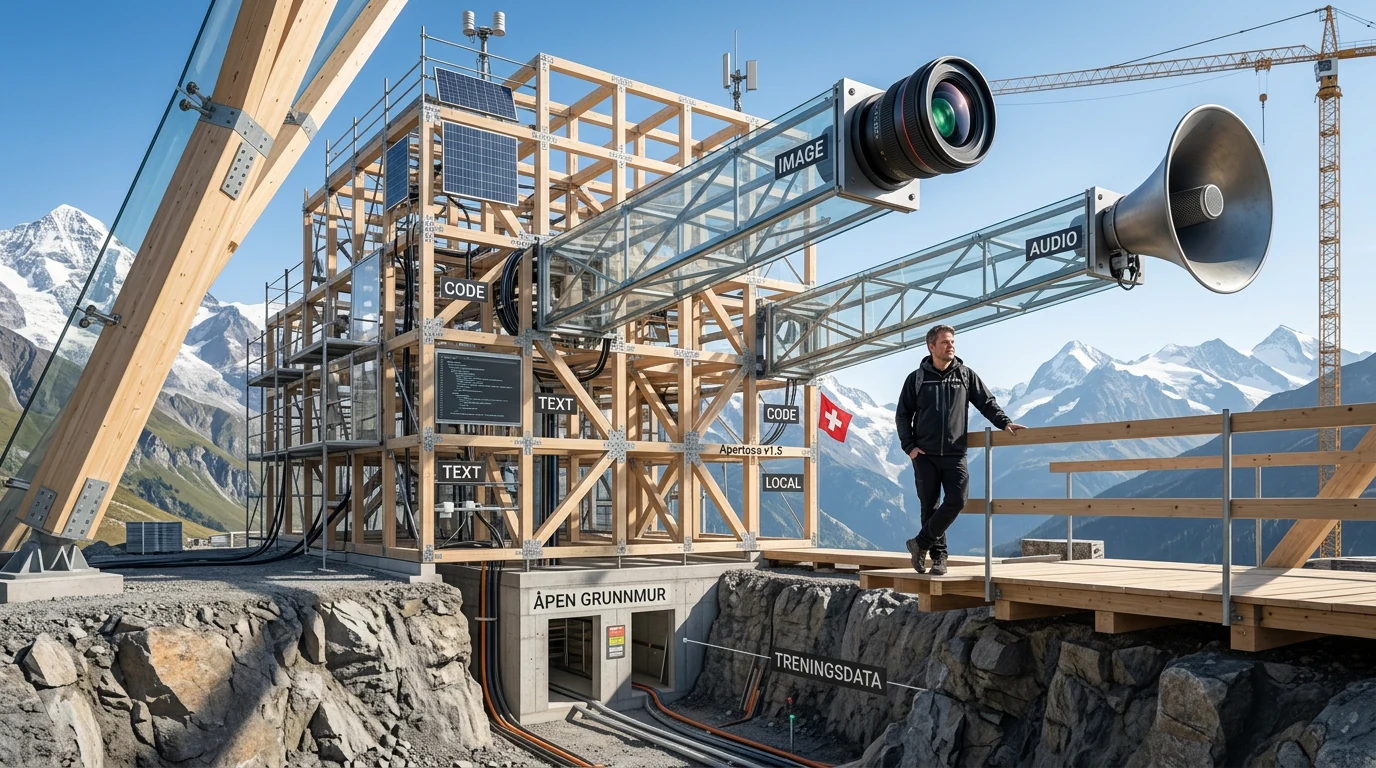
Apertus 1.5 gjør den åpne sveitsiske AI-modellen multimodal i 8B og 70B, med 262 144 tokens, tenkemodus og lokal kjøring – men full dokumentasjon mangler ennå.
24. juli 2026
136 visninger
7 minutter lesetid
FLUX 3 samler video, lyd og robothandlinger i én modell
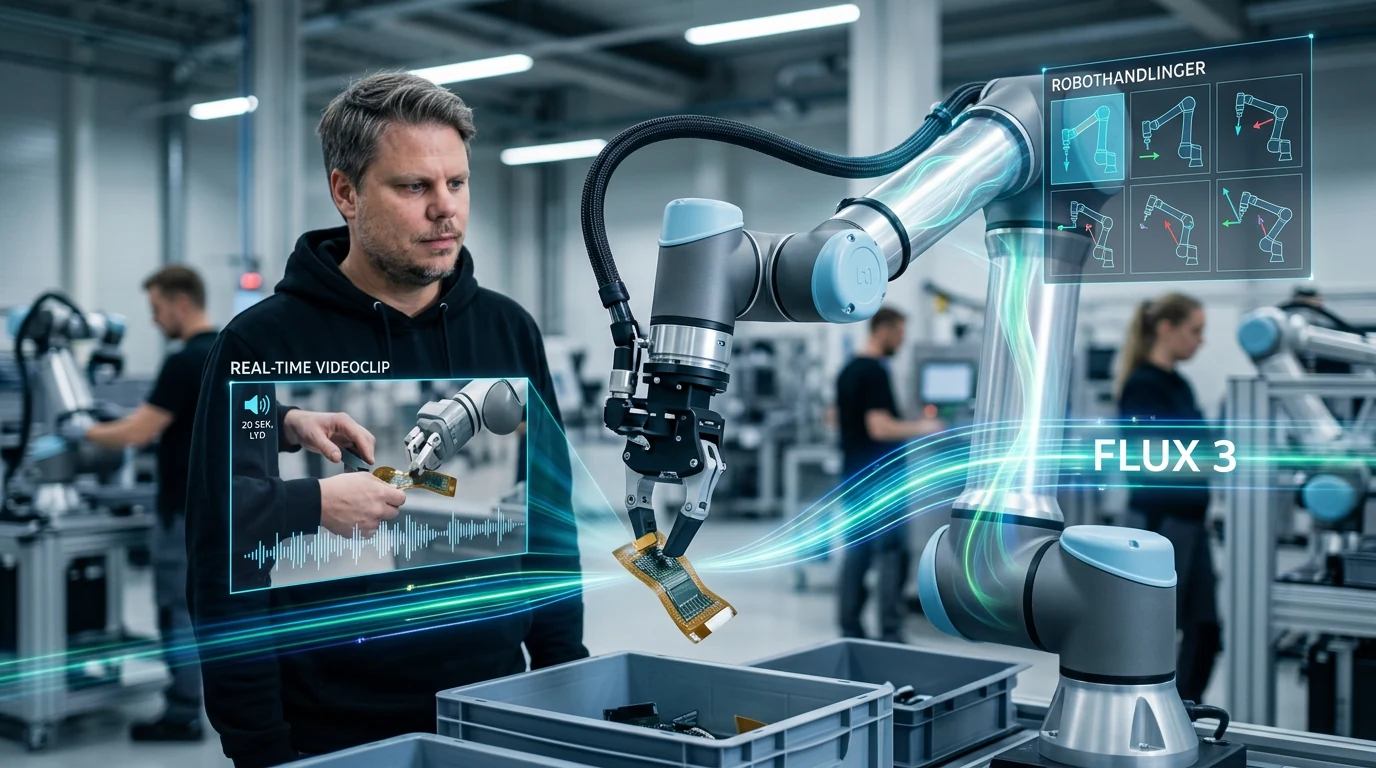
FLUX 3 lager video med lyd og bruker samme multimodale grunnmodell til robotstyring. Se hva BFL har lansert, målingene og begrensningene.
24. juli 2026
109 visninger
8 minutter lesetid
Qwen3.8-Max kan prøves nå – men de viktigste tallene mangler
Qwen3.8-Max kan prøves nå med 2,4 billioner oppgitte parametere. Men modellkort, benchmark, lisens, aktiv størrelse og vanlig API-pris mangler fortsatt.
20. juli 2026
109 visninger
6 minutter lesetid
Kimi K3 er enorm – men maks tenking har en pris
Kimi K3 har 2,8 billioner parametere og millionkontekst, men maks tenking gjør selv små oppgaver dyre. Pelikan-testen viser hva benchmarktabellen skjuler.
17. juli 2026
147 visninger
7 minutter lesetid
Inkling er ikke den sterkeste AI-modellen – og det er hele poenget
Inkling er Thinking Machines sin nye AI-modell med åpne vekter. Se hva den kan, maskinvarekravene og hvorfor tilpasning er viktigere enn å være best totalt.