Innhold Vis
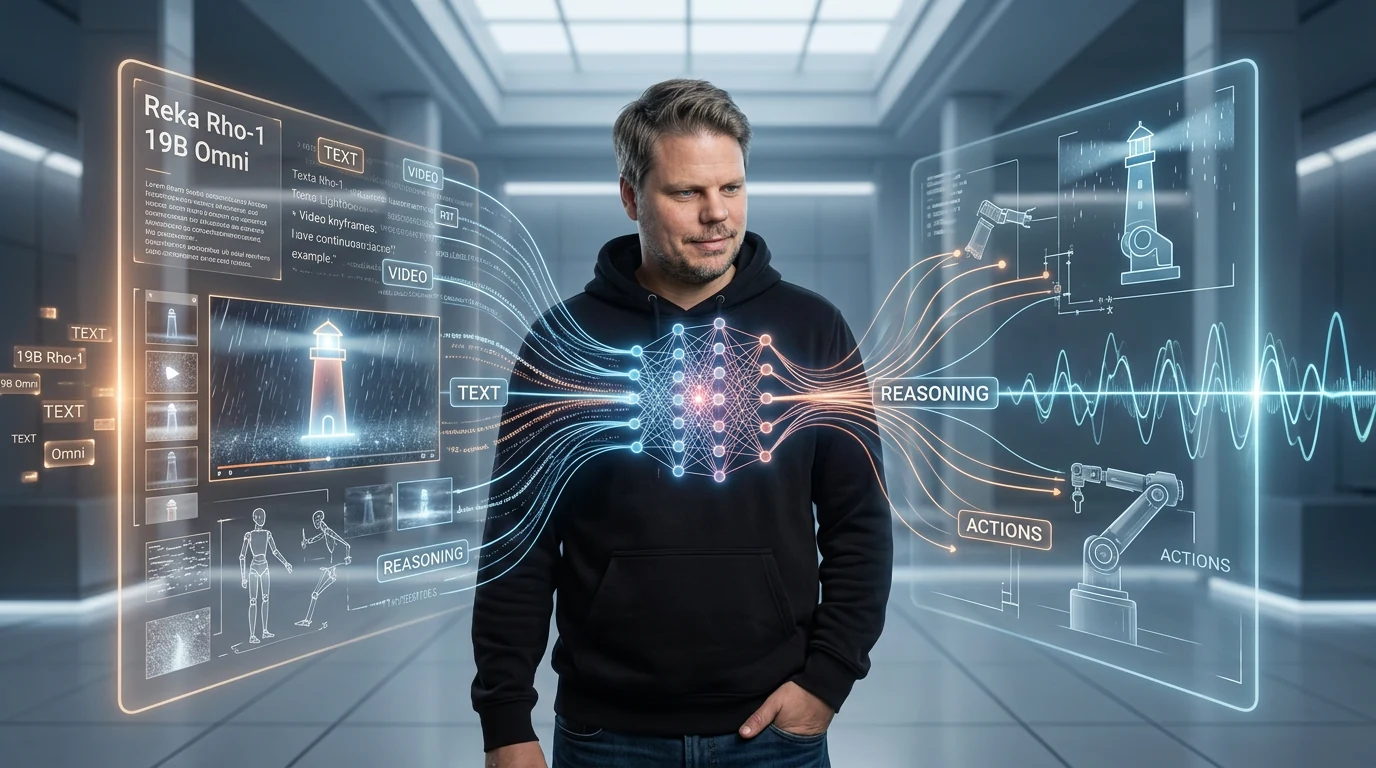
Reka Rho-1 samler forståelse, videogenerering og robothandlinger i én modell med 19 milliarder parametere. I stedet for å sende oppgaver mellom en språkmodell, en bildemodell, en videomodell og en egen robotpolicy, lar Rho-1 alle delene arbeide med den samme tilstanden. Det er et langt mer spennende poeng enn enda en modell som lager et kort videoklipp.
Reka viser en sammenhengende samtale der modellen tegner et fyrtårn, finner det i bildet, animerer scenen, endrer været i videoen og forklarer hva som ble forandret. Ingen ekstern detector, promptforbedrer eller ekstra videogenerator skal være med på turen. Samme nettverk holder tråden gjennom hele forløpet.
Men det er viktig å holde beina på bakken. Rho-1 ble presentert 5. oktober 2026 som en research preview. Det finnes foreløpig ingen offentlige vekter, ingen vanlig API-tilgang og ingen pris. Resultatene kommer fra Reka selv, og selskapet er åpent om både lav oppløsning, ustabile redigeringer og problemer når videoen blir lang. Dette er en svært interessant arkitektur, ikke en ferdig tjeneste du kan bygge produksjon på i dag.
Hva er Reka Rho-1?
Rho-1 er en 19B omni-reasoning-modell som forstår og genererer tekst, bilder og video, resonnerer over innholdet og produserer handlinger for roboter. Ifølge Rekas presentasjon av Rho-1 er modellen trent fra bunnen av på 320 Nvidia H100-GPU-er over tre måneder.
Ordet «omni» blir brukt litt vel løst i AI-verdenen, men her beskriver det en konkret symmetri. Modellen kan både ta imot og sende ut fem typer signaler: tekst, bilder, video, handlinger og propriosepsjon – altså informasjon om robotens egen stilling og bevegelse. Det den lager, kan føres rett tilbake til den samme konteksten i neste runde.
Det skiller Rho-1 fra mange multimodale språkmodeller som kan se et bilde, men bare svare med tekst. Det skiller den også fra en vanlig videomodell som kan ta imot en tekstbeskrivelse og lage piksler, men ikke undersøke sin egen scene, føre en samtale om den og velge en robothandling fra samme tilstand.
Rekas femtrinns demo gjør forskjellen forståelig. Rho-1 lager først bildet av fyrtårnet. Deretter gir den koordinatene til fyrtårnet, bruker det samme bildet som start på en video, endrer videoen til snøstorm og sammenligner de to versjonene. MarkTechPost beskriver hele forløpet som fem runder uten verktøykall eller en sekundær modell.

Hvordan kan én modell gjøre alt dette?
Rho-1 bruker to ekspertstrømmer inne i hver transformerblokk. Forståelsesstrømmen arbeider med språk og visuell analyse. Genereringsstrømmen gjør støy om til bilder og video. De har forskjellige vekter for forskjellige oppgaver, men deler attention og arbeider mot den samme KV-cachen.
Det er denne delte tilstanden som er selve poenget. Instruksjoner, tidligere bilder, videorammer, resonnement og motorhandlinger samles i samme kontekst. Når modellen skal bytte fra et tekstsvar til visuell generering, sender forståelsesstrømmen et eget token som starter genereringsstrømmen. Den begynner da med hele historikken, ikke med et kort sammendrag sendt fra en annen modell.
Tekst og overordnede kommandoer representeres som diskrete tokens. Bilder, videorammer, robotbevegelser og propriosepsjon representeres som kontinuerlige tokens. Rho-1 trenes derfor med to mål samtidig: vanlig prediksjon av neste token for de diskrete sekvensene og flow matching for kontinuerlig generering.
Det betyr ikke at Rho-1 i praksis er én enkel blokk som gjør absolutt alt likt. Modellen har spesialiserte strømmer og en diffusion-del for visuell generering. Forskjellen er at spesialistene bor i samme nettverk og ser samme tilstand. Reka prøver å fjerne skjøtene i systemet, ikke all spesialisering.
Hvor rask er videogenereringen?
Basemodellen genererer video med en medianfart på 0,79 ganger sanntid, og Reka oppgir omtrent 6 sekunder før en sebar strøm starter. I selskapets egen illustrasjon kom første klipp fra Rho-1 etter 7,0 sekunder, mot 13,8 sekunder for en tenkt fleragent-pipeline. Den siste sammenligningen er illustrativ, ikke en uavhengig test.
Den destillerte varianten, kalt Rho-1 Flash i demoene, kutter antall denoising-steg fra 99 til 8. Reka viser et klipp på 5,3 sekunder som ble rendret på rundt ett sekund. Flere små endringer i samme scene tok mellom 1,11 og 2,01 sekunder i selskapets faste testoppsett.
Det er raskt nok til at videogenerering begynner å ligne en samtale i stedet for en bestilling du legger i kø. En bruker kan endre retning, vær eller objekter mens en simulering fortsetter. Det er også her Rho-1 skiller seg fra verktøyene i min guide til AI-videogenerering: Målet er ikke bare å levere et ferdig klipp, men å holde en verden levende og styrbar over tid.
Samtidig er alle fartstallene målt av Reka. Selskapet har ikke offentliggjort maskinvaren som brukes ved hvert inferensforsøk, en pris per generering eller en test andre kan gjenta med åpne vekter. Tallene viser hva teamet har fått til i sitt eget miljø. De forteller ennå ikke hva en utvikler vil betale eller oppleve i en offentlig tjeneste.
Hvorfor kobles videogenerering til roboter?
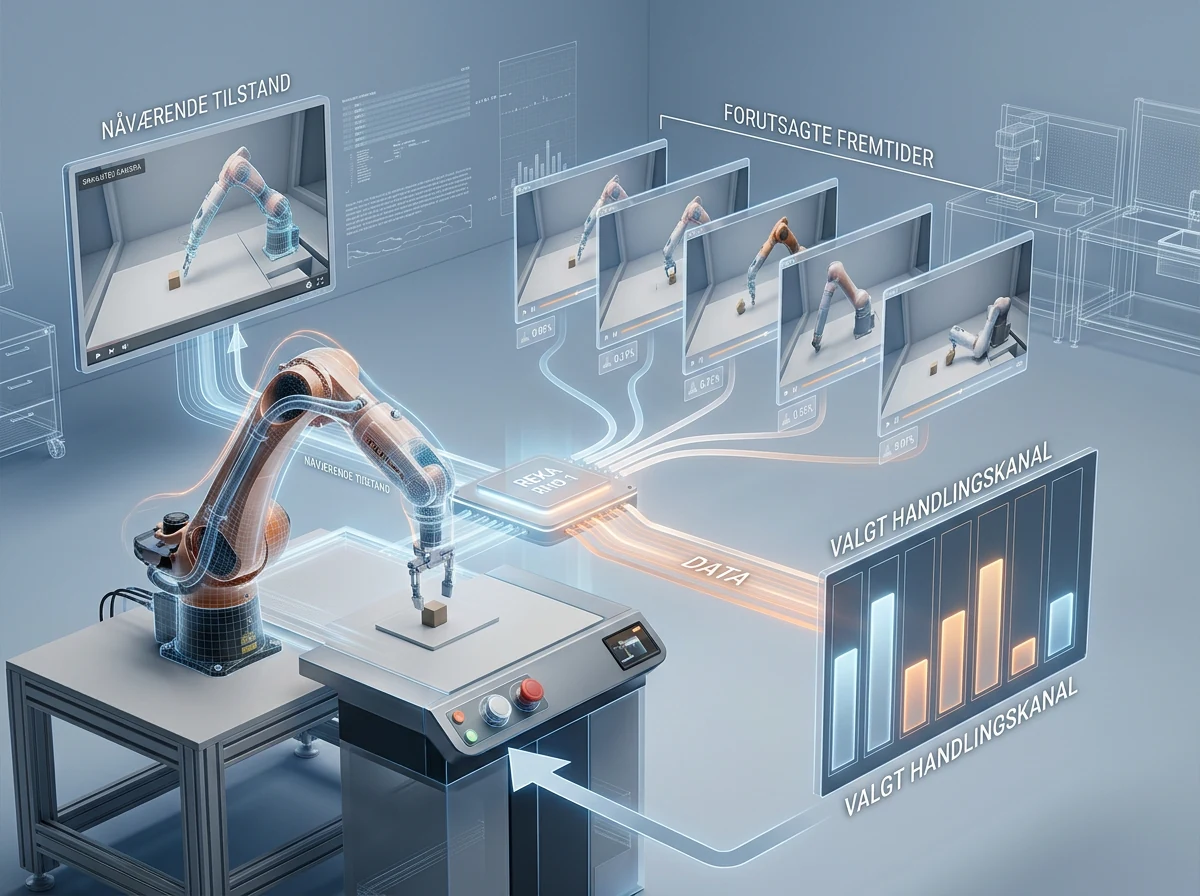
Rho-1 behandler fremtidige videorammer og robothandlinger som deler av den samme kontinuerlige tilstanden. Modellen kan dermed forutsi hva kameraet sannsynligvis vil se etter en bevegelse, og samtidig sende ut bevegelsen som skal føre dit. I Rekas LIBERO-demo produserer modellen sju handlingskanaler i en simulert robotoppgave.
Det er en fristende idé: Robotens plan, forestilling om framtiden og motorstyring slipper å være tre systemer som sender forenklede beskjeder til hverandre. En modell som forstår fysisk kontakt fra store mengder video, kan først se for seg de neste sekundene og deretter velge handlingen som fører fram.
Flaskehalsen er at internett er fullt av video, men nesten tomt for registrerte leddvinkler, styreutslag og kraftmålinger. Reka vil fylle gapet med sin Inverse Dynamics Model. Den analyserer video og prøver å rekonstruere handlingene som skapte bevegelsene. Resultatet kan brukes som handlingsmerket treningsdata for Rho-1.
Dette er foreløpig et forskningsspor, ikke bevis på at Rho-1 kan styre en fysisk robot trygt på et lager eller på et sykehus. Demoen er kjørt i LIBERO-simulering, og kvaliteten på handlinger utledet fra vanlig video må testes langt grundigere. Den praktiske avstanden til en åpen robotplattform som Asimov v1 er fortsatt betydelig.
Hva kan du faktisk bruke Rho-1 til?
6. oktober 2026 kan de fleste ikke bruke Rho-1 til noe som helst. Modellen er tilgjengelig som en research preview for utvalgte samarbeid, og Reka inviterer utviklere innen robotikk, interaktive simuleringer og lukkede syn-handling-systemer der syn og handling inngår i en lukket sløyfe, til å ta kontakt. Det finnes ingen offentlig nedlasting, modelllisens, API-pris eller selvbetjent app.
For forskere og selskaper med et konkret prosjekt peker modellen mot tre bruksområder. Det første er multimodale assistenter som kan tegne, undersøke, animere og redigere samme scene uten å miste sammenhengen. Det andre er interaktive verdener som fortsetter å utvikle seg mens brukeren styrer dem. Det tredje er robotikk der forståelse av video, simulering av neste tilstand og motorhandling trenes sammen.
Det kan på sikt redusere både ventetid og feil i overgangene mellom modeller. Dagens agentpipeline kan være svært god, men hver overlevering risikerer å miste detaljer. En videomodell får en prompt i stedet for hele resonnementet. En detector analyserer eksporterte bilder i stedet for tilstanden som skapte dem. En robotpolicy får et mål, men ikke nødvendigvis hele den visuelle historien.
Likevel har modulære systemer en fordel Reka ikke bør snakke bort: Hver del kan byttes, testes og skaleres separat. Hvis én samlet modell gjør en feil, kan det bli vanskeligere å se om problemet kom fra forståelse, simulering eller handling. En elegant arkitektur er ikke automatisk en enklere produksjonsarkitektur.
Hvilke begrensninger har Rho-1?
Reka oppgir fire tydelige begrensninger. Lange videoforløp driver bort fra den opprinnelige strukturen. En strøm på 30 sekunder kan fortsatt se skarp og fotorealistisk ut, men rommet kan ha forandret seg på måter som ikke henger sammen. Modellen bevarer altså overflaten bedre enn selve verdenen.
Objektlokalisering fungerer på stillbilder, men er ennå ikke stabil over tid i video. Målrettet redigering er også skjør på tvers av ulike instrukser. I tillegg er den opprinnelige videooppløsningen begrenset til 672 x 384 piksler. Det er nok til forskning og demonstrasjoner, men langt unna oppløsningen mange forventer av ferdig videoinnhold.
Det mangler også informasjon som betyr mye for en praktisk vurdering: kontekstvindu, treningsdata, maskinvarebehov ved inferens, pris og uavhengige sammenligninger. Reka kaller selv modellen et funksjonelt proof-of-concept og en arkitektonisk retning, ikke et ferdig produkt. Det er en presis beskrivelse.
Jeg ville derfor ikke sammenlignet Rho-1 med ferdige videoverktøy ut fra noen få leverandørdemoer. Følg heller med på om Reka åpner vekter eller API, om eksterne utviklere kan gjenta hastigheten, og om modellen beholder geometri og handling over lengre forløp. Det er der den store påstanden enten blir bekreftet eller sprekker.
Hvorfor er Rho-1 viktig likevel?
Rho-1 er viktig fordi den viser en mulig vei bort fra multimodale systemer som egentlig er en samling separate modeller med en språkmodell som sentralbord. 19 milliarder parametere er heller ikke en absurd størrelse for et forsøk som spenner over språk, bilde, video og robotstyring. Hele kontrollpunktet ble ifølge Reka trent på 320 H100-kort over tre måneder.
Det mest lovende er ikke at modellen kan lage et fyrtårn i snø. Det kan andre verktøy også. Det lovende er at samme tilstand brukes til å lage scenen, finne objektet, endre bevegelsen, forstå endringen og velge en fysisk handling. Hvis denne typen arkitektur skalerer, kan forbedringer i romforståelse, video og motorstyring forsterke hverandre i stedet for å bli sittende i hver sin modell.
Det er også den store risikoen. Når alle egenskapene deler samme grunnmur, kan problemer og kompromisser spre seg på samme måte. Rho-1 må vise at én samlet modell ikke bare er penere på et arkitekturdiagram, men faktisk mer pålitelig, rimeligere og lettere å styre enn gode spesialister koblet sammen.
Foreløpig er dommen derfor enkel: Rho-1 er en arkitektur det er verdt å følge tett, men ikke en modell det går an å anbefale som verktøy. Det avgjørende blir offentlig tilgang, uavhengige tester og om den delte tilstanden holder når demoen blir til rotete virkelighet. Én modell som virkelig kan se, forestille seg og handle sammenhengende hadde vært et stort skritt. Reka har vist retningen, ikke målstreken.
Ofte stilte spørsmål
Kan jeg laste ned Rho-1 og kjøre modellen lokalt?
Nei. 6. oktober 2026 er Rho-1 bare en research preview. Reka har ikke publisert modellvekter, lisens, maskinvarekrav eller en offentlig API. Selskapet tar imot henvendelser fra miljøer som arbeider med blant annet robotikk og interaktive simuleringer.
Lager Rho-1 virkelig en video på omtrent ett sekund?
Reka viser en destillert variant som lager 5,3 sekunder video på omtrent ett sekund ved å redusere denoising fra 99 til 8 steg. Målingen er gjort av leverandøren i eget miljø, og det finnes ennå ikke åpne vekter eller uavhengige tester som bekrefter ytelsen.
Kan Rho-1 styre en ekte robot?
Reka viser Rho-1 i en simulert LIBERO-oppgave med sju handlingskanaler. Det dokumenterer koblingen mellom framtidige videorammer og robothandlinger, men er ikke det samme som sikker og stabil kontroll av en fysisk robot i et virkelig miljø.
Hva er den største forskjellen mellom Rho-1 og en vanlig AI-pipeline?
En vanlig pipeline sender ofte oppgaver mellom separate modeller for språk, bilde, video og handling. Rho-1 har spesialiserte strømmer, men de ligger i samme nettverk, deler attention og bruker samme KV-cache. Dermed kan hele forløpet beholde én felles tilstand.