Innhold Vis
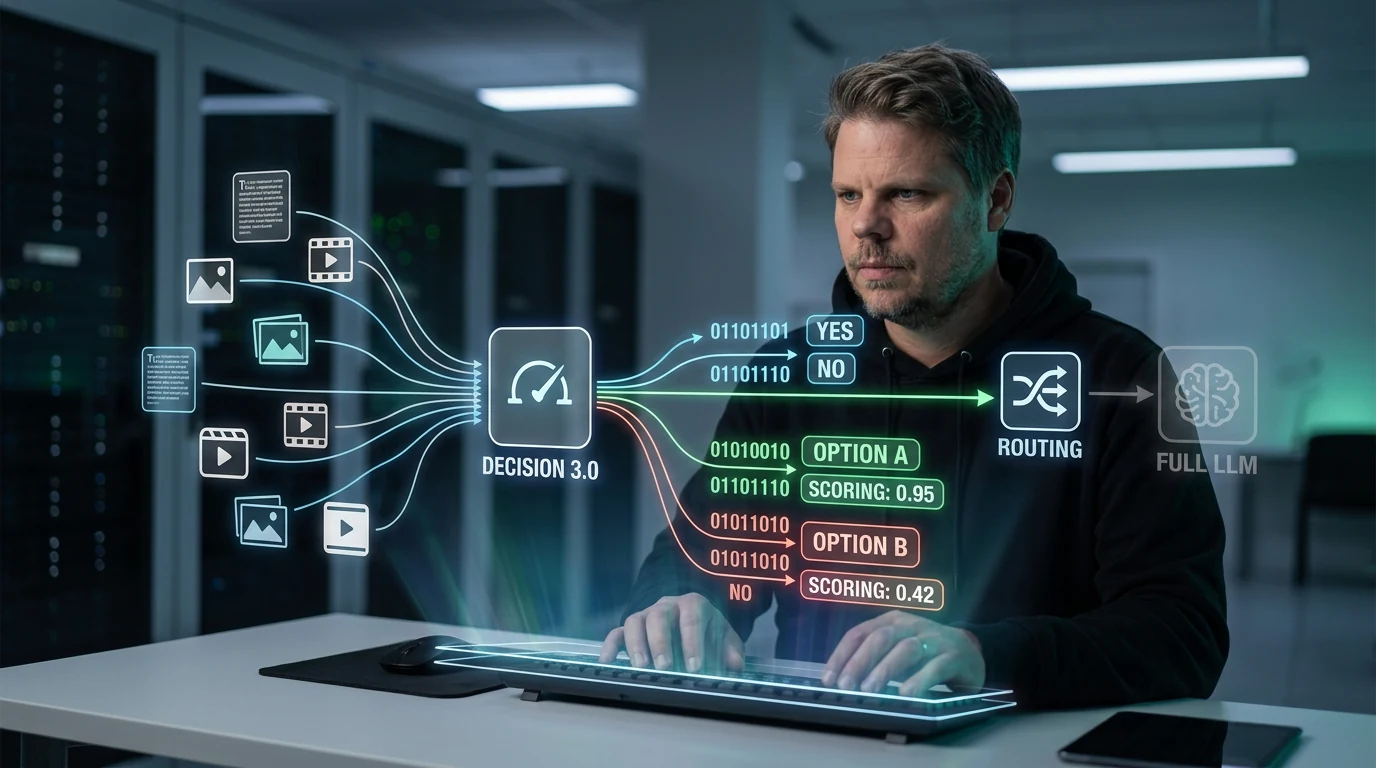
Decision 3.0 lar en AI-agent ta raske, strukturerte valg om tekst, bilder og video uten å bruke en stor språkmodell til å skrive et helt svar. Den åpne modellfamilien dekker størrelser fra 0,6B til 27B og returnerer sannsynligheter for hvert svaralternativ.
Det høres kanskje smalt ut. Det er nettopp poenget. Mange oppgaver i en AI-pipeline trenger ikke en modell som kan skrive dikt, kode og lange utredninger. De trenger et pålitelig svar på spørsmål som «hvilken modell skal få denne forespørselen?», «inneholder bildet en kvittering?» eller «hvor viktig er denne saken?».
Min foreløpige dom er at dette er en nyttig retning for lokale AI-systemer. En spesialist som bare tar beslutninger kan være raskere, billigere og enklere å kontrollere enn en generell språkmodell. Men førsteplassen på en resultatliste er ikke nok. Det avgjørende er om den lille utgaven treffer godt på dine egne valg, med dine egne feilmarginer.
Hva er Decision 3.0?
Decision 3.0 er seks åpne, multimodale beslutningsmodeller med Apache-2.0-lisens. Den offisielle samlingen på Hugging Face spenner fra d3-edge på rundt 0,6 milliarder parametere til d3 på 26,09 milliarder, som markedsføres som 27B-modellen.
Familien er bygget på Qwen3.5 i størrelsene 0,8B, 2B, 4B og 9B, mens toppmodellen bruker Qwen3.8-27B. Jeg har tidligere skrevet om hvorfor Qwen3.8-27B kan bli den praktisk viktigste modellen i Qwen3.8-familien. Tallene som vises på Hugging Face inkluderer også synsdelen. Derfor står blant annet d3-mini oppført som omtrent 5B og d3-flash som omtrent 8B, selv om de omtales etter grunnmodellens størrelsesklasse.
Alle modellene kan lese tekst eller JSON sammen med flere bilder og videoer. De produserer ikke fritekst. I stedet støtter de tre spørsmålstyper: valg mellom oppgitte alternativer, ja eller nei, og poengsetting på en definert skala. Resultatet inneholder en sannsynlighet for hvert mulig svar.

Hvorfor bruke en beslutningsmodell?
En beslutningsmodell passer når utfallet allerede kan beskrives som et avgrenset sett med valg. Den kan sende kundesaken til riktig kø, velge mellom en billig og en kraftig språkmodell, prioritere dokumenter, merke innhold eller avgjøre om en agent trenger menneskelig godkjenning.
En vanlig språkmodell kan selvsagt også svare «ja» eller «nei». Problemet er at den er laget for å generere tekst token for token. Da kan den legge til forklaringer, variere formatet eller bruke tid og minne på en evne oppgaven ikke trenger. Decision 3.0 hopper over selve tekstgenereringen og leverer et fast svarformat som resten av systemet kan behandle direkte.
Det gjør modellen særlig relevant som et lite kontrollag foran dyrere modeller. vLLM Semantic Router er laget for å plassere et slikt beslutningslag mellom klienten og ulike modellendepunkter. En enkel forespørsel kan gå til en rask lokal modell, mens en vanskelig kodeoppgave sendes til en sterkere modell. Det er langt mer fornuftig enn å starte den største motoren hver gang noen skal over veien.
Tekst, bilder og video går inn i samme beslutning
Den store endringen fra forrige generasjon er at hele familien er multimodal. Modellen kan vurdere flere bilder i samme forespørsel, med opptil 1,6 megapiksler per bilde. Video støttes i formatene MP4, WebM, MOV og MKV og leses med to bilder per sekund, maksimalt 32 bilder totalt og opptil 0,2 megapiksler per videobilde.
Det åpner for mer enn modellrouting basert på tekst. Et system kan for eksempel få en melding, et bilde av et skadet produkt og en kvittering i samme forespørsel. Deretter kan det avgjøre hvilken avdeling saken tilhører, om kvitteringen faktisk viser produktet og hvor raskt saken bør behandles.
Flere spørsmål kan sendes i ett kall. Hvert spørsmål får likevel sin egen gjennomkjøring av inputen, ifølge modellkortet. Det er en viktig detalj: «ett kall» betyr et ryddig API og samlet resultat, ikke at alle spørsmålene nødvendigvis beregnes gratis i én eneste operasjon.
Hva viser resultatene?
Toppmodellen d3 fikk 64,7 på den samlede Jev Decision Index for tekst og 71,6 på synslisten. I modellkortet for d3 ligger den foran de andre oppførte 27B-modellene på begge listene. Den offentlige delen av teksttesten er oppgitt til 65,45, basert på alle 140 178 forespørsler.
Den mindre d3-flash er kanskje mer praktisk interessant. Modellkortet for d3-flash oppgir 59,0 på den samlede tekstindeksen og 66,9 på synsindeksen. Den slo samtidig Decision 2.0 i 27B-klassen på den oppgitte tekstmålingen. Det er et godt tegn på at forbedringen ikke bare kommer av å velge størst mulig modell.
Videoresultatene er også lovende. Toppmodellen fikk 77,4 prosent riktige svar på alle de 19 140 flervalgsspørsmålene i valideringssettet til Perception Test. d3-flash fikk 73,3 prosent, og 4B-grunnmodellen ble oppgitt til 70,3 prosent. Ingen av modellene skal ha sett video under treningen.
Her må den lille skriften få være med. Decision 3.0-teamet har selv kjørt evalueringene på de publiserte vektene med den offisielle Jev-pakken. Resultatene er ferske og konkrete, men de er fortsatt leverandørens egne målinger. En topplassering sier heller ikke hvilken feil som blir dyr i din pipeline. Feilruting av en ufarlig e-post og feil godkjenning av en betaling er to ganske forskjellige tirsdager.

Hvor rask er Decision 3.0?
På én AMD Instinct MI325X målte teamet en median på 55 millisekunder for tekst, 273 millisekunder for ett bilde og 553 millisekunder for en video på ti sekunder med toppmodellen. For d3-flash var de tilsvarende målingene 19,1, 149,4 og 407,6 millisekunder.
Dette er ikke tall du kan overføre rett til en RTX 4090, CPU eller bærbar PC. Modellene ble målt én forespørsel om gangen på en kraftig datasenter-GPU, og hastigheten avhenger av maskinvare, inputlengde, antall spørsmål og programvaren rundt. Målingene viser likevel hvorfor denne modelltypen finnes: beslutninger kan tas uten at et langt svar må genereres først.
Vektene er publisert i BF16. Toppmodellens 26,09 milliarder parametere tilsvarer grovt regnet litt over 52 GB bare til vektene før ekstra minne til kjøring. d3-flash med 8,39 milliarder parametere ligger rundt 17 GB på samme enkle regnestykke. Småmodellene er derfor de naturlige startpunktene for vanlig lokal maskinvare, mens kvantiserte utgaver kan endre regnestykket senere.
Hva kreves for å kjøre modellen?
Modellkortene viser to offisielle veier. Den ene er Transformers 5.17.0 med PyTorch, der modellen lastes med AutoModel.from_pretrained(..., trust_remote_code=True). Den andre er Engine-modusen i vLLM Semantic Router, som eksponerer modellen gjennom System One-API-et på port 8899.
Bruk av trust_remote_code=True betyr at kode fra modellpakken får kjøre lokalt. Det er ikke nødvendigvis et problem, men det bør behandles som annen tredjepartskode: se gjennom kilden, lås versjonen og kjør den i et avgrenset miljø før den får tilgang til produksjonsdata.
Engine-modusen og Decision 3.0 ligger foreløpig i utviklingskanalen til vLLM Semantic Router. Installasjonen oppdager CPU, CUDA eller ROCm automatisk, og første oppstart laster ned både riktig container og modell. Dette er altså kjørbart nå, men ikke et signal om at integrasjonen allerede er en ferdig, stabil standardutgave.
Hvilken utgave bør du se på?
Start med den minste modellen som klarer beslutningen godt nok. d3-edge og d3-lite er aktuelle for enkle ja/nei-valg og lokal klassifisering med stramme ressursgrenser. d3-mini og d3-flash gir mer kapasitet til sammensatte valg, bilder og routing der flere signaler må veies samtidig.
27B-modellen er mest aktuell når beslutningskvaliteten er viktigere enn minnebruk og svartid, eller når samme system skal håndtere krevende tekst, bilder og video. Men større er ikke automatisk riktig. Hvis d3-flash treffer like godt på dine data, er det liten grunn til å betale minne- og driftskostnaden for d3.
Jeg ville laget et lite testsett med ekte saker og målt mer enn samlet treffprosent. Se på hvilke typer feil modellen gjør, hvor sikker den er når den tar feil, og hva som skjer rundt terskelverdiene. Legg inn en utvei for usikre svar: send saken til en sterkere modell eller et menneske i stedet for å late som 51 prosent er en naturkraft.
En åpen byggestein, ikke en ferdig autopilot
Apache-2.0-lisensen, seks størrelser og støtte for både tekst, bilder og video gjør Decision 3.0 til en uvanlig fleksibel byggestein. Det er også positivt at modellen gir sannsynligheter i stedet for bare et nakent valg. Da kan utvikleren sette terskler og behandle lav sikkerhet som et eget resultat.
Samtidig er en beslutningsmodell bare én del av systemet. Den kjenner ikke bedriftens kostnad ved feil med mindre testene og reglene gjenspeiler den. Den håndhever heller ikke tilgangskontroll, logger ikke nødvendigvis konsekvensene og kan ikke alene avgjøre når en handling er for risikabel til å automatiseres.
Det er likevel her Decision 3.0 blir spennende: ikke som en ny chatbot, men som et lite og målbart kontrollag. Hvis de små utgavene holder nivået på virkelige arbeidsdata, kan mange AI-systemer slutte å bruke en generalist til hver eneste mikrobeslutning. Test den lokalt, mål feilene og la usikkerhet få lov til å stoppe flyten. Det er mindre glamorøst enn en agent som lover å gjøre alt. Ofte er det også mye mer nyttig.
Ofte stilte spørsmål
Kan Decision 3.0 skrive vanlige tekstsvar?
Nei. Modellfamilien er laget for strukturerte beslutninger, ikke fritekst. Den velger mellom oppgitte alternativer, svarer ja eller nei, eller gir en score. Til gjengjeld får du sannsynligheter som kan brukes direkte i routing, terskler og automatisering.
Kan Decision 3.0 kjøres lokalt?
Ja. Vektene er åpne under Apache-2.0 og kan lastes med Transformers eller serveres gjennom vLLM Semantic Router. Maskinvarebehovet varierer kraftig fra d3-edge på rundt 0,6B til d3 på 26,09B parametere, og de publiserte vektene er i BF16.
Hvilke typer input støtter modellen?
Decision 3.0 kan behandle tekst eller JSON sammen med flere bilder og videoer. Bilder leses med opptil 1,6 megapiksler hver. Video leses med to bilder per sekund og maksimalt 32 bilder totalt per klipp.
Er Decision 3.0 bedre enn en vanlig språkmodell?
Ikke generelt. Den er spesialisert for avgrensede beslutninger og kan være et bedre valg når du trenger fast format, sannsynligheter og lav svartid. For forklaringer, skriving og åpen problemløsning trenger du fortsatt en generativ språkmodell.