Innhold Vis
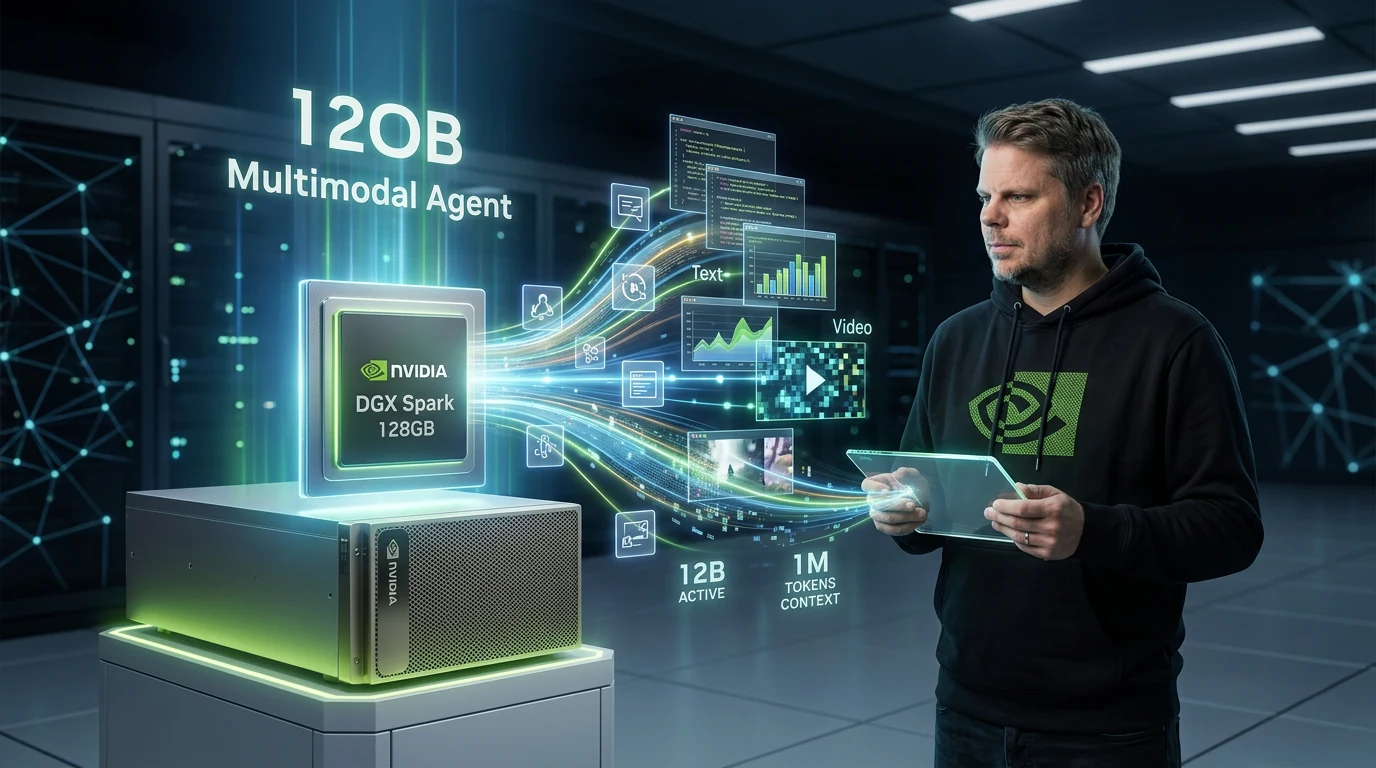
Hvis du vil kjøre en stor multimodal AI-agent på egen maskinvare, er Nemotron 3.5 Super VL en av de mer interessante modellutgivelsene akkurat nå. NVIDIA slapp modellen 15. oktober og har samlet tekst, bilder, dokumenter, video, koding og verktøybruk i én modell med 120 milliarder parametere – med en NVFP4-utgave som kan kjøres på én DGX Spark.
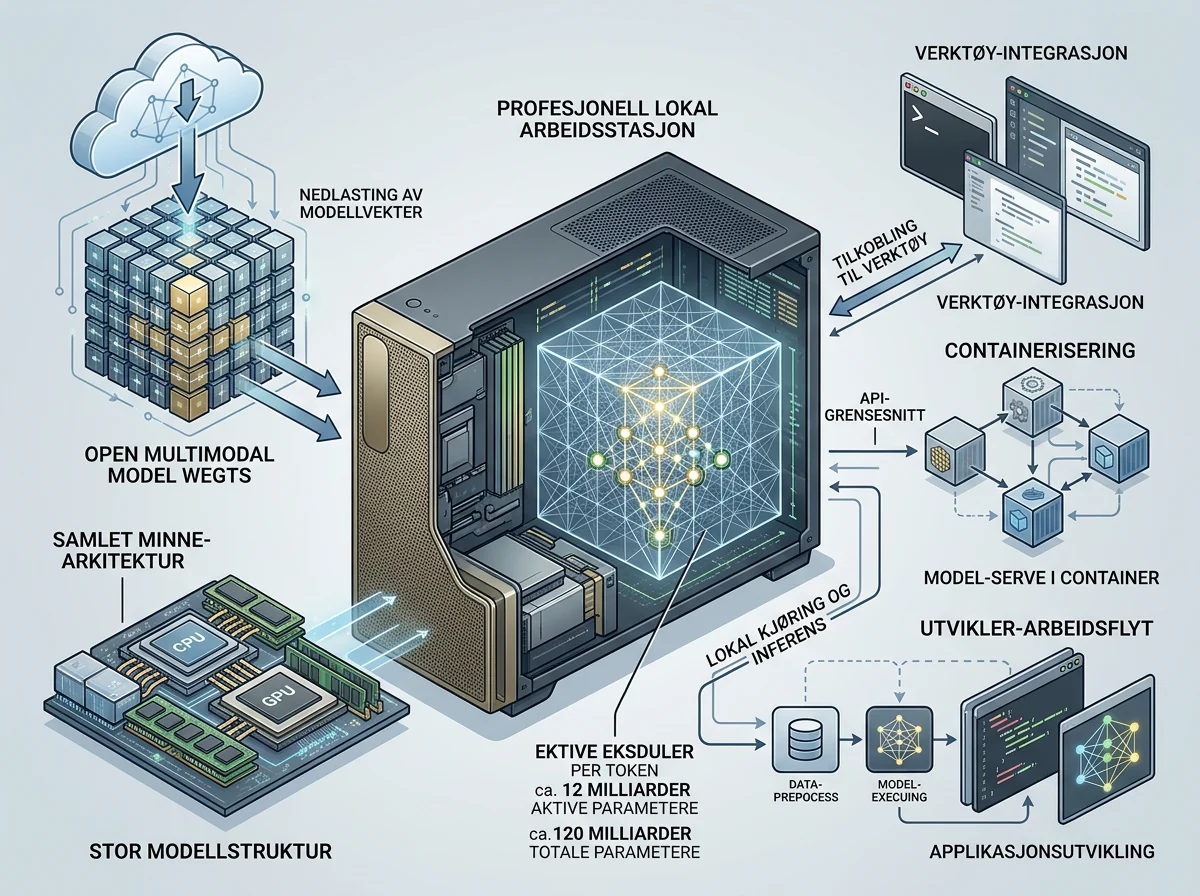
Det betyr ikke at en vanlig PC plutselig har fått plass til en 120B-modell. Oppskriften bruker utgaven av DGX Spark med 128 GB samlet minne. Men kombinasjonen av Mixture-of-Experts, 4-bit vekter og bare 12 milliarder aktive parametere per token gjør en modell i denne størrelsesklassen langt mer praktisk enn tallet 120B først får det til å høres ut.
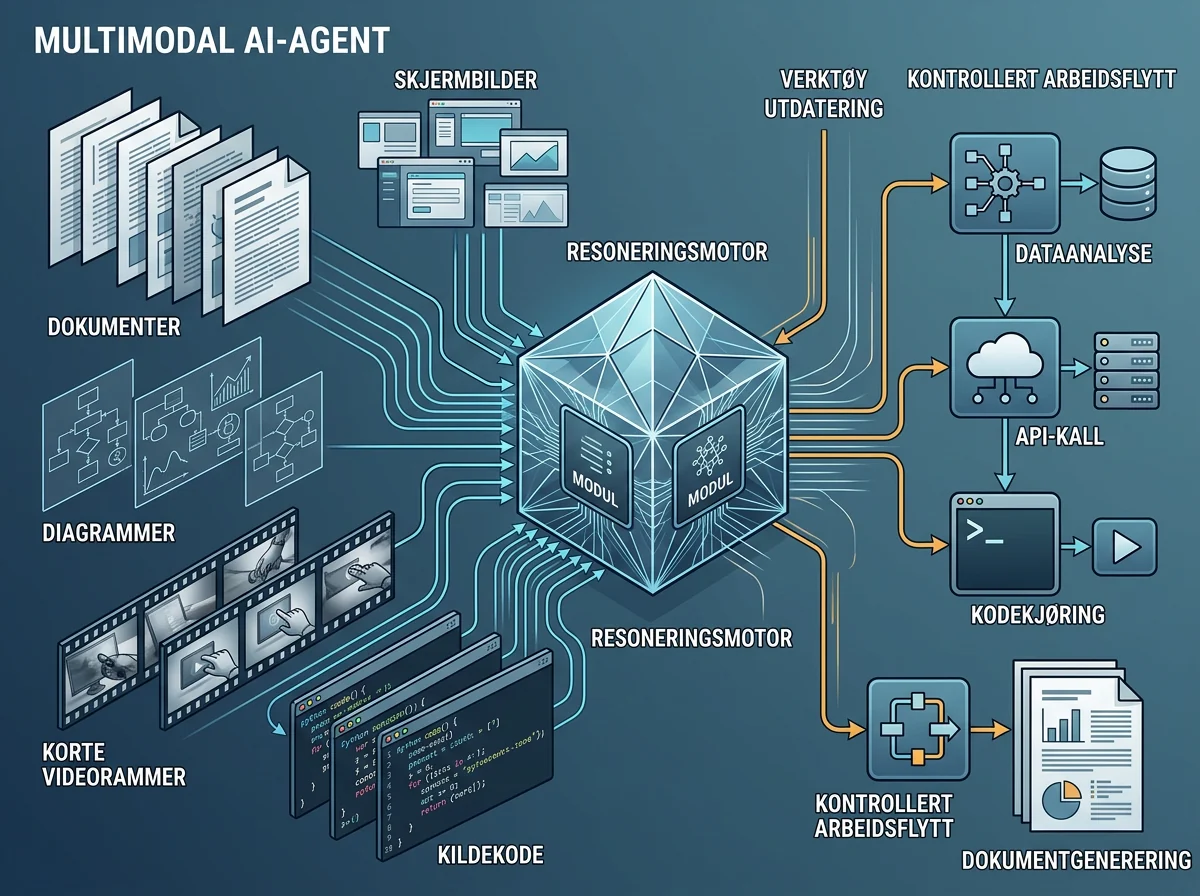
Det mest nyttige her er heller ikke enda en tabell med benchmark-poeng. Nemotron 3.5 Super VL er laget for agenter som må lese skjermbilder og dokumenter, forstå video, skrive kode og bruke verktøy gjennom lange arbeidsløp. Vektene kan lastes ned, modellen kan tilpasses, og NVIDIA har publisert oppskrifter for blant annet vLLM, SGLang og TensorRT-LLM.
Hva er Nemotron 3.5 Super VL?
Nemotron 3.5 Super VL er en åpen vision-language-modell med 120 milliarder parametere totalt og 12 milliarder aktive parametere per token. Ifølge NVIDIAs modellkort tar den imot tekst, bilder og video, leverer tekst, og støtter kontekstvinduer på opptil én million tokens.
VL står for vision-language. Det er viktig fordi en agent sjelden får alt servert som ren tekst. Den kan måtte lese en faktura, tolke et diagram, undersøke et skjermbilde, følge det som skjer i et videoklipp og deretter bruke et verktøy. NVIDIA forsøker å dekke hele denne kjeden med én modell i stedet for å sende synsoppgavene til en egen modell.
Modellen er også laget for reasoning, koding og tool calling. Du kan slå tenkemodus av og på gjennom chat-malen, og en mellominnstilling reduserer hvor mange reasoning-tokens modellen bruker. Det er et praktisk grep for agenter: Den trenger ikke bruke like mye tid og regnekraft på å lese en enkel verdi som på å feilsøke kode eller analysere et langt dokument.
Hvordan kan 120 milliarder parametere bli praktisk?
Svaret er at alle 120 milliardene ikke jobber samtidig. Nemotron 3.5 Super VL bruker en hybrid Mamba-Transformer-arkitektur med Mixture-of-Experts. Hvert MoE-lag har 512 rutede eksperter, men bare en del av dem aktiveres for hvert token. Resultatet er 120 milliarder parametere i hele modellen, mens omtrent 12 milliarder er aktive om gangen.
Dette gir modellen større samlet kapasitet uten at hvert svar må betale hele regningen i beregning. Samtidig må vektene fortsatt ligge tilgjengelig i minnet, så 12B aktiv betyr ikke at modellen har samme maskinvarekrav som en vanlig 12B-modell. Det er en viktig forskjell. MoE kutter arbeidet per token, men tryller ikke bort modellfilene.
NVIDIA kombinerer arkitekturen med NVFP4, et 4-bit format for Blackwell-maskinvare. Den kvantiserte utgaven er trent med quantization-aware distillation fra BF16-modellen for å hente tilbake kvalitet som ellers kan gå tapt ved så lav presisjon. På Blackwell brukes 4-bit vekter og aktiveringer, mens andre støttede plattformer kan bruke 4-bit vekter med 16-bit aktiveringer.
For fart har modellen både Multi-Token Prediction og LiLiCorr. I stedet for å lage ett token og begynne helt på nytt, foreslår en mindre drafter flere kommende tokens som hovedmodellen kontrollerer. NVIDIA oppgir opptil 2,3 ganger raskere tokengenerering med LiLiCorr på DGX Spark enn uten spekulativ dekoding. Det er leverandørens tall, men teknikken er høyst relevant når én agentoppgave krever mange modellkall.
Kan modellen virkelig kjøre på én DGX Spark?
Ja, NVFP4-utgaven har en offisiell oppskrift for én DGX Spark med GB10 og 128 GB samlet minne. Modellkortet oppgir også én H200, to H100 eller én GB200 som støttede oppsett. Det er altså en reell enkeltmaskin-distribusjon, ikke «lokal» i betydningen et rack fullt av servere i rommet ved siden av.
Likevel er overskriften lett å lese for optimistisk. Én DGX Spark er spesialisert maskinvare, og NVIDIAs anbefalte vLLM-oppsett der er konfigurert med én samtidig sekvens og 75 prosent GPU-minneutnyttelse. Oppskriften bruker dessuten bestemte vLLM-versjoner, egen LiLiCorr-drafter, FlashInfer for Mamba og en rekke cache-innstillinger. Dette er mer gjennomarbeidet enn et enslig modellkort, men heller ikke en modell du bare drar inn i et tilfeldig skrivebordsprogram og glemmer.
Én million tokens krever likevel et forbehold. NVIDIAs oppdaterte distribusjonstabell oppgir opptil én million tokens på én DGX Spark med vLLM for tekst og bilder. De eksplisitte millionoppsettene med video er oppgitt for én H200, to H100 eller én GB200. Du bør derfor kontrollere modaliteter, minnebruk, cache og faktisk arbeidslast før du planlegger rundt hele vinduet.
Dette skillet er ikke flisespikkeri. Lang kontekst spiser minne, og multimodale innspill legger på mer arbeid. Modellkortet anbefaler korte MP4-klipp på ett til to minutter og beskriver egne grenser for antall bilder, videorammer og samtidige forespørsler. Kapasiteten er imponerende, men den er ikke gratis.
Hva kan en multimodal agent bruke den til?
Nemotron 3.5 Super VL er først og fremst laget for arbeidsflyter der modellen må kombinere flere typer informasjon og faktisk gjøre noe med den. Det kan være å lese en bunke fakturaer, finne avvik i et dashboard, sammenligne dem med interne regler og foreslå en handling som et menneske godkjenner. Andre nærliggende oppgaver er kodeagenter, dokumentsøk, visuell feilsøking og undersøkelser på tvers av flere kilder.
Her er samlingen av egenskaper mer interessant enn hvert enkelt benchmark. En agent som kan lese dokumentet, tolke diagrammet og kalle riktig verktøy slipper overleveringer mellom flere modeller. Færre overleveringer betyr færre formater som kan ryke, færre separate prompts og mindre limkode. Om modellen er pålitelig nok gjennom lange løp, må fortsatt vises i praksis.
NVIDIA har publisert et eget sett med oppskrifter for Nemotron 3.5 Super VL. Der ligger eksempler for distribusjon, LoRA-tilpasning, multimodal reinforcement learning og en visuell undersøkelsesagent. Det gjør utgivelsen mer anvendelig enn en modell som kommer med vekter og en README som i praksis sier «lykke til».
Dette passer inn i utviklingen jeg har fulgt rundt NVIDIA en stund. Selskapet bygger ikke bare brikker, men stadig mer av laget over dem. NemoClaw viser den samme bevegelsen mot en komplett agentplattform, mens AI-Q viser hvordan NVIDIA pakker modellene inn i ferdige agentoppskrifter. Det henger også sammen med NVIDIAs store satsing på egne open-weight-modeller. Nemotron 3.5 Super VL gir selskapet en multimodal grunnmodell midt i denne stakken.
Hvor åpen er Nemotron 3.5 Super VL?
Vektene er tilgjengelige i BF16 og NVFP4, og NVIDIA har også publisert base- og post-trente checkpoints, treningsoppskrifter, datasett og miljøer for reinforcement learning. Den ferdige modellen er lisensiert under OpenMDW 1.1 og er ifølge modellkortet klar for kommersiell og ikke-kommersiell bruk.
Det er mer åpent enn et API du bare får lov til å ringe, men «åpen» bør fortsatt leses sammen med den faktiske lisensen. OpenMDW 1.1 er ikke det samme som Apache 2.0. Skal modellen bygges inn i et produkt eller brukes på kundedata, må vilkårene og sikkerhetskravene vurderes konkret. Et adjektiv i en lansering erstatter aldri den jobben.
For utviklere er den praktiske gevinsten likevel tydelig: Du kan laste ned modellen, kjøre den i eget miljø og tilpasse den med SFT, LoRA eller reinforcement learning. NVIDIA oppgir støtte gjennom vLLM, SGLang og TensorRT-LLM, i tillegg til NIM og Dynamo for mer omfattende produksjonsoppsett. Det finnes også tilgang via OpenRouter for dem som vil prøve modellen uten å sette opp maskinvaren først.
Hva sier testresultatene – og hva sier de ikke?
NVIDIAs egne tall viser at NVFP4-utgaven ligger svært nær BF16 på mange av testene. På SWE-bench Verified oppgis 71,07 mot 71,10, mens Terminal-Bench 2.1 faktisk er høyere for NVFP4 med 62,78 mot 60,67. På MMLU-ProX faller den kvantiserte modellen derimot fra 76,91 til 73,76. Lavere presisjon er altså ikke gratis på alle områder.
Det tydeligste varselsignalet i modellkortet er tau3-bench banking, der NVFP4 scorer 17,78. Den testen forsøker å måle langvarige agentoppgaver i bankscenarier. Ett svakt benchmark avgjør ikke hele modellen, men det minner oss om at god resonnering, rask kode og sterke dokumenttester ikke automatisk gir en agent som holder kursen gjennom kompliserte arbeidsflyter.
NVIDIA hevder opptil fem ganger høyere gjennomstrømning enn andre åpne modeller i samme størrelsesklasse. Sammenligningen er interessant, men den kommer fra leverandøren og avhenger av maskinvare, endpoint, inputlengde og testoppsett. Modellen er dessuten destillert fra Nemotron 3 Ultra, NVIDIAs langt større 550B-modell. Jeg har ikke testet Nemotron 3.5 Super VL selv. Derfor er dette en kildebasert vurdering av utgivelsen, ikke en dom over hvordan modellen oppfører seg i et ekte prosjekt.
Det jeg vil se videre, er uavhengige tester av verktøybruk, lange agentløp, multimodale dokumenter og stabilitet på DGX Spark. Jeg vil også se hvor langt kontekstvinduet kan presses på én maskin før fart og minnebruk gjør teorien lite nyttig. En million tokens på modellkortet og en million tokens i en arbeidsflyt du faktisk vil betale for, er to forskjellige ting.
Hva betyr de to Bolt-modellene?
Lanseringen omfatter også to mindre Nemotron 3.5 Bolt-varianter for lokal og innebygd bruk. Bolt 74B-A9B aktiverer 9 milliarder av totalt 74 milliarder parametere og bruker 2-bit kvantisering for å passe i 24 GB minne. Bolt E4B kommer 23. oktober som en 4 GB-modell rettet mot blant annet stemmeassistenter og innebygde agenter.
Bolt 74B er derfor den mer realistiske modellen for en kraftig arbeidsstasjon med 24 GB VRAM, mens Super VL retter seg mot DGX Spark og datasenterkort. Det er en fornuftig familie: samme retning, men ulike maskinvareklasser. En egen lokal modell kan håndtere enklere agentoppgaver, mens den større modellen tar dokumenttunge og multimodale jobber.
Jeg ville likevel ikke blandet modellene sammen. At Bolt får plass i 24 GB sier ingenting om at Super VL gjør det, og ytelse eller kvalitet fra den ene kan ikke overføres til den andre. NVIDIAs NVFP4-arbeid med Qwen3.6-27B viste allerede hvor viktig riktig maskinvare og runtime er. Nemotron-familien gjør samme spørsmål enda mer aktuelt.
Er dette en modell du bør bruke?
Har du tilgang til DGX Spark, H200, H100 eller GB200 og bygger multimodale agenter, bør Nemotron 3.5 Super VL inn på listen over modeller som skal vurderes. Den kombinerer stor total kapasitet, forholdsvis lav aktiv parameterbruk og et uvanlig komplett sett med checkpoints og oppskrifter. Det er et bedre utgangspunkt enn en pen demo uten vei til egen drift.
For vanlige lokale AI-brukere er Bolt 74B den mer relevante utgivelsen. Super VL er lokal i profesjonell forstand, ikke lettvektslokal. Du trenger ikke avskrive modellen av den grunn, men du bør heller ikke kjøpe maskinvare bare fordi «én GPU» står i overskriften. Se på minne, kontekst, runtime og arbeidslast samlet.
Min foreløpige dom er derfor forsiktig positiv: NVIDIA har gjort en 120B multimodal agentmodell overraskende kjørbar og gitt utviklere en reell vei fra nedlastbare vekter til tilpasning og distribusjon. Nå må uavhengige tester vise om kvaliteten og stabiliteten holder gjennom de lange arbeidsløpene modellen er laget for. Det er der en agentmodell enten blir et verktøy – eller bare en svært stor chatbot med mange fine tall.
Ofte stilte spørsmål
Hvor mye minne trenger Nemotron 3.5 Super VL?
NVFP4-utgaven har en offisiell oppskrift for DGX Spark med 128 GB samlet minne. NVIDIA oppgir også én H200, to H100 eller én GB200. Cache, kontekst, runtime og multimodale innspill bruker minne i tillegg til selve modellen.
Er Nemotron 3.5 Super VL gratis å laste ned?
Ja, modellvektene kan lastes ned fra Hugging Face. Bruken styres av OpenMDW 1.1, og modellen er oppgitt for både kommersiell og ikke-kommersiell bruk. Les likevel lisensen før den bygges inn i et produkt eller brukes i en kundeleveranse.
Kan modellen analysere både bilder og video?
Ja. Modellen tar imot tekst, bilder og video og svarer med tekst. NVIDIAs serveroppskrifter har egne innstillinger for bilder, videorammer og bildefrekvens. Modellkortet anbefaler å starte med korte MP4-klipp på ett til to minutter.
Er én million tokens tilgjengelig på DGX Spark?
Ja, NVIDIAs distribusjonstabell oppgir opptil én million tokens med vLLM på én DGX Spark for tekst og bilder. De eksplisitte millionoppsettene med video bruker H200, to H100 eller GB200. Kontroller likevel minnebruk, cache og ønsket fart i din arbeidslast.