Innhold Vis
EmbeddingGemma 2 er en åpen embedding-modell som lar deg søke på tvers av tekst, kode, bilder, video og lyd – lokalt, i ett felles vektorrom og uten å sende alt til en skytjeneste.
Det er akkurat denne typen lokale AI-modeller jeg blir begeistret for. Ikke fordi 740 millioner parametere ser pent ut i en overskrift, men fordi modellen løser en konkret floke: En tekstbeskrivelse kan finne riktig bilde, et lydopptak kan finne riktig del av en video, og kode kan søkes etter mening i stedet for bare filnavn og nøkkelord.
Google DeepMind lanserte modellen 6. oktober 2026 under Apache 2.0-lisensen. Du kan laste hele modellen eller bare delene du trenger. Dermed kan samme modellfamilie spenne fra et tekst- og kodeoppsett på 270 millioner parametere til full multimodal bruk på 740 millioner.
Hva er EmbeddingGemma 2?
EmbeddingGemma 2 er en modell bygget på Gemma 4 som gjør tekst, kode, bilder, video og lyd om til vektorer med 768 dimensjoner. Ifølge Googles offisielle modellkort støtter den mer enn 100 språk og har et kontekstvindu på 8 192 tokens.
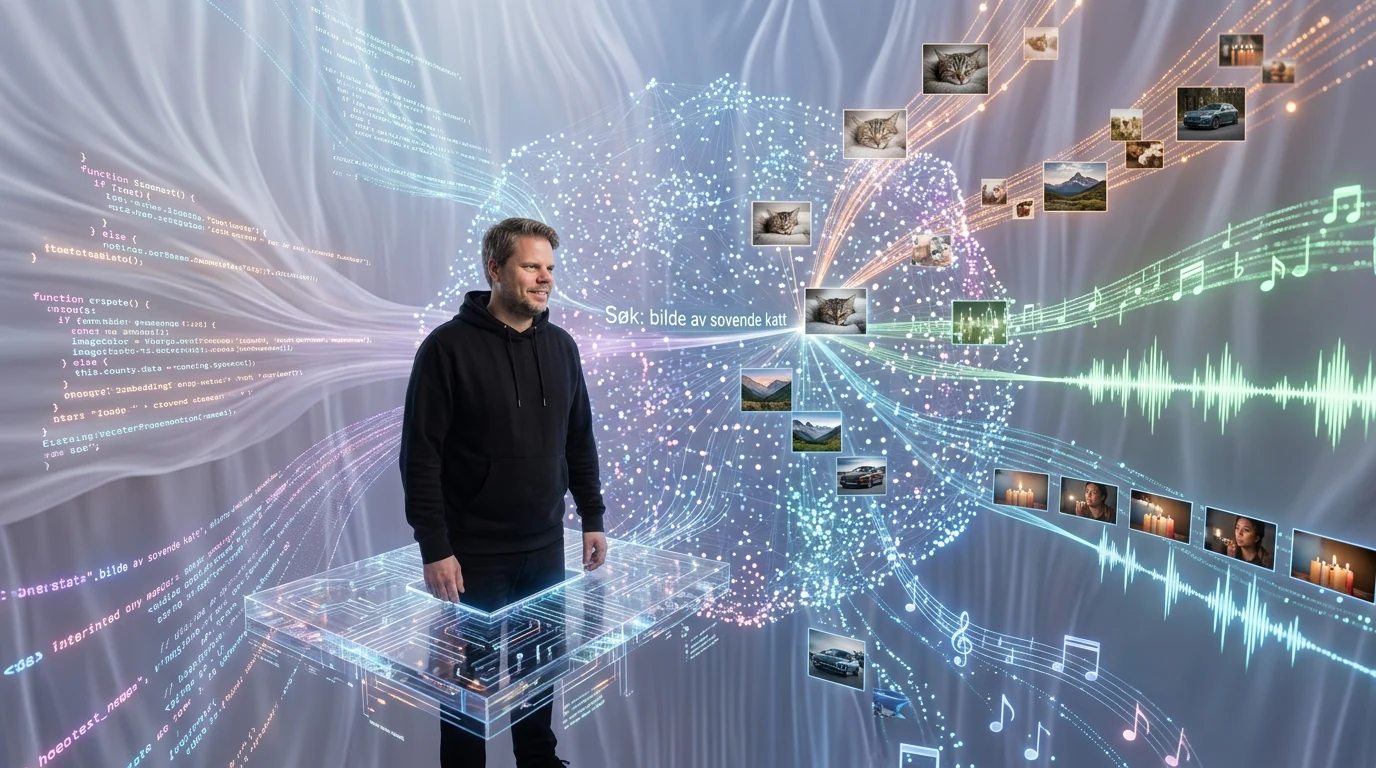
En embedding er en tallrepresentasjon av mening. Innhold som ligner hverandre, havner nær hverandre i vektorrommet. Det gjør det mulig å finne et bilde av en sovende katt med et tekstsøk, hente riktig kodebit fra en stor kodebase eller finne øyeblikket i en video der noen blåser ut lysene på en kake.
Modellen genererer altså ikke svaret slik en vanlig chatbot gjør. Den finner, sorterer, grupperer og kobler sammen innhold. Det er grunnmuren i semantisk søk, klassifisering og RAG, der en språkmodell først får hentet relevant kunnskap før den svarer. Forskjellen her er at kunnskapen ikke lenger må være ren tekst.
Hvorfor er ett felles vektorrom så nyttig?
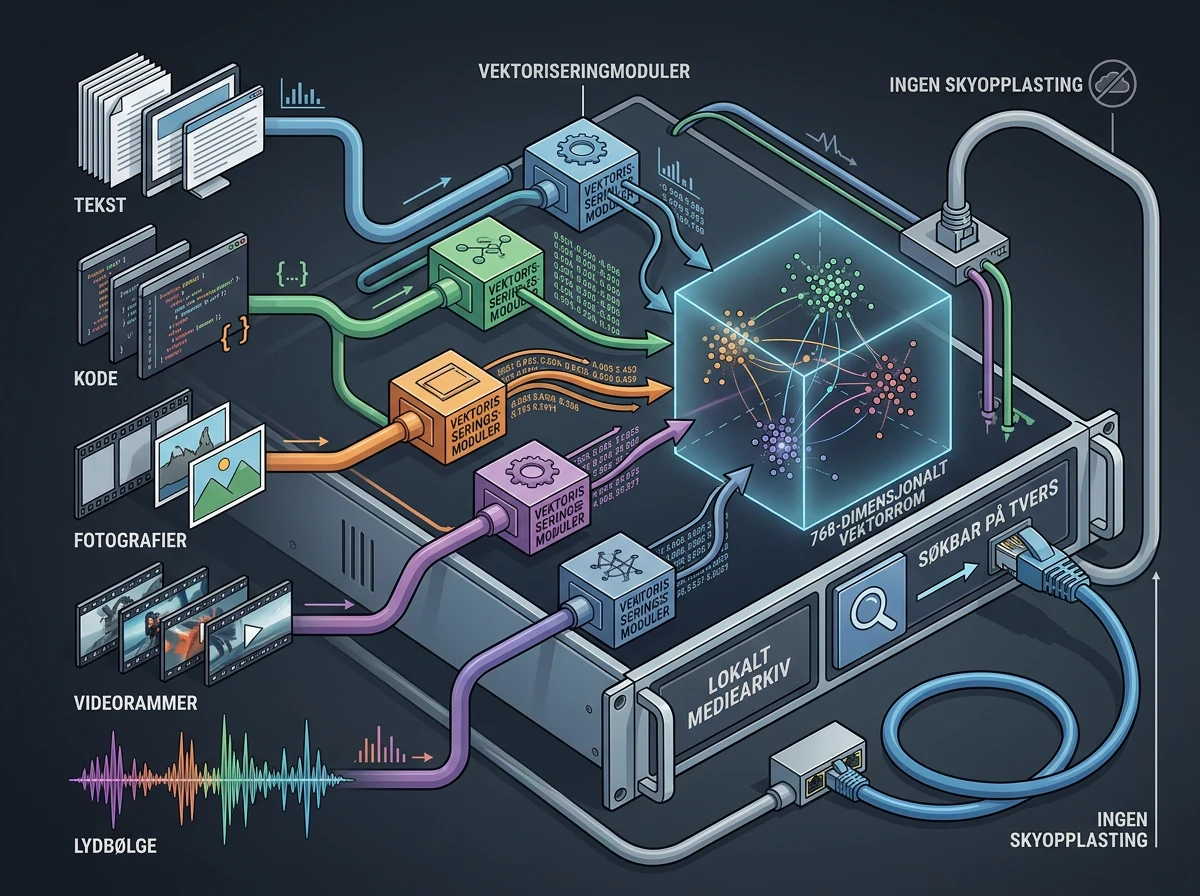
Alle de fem innholdstypene ender i det samme 768-dimensjonale rommet. Det betyr at en tekstspørring kan sammenlignes direkte med en bilde-, video- eller lydvektor, uten at du først må gjøre mediet om til en tekstbeskrivelse. Det kutter både kompleksitet og flere mulige feilkilder i søkekjeden.
Tenk på et lokalt mediearkiv. Den vanlige løsningen kan kreve tale-til-tekst for lyd, bildetekster for fotografier, transkripsjon for video og en egen embedding-modell for teksten som kommer ut. Hvert ekstra ledd bruker tid, minne og kan miste detaljer. EmbeddingGemma 2 kan i stedet plassere originalinnholdet direkte i samme søkbare system.
Google viser dette med lokal mediesøk og søk etter bestemte øyeblikk i video. En mobil kan indeksere bilder og videoklipp på enheten, lagre vektorene i en lokal SQLite-database og rangere treff med cosinuslikhet. Google AI Edge beskriver også hvordan søket kan oppdateres mens brukeren skriver, uten nettilkobling.
Dette er et klart steg videre fra en ren tekstmodell. Googles skybaserte Gemini Embedding 2 samlet også flere medietyper i ett vektorrom, men EmbeddingGemma 2 flytter den samme grunnideen ned på vanlig maskinvare med nedlastbare vekter og en lisens som faktisk gir rom for å bygge.
Hvor liten er modellen i praksis?
Fullversjonen har 740 millioner parametere: 270 millioner for tekst og kode, 170 millioner for syn og 300 millioner for lyd. Googles utviklerguide oppgir fire oppsett på 270M, 440M, 570M og 740M i samme vektorrom, avhengig av hvilke encodere som lastes.
Trenger du bare å søke i dokumenter og kode, laster du 270M-delen. Tekst, bilder og video krever 440M. Tekst og lyd bruker 570M, mens hele pakken på 740M dekker alt. Det smarte er at oppsettene fortsatt skriver til det samme vektorrommet. En spørring fra den lille tekstvarianten kan derfor sammenlignes med innhold som tidligere ble indeksert av fullmodellen.
Google målte omtrent 191 MB aktivt RAM for tekstvarianten og 567 MB for hele modellen på en Pixel 11 Pro med kvantiserte vekter. Det er leverandørens tall på én bestemt telefon, ikke et løfte om identisk minnebruk overalt. Men størrelsesordenen er poenget: Dette er laget for mobiler og bærbare maskiner, ikke bare en GPU-server i et datasenter.
Gemma 4-familien har allerede vist hvor mye som kan flyttes lokalt. Jeg har tidligere skrevet om Gemma 4 12B som lokal multimodal modell på en vanlig laptop. EmbeddingGemma 2 er langt mindre fordi den har en smalere jobb: Den skal representere og finne innhold, ikke skrive lange svar.
Kan du redusere lagringsbehovet?
Ja. Modellen støtter Matryoshka-trening, slik at vektoren kan kuttes fra 768 til 512, 256 eller 128 dimensjoner. Ved 128 dimensjoner bruker hver vektor en sjettedel av plassen, mens Google oppgir at 256 dimensjoner beholder omtrent 95 prosent av full kvalitet på bilde-, video- og talesøk.
Det kan bli en stor forskjell når millioner av dokumenter, bilder eller videosegmenter skal lagres. Kortere vektorer tar mindre plass, flyttes raskere gjennom minnet og gjør sammenligningen billigere. Du trenger derfor ikke betale lagringskostnaden for 768 dimensjoner hvis arbeidsflyten fungerer nesten like godt med 256.
Her finnes det en viktig teknisk felle. Etter at en vektor er kuttet, må den normaliseres på nytt før cosinuslikhet beregnes. Modellkortet advarer om at manglende L2-normalisering ikke nødvendigvis gir en feilmelding – du får bare dårligere rangering med tall som fortsatt ser troverdige ut. Spørringer og dokumenter må dessuten bruke samme dimensjon.
Hva betyr modellen for lokal RAG?
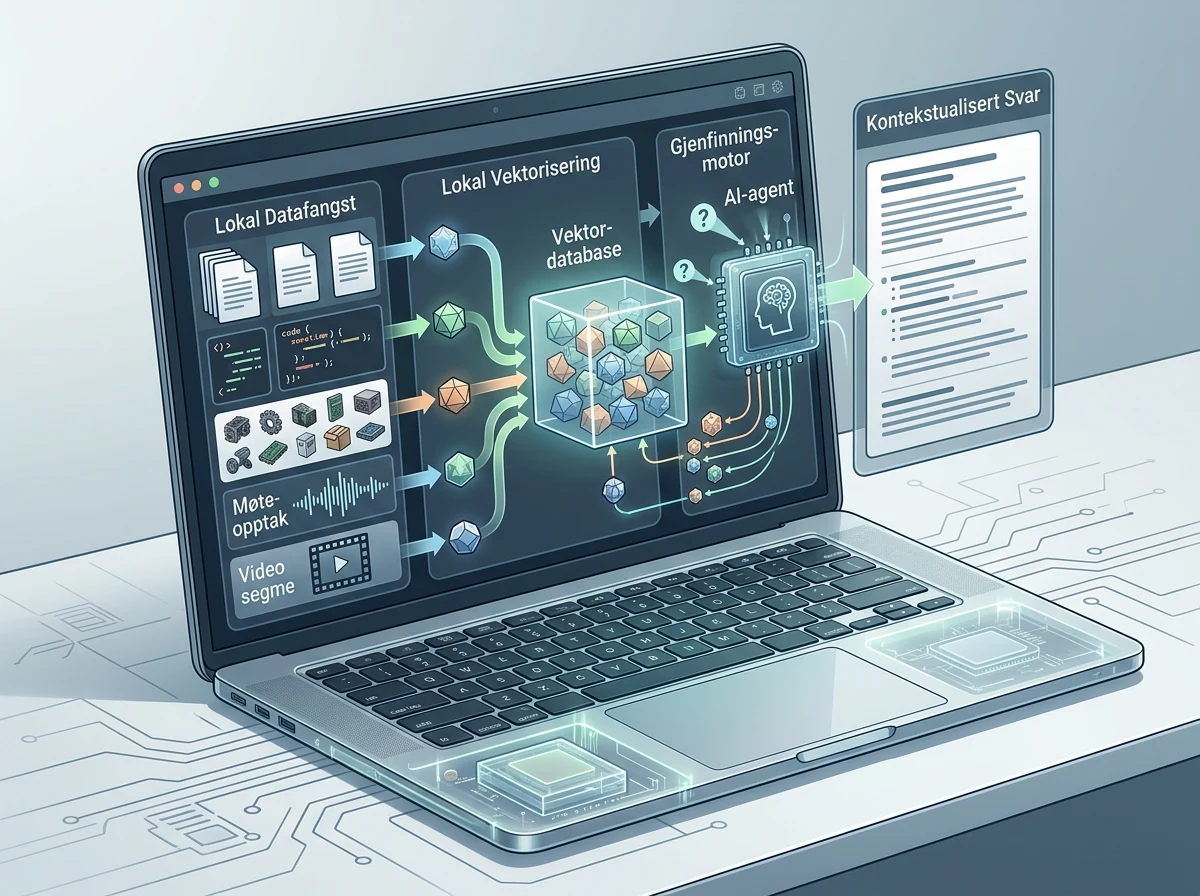
EmbeddingGemma 2 gjør lokal RAG bredere enn dokumenter og PDF-er. Med ett kontekstvindu på 8 192 tokens kan modellen håndtere omtrent 29 bilder, 58 videorammer eller 327 sekunder lyd når én medietype bruker hele budsjettet, basert på standardinnstillingene i modellkortet.
Det åpner for en privat kunnskapsbase som også forstår møter, produktbilder, skjermopptak, presentasjoner og video. En servicetekniker kan søke med et bilde av en del og finne riktig avsnitt i en håndbok. En utvikleragent kan koble en naturlig formulert feilbeskrivelse til relevant kode. En lokal app kan finne bestemte øyeblikk i egne videoer uten å laste opp hele arkivet.
Det er også her Apache 2.0-lisensen betyr noe. Da Google lanserte Gemma 4 med Apache 2.0, forsvant mye av lisensusikkerheten som ofte følger åpne modellvekter. EmbeddingGemma 2 arver ikke bare arkitekturen, men også en lisens som gjør kommersiell bruk, tilpasning og distribusjon langt enklere å planlegge rundt.
Hva bør du passe på når du bygger?
Bruk riktig oppgaveprefix for tekst. Modellen har egne instrukser for blant annet søk, spørsmål og svar, faktasjekk, klassifisering og kodegjenfinning. Googles eksempel bruker SearchQuery for spørringen og Document for dokumentet. Uten riktig prefix virker modellen fortsatt, men presisjonen kan bli dårligere.
Hele installasjonen kan startes med sentence-transformers versjon 6.1.0 eller nyere. Full multimodal støtte installeres med pip install -U "sentence-transformers[image,audio,video]" transformers, og modell-ID-en er google/embeddinggemma-2. Har du bare tekst, bør du deaktivere både syns- og lydkonfigurasjonen i stedet for å laste 470 millioner parametere du aldri bruker.
Kontekstvinduet deles mellom alle medietypene. Ett bilde bruker som standard 280 tokens, en videoramme 140 tokens og ett sekund lyd 25 tokens. Blander du tekst, bilder og lyd i samme input, spiser alt av de samme 8 192 tokenene. Video samles som standard med ett bilde per sekund, mens lyd bør leveres som mono i 16 kHz.
En teknisk felle til: Ikke kjør modellen i float16. Det offisielle modellkortet advarer om at aktiveringsområdet kan gi NaN-verdier eller embeddings som blir stille dårligere uten feilmelding. Bruk bfloat16 på maskinvare som støtter det, og float32 ellers.
Og så må du teste på egne data. Google viser sterke resultater, blant annet omtrent 14 prosent forbedring fra EmbeddingGemma 1 på kodeoppgaver. Det er likevel Googles egne evalueringer. Treffkvaliteten på norske fagtekster, rotete mobilbilder, dialekt i lyd og kodebasen din avgjøres ikke av en pen samlet poengsum.
Er EmbeddingGemma 2 verdt å prøve?
Ja – særlig hvis du bygger lokalt søk, RAG eller en agent som må finne fram i mer enn tekst. Modellen er tilgjengelig nå, vektene har Apache 2.0-lisens, og du kan starte med 270 millioner parametere i stedet for å dra inn hele 740M-pakken.
Jeg ville begynt med den minste konfigurasjonen som faktisk dekker jobben, beholdt 768 dimensjoner i en liten fasittest og deretter sammenlignet 512, 256 og 128. Mål treffene du bryr deg om. Hvis 256 dimensjoner gir samme nyttige toppresultater, kan du kutte lagring og søkekostnad før databasen vokser seg stor.
Det mest spennende er hvor lite drama som trengs for å få nytten. Ingen enorm modell, ingen obligatorisk skytjeneste og ingen kjede av separate modeller bare for å gjøre video eller lyd søkbar. EmbeddingGemma 2 er en liten, åpen byggekloss som gjør fem typer innhold sammenlignbare lokalt. Det er sånt jeg vil se mer av.
Ofte stilte spørsmål
Kan EmbeddingGemma 2 brukes kommersielt?
Ja. EmbeddingGemma 2 er publisert under Apache 2.0-lisensen, som tillater kommersiell bruk, endring og distribusjon så lenge lisensvilkårene og nødvendige merknader følges. Kontroller likevel lisensen for resten av datasettet, applikasjonen og modellkjeden du bygger.
Må hele modellen på 740 millioner parametere lastes?
Nei. Tekst og kode bruker 270M-oppsettet. Tekst med bilder og video bruker 440M, mens tekst med lyd bruker 570M. Fullversjonen på 740M trengs når både syns- og lydencoderen skal være tilgjengelig.
Kan modellen søke i bilder med en tekstbeskrivelse?
Ja. Tekst og bilder plasseres i det samme 768-dimensjonale vektorrommet. Dermed kan en tekstspørring rangeres direkte mot bildevektorer. Det samme prinsippet gjelder video og lyd, uten at alt først må gjøres om til tekst.
Fungerer EmbeddingGemma 2 uten internett?
Ja. Når modellvektene og nødvendige biblioteker er lastet ned, kan embedding og søk kjøres lokalt. Google har laget modellen for enheter som mobiler og bærbare maskiner, men faktisk fart og minnebruk avhenger av maskinvare, kvantisering og valgte encodere.