Innhold Vis
Mistral Large 4 er en ny multimodal AI-modell med omtrent én billion parametre, én million tokens kontekst og åpne vekter på vei. For deg som vil bruke en kraftig modell uten å låse hele virksomheten til en amerikansk eller kinesisk leverandør, er dette en lansering det er verdt å følge.
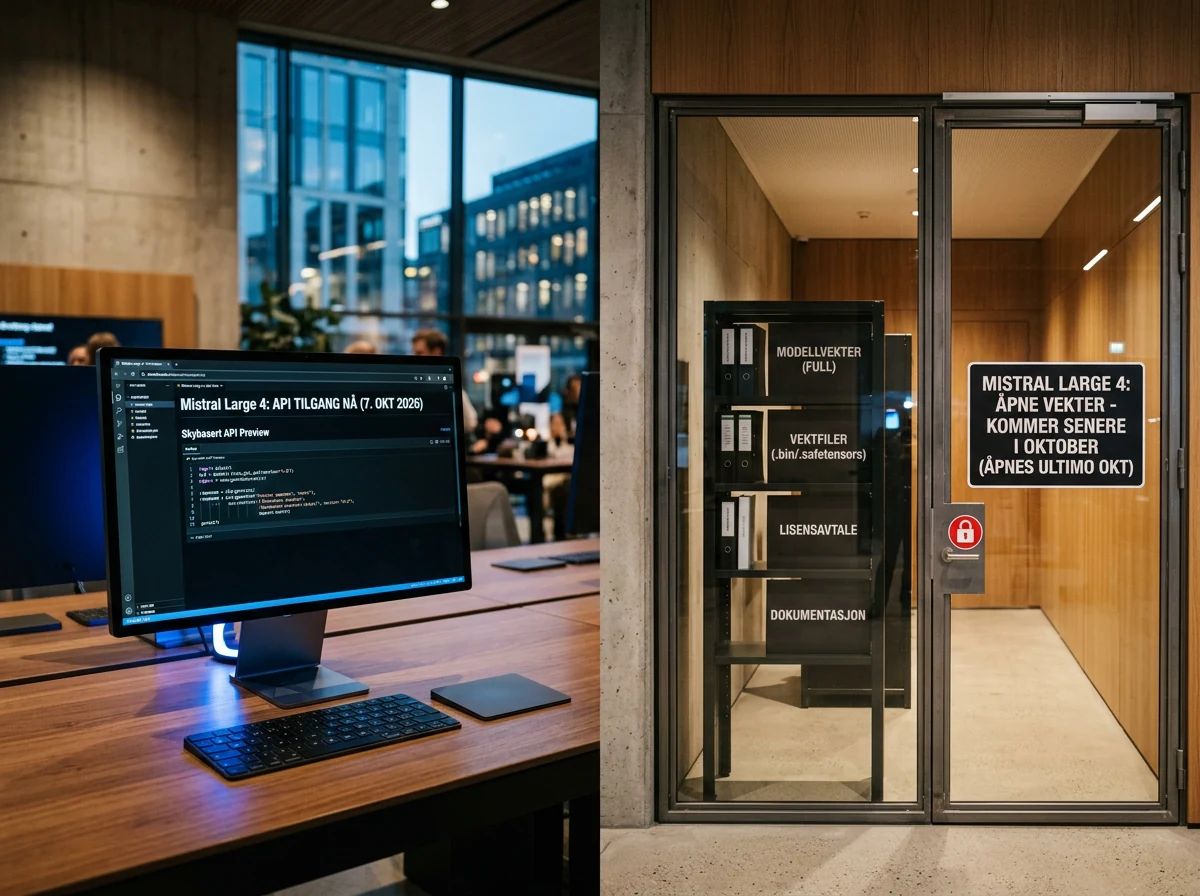
Den franske utvikleren Mistral AI har gjort modellen tilgjengelig som offentlig API-preview nå. Selve vektene skal etter planen slippes innen utgangen av oktober. Det siste skillet er viktig: Mistral Large 4 omtales som en open-weight-modell, men akkurat nå er det bare API-et du faktisk kan bruke.
Jeg synes likevel dette ser lovende ut. Ikke fordi Mistral har laget enda en pen resultatgraf, men fordi selskapet kombinerer multimodal forståelse, agentarbeid, koding og tung fagbruk i én modell som senere skal kunne kjøres under kundens egen kontroll. Hvis vektene, lisensen og den praktiske ytelsen holder det Mistral lover, får markedet et skikkelig europeisk alternativ i toppsjiktet.
Hva er Mistral Large 4?
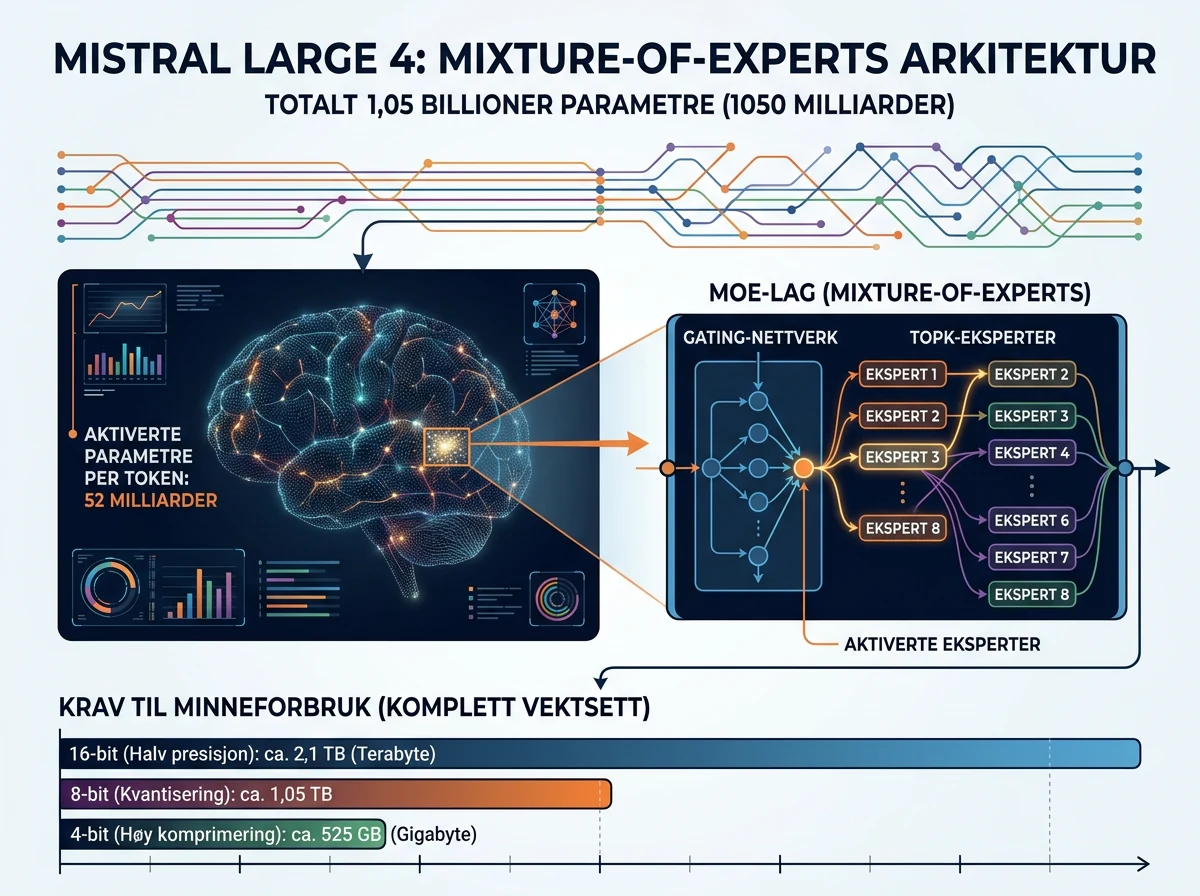
Mistral Large 4, eller ML4, er en generell multimodal Mixture-of-Experts-modell. Ifølge Mistrals modellkort har den 1,05 billioner parametre totalt, 52 milliarder aktive parametre og en egen vision encoder på 1,6 milliarder parametre. Lanseringsinnlegget oppgir samtidig 49 milliarder aktive parametre, så Mistral må rydde opp i det spriket. Modellen kan behandle tekst og bilder i samme arbeidsflyt.
Mixture-of-Experts betyr at hele billionmodellen ikke arbeider med hvert eneste token. Bare utvalgte deler aktiveres for den aktuelle oppgaven. Det gir en langt mer håndterbar beregningskostnad enn en tett modell med like mange totale parametre, samtidig som modellen kan romme mye spesialisert kapasitet.
Om det endelige tallet er 49 eller 52 milliarder, betyr aktive parametre likevel ikke at du kan laste ned bare den aktive delen og glemme resten. Hele vektsettet må være tilgjengelig. Som et svært grovt regnestykke tilsvarer 1,05 billioner parametre rundt 2,1 TB ved 16-bit, cirka 1,05 TB ved 8-bit og omtrent 525 GB ved 4-bit, før ekstra minne og teknisk overhead. Dette blir ikke en modell for én vanlig gaming-PC.
Kontekstvinduet er på én million tokens. Det åpner for store kodebaser, lange dokumentpakker og agentoppgaver som må holde styr på mye informasjon samtidig. Modellen støtter også blant annet function calling, structured outputs, Document QnA, batching og Mistrals Agents API. Det er langt mer relevant i praksis enn hvem som fikk et halvt poeng mer på en tilfeldig quiz.
Hvorfor er antallet aktive parametre viktig?
De aktive parameterne sier mer om beregningsarbeidet per token enn tallet på forsiden. ML4 har over én billion parametre tilgjengelig, men bruker ifølge modellkortet 52 milliarder om gangen. Mistrals eget lanseringsinnlegg sier 49 milliarder. Poenget med arkitekturen er uansett det samme: stor samlet kapasitet uten at hvert svar må gjennom hele beistet.
Dette kan gi bedre økonomi og fart i drift enn en tett billionmodell, men det er ingen garanti for at modellen blir billig eller enkel å kjøre selv. Minnebåndbredde, fordeling over flere GPU-er, kvantisering, batch-størrelse og programvarestøtte betyr mye. Før vektfilene og anbefalt inference-oppsett er publisert, vet vi ikke hva et realistisk lokalt oppsett vil kreve.
Mistral sier at modellen ble trent fra bunnen av på 3 800 Nvidia Grace Blackwell-GPU-er i selskapets egne europeiske datasentre. Det er et stort treningsoppsett, men fortsatt langt mindre enn de mest ekstreme klyngene hos de største amerikanske aktørene. TechCrunch runder tallet til 4 000 og omtaler Mistrals ressursbruk som to til tre ganger lavere enn hos enkelte kinesiske konkurrenter, basert på opplysninger fra selskapet.
Effektiv ressursbruk er bra, men den virkelige testen kommer i drift. Hvor mange GPU-er trengs for god svartid? Hva skjer med lange kontekster? Hvor mye taper modellen ved 4-bit kvantisering? Det er slike spørsmål som avgjør om åpne vekter blir et praktisk alternativ eller bare en imponerende nedlasting.
Hva kan modellen brukes til?
ML4 er laget for koding, agentbaserte arbeidsflyter, dokumentanalyse, bilder og krevende fagoppgaver. Mistrals lansering trekker særlig fram cybersikkerhet, finans, juridisk arbeid, vitenskap og tekniske tegninger. Modellen er trent med mye flerspråklig materiale fra over 160 språk, inkludert alle offisielle EU-språk.
For en vanlig bruker betyr multimodalitet at modellen kan lese diagrammer, dokumenter og bilder i tillegg til ren tekst. For en bedrift er koblingen mellom syn, verktøybruk og lange arbeidsløp mer spennende. En agent kan i prinsippet undersøke en stor dokumentpakke, hente inn data, bruke verktøy og levere et ferdig regneark eller en rapport uten å bytte modell underveis.
Cybersikkerhet er et spesielt interessant område. Mistral rapporterer 82 prosent på en test der modellen skal gjenskape en ekte sårbarhet i open source-programvare og deretter rette den. Selskapet peker samtidig på at enkelte lukkede modeller nesten ikke løser oppgaven fordi de avviser forespørselen. For forsvarere kan den forskjellen være helt avgjørende: Du får ikke verifisert og reparert et hull hvis assistenten nekter å se på det.
Men vi må holde tungen rett i munnen. Resultatene er publisert av Mistral i en lansering av Mistral. Noen målinger kommer fra eksterne evalueringsmiljøer, men modellen er fortsatt i preview, og full teknisk dokumentasjon er ikke ute. Jeg ville derfor brukt resultatene som et signal om hva som bør testes, ikke som et ferdig kjøpsbevis.
Er Mistral Large 4 virkelig åpen?
Ikke ennå. Per 7. oktober 2026 kan du bruke Mistral Large 4 gjennom API-et, mens vektene er lovet innen utgangen av måneden. Før filene faktisk er publisert, med lisens og dokumentasjon, er «åpne vekter» et løfte og ikke noe du kan bygge en lokal produksjonsløsning på.
Det er heller ikke det samme som open source i streng forstand. Åpne vekter gir deg normalt mulighet til å laste ned modellen, kjøre den selv, undersøke den og tilpasse den innenfor lisensvilkårene. Det betyr ikke automatisk at treningsdata, treningskode eller hele oppskriften blir offentlig. Lisensen avgjør dessuten hva du faktisk får lov til å gjøre kommersielt.
Dette er grunnen til at den kommende vektutgivelsen betyr mer enn enda en toppliste. Egen drift kan gi kontroll over hvor data behandles, hvilke sikkerhetsregler som gjelder og om en ekstern leverandør kan endre tilgang eller oppførsel midt i en kritisk hendelse. Mistral sier også at en betydelig del av modellen ble trent på materiale fra mer enn 160 språk. Det kan gjøre den relevant for europeiske virksomheter som ikke lever i en engelskspråklig demo.
Mistral har allerede vist at selskapet kan lage mindre modeller med en bred verktøykasse. Jeg skrev tidligere om Mistral Small 4 som samlet flere spesialistroller i én modell. ML4 tar den samme tanken opp i en helt annen vektklasse.
Hva koster API-et?
I lanseringsperioden viser modellkortet en pris på 0,68 dollar per million input-tokens og 2,09 dollar per million output-tokens. Med en dollarkurs på omtrent 9,60 kroner blir det cirka 6,50 kroner inn og 20 kroner ut per million tokens. Bufret input koster 0,07 dollar, eller rundt 67 øre per million tokens.
Modellsiden viser samtidig overstrøkne listepriser på 1,36 dollar for input, 0,14 dollar for bufret input og 4,18 dollar for output per million tokens – omtrent 13, 1,35 og 40 kroner med samme kurs. Jeg finner ingen oppgitt sluttdato for rabatten, så sjekk prissiden før du regner på et varig oppsett. Det er en aggressiv API-pris for en modell som vil konkurrere i toppsjiktet, men kvalitet per ferdig oppgave betyr mer enn pris per token.
Et billig svar som må kjøres tre ganger, kontrolleres manuelt og repareres etterpå er ikke billig. Test derfor modellen på dine egne dokumenter, kodebaser og arbeidsflyter. Mål om den fullfører oppgaven, hvor lang tid det tar, hvor ofte verktøykall feiler og hvor mye menneskelig opprydding som gjenstår.
Hvis du allerede vurderer Mistral-modeller, er det også verdt å sammenligne med den langt mindre Mistral Medium 3.5 med 128 milliarder parametre og 256 000 tokens kontekst. Den største modellen er ikke automatisk det klokeste valget. En mindre modell kan være både raskere, billigere og mer enn god nok.
Bør du ta modellen i bruk nå?
Bruk API-previewen nå hvis du har en konkret oppgave å måle. Vent med planer om lokal drift til Mistral faktisk har publisert vektene, lisensen, filformatene og anbefalt maskinvare. Det er den enkle og ærlige anbefalingen.
Lag et lite evalueringssett med ekte arbeid: vanskelige dokumenter, representative kodeoppgaver, norsk fagspråk og de verktøykallene agenten skal utføre. Sammenlign med modellen du bruker i dag. Logg kvalitet, feil, forsinkelser og samlet kostnad. Da finner du ut om ML4 er bedre for deg, ikke bare om Mistral har valgt hyggelige grafer.
For sensitiv bruk bør du også skille tydelig mellom dagens API-preview og framtidig egen drift. API-et kjører på Mistrals infrastruktur. Egen drift blir først mulig når vektene kommer, og da må du fortsatt kontrollere lisens, sikkerhet, logging og reelle maskinvarekrav før noe går i produksjon.
Mistral Large 4 fortjener oppmerksomhet fordi kombinasjonen er uvanlig: omtrent én billion parametre, multimodalitet, én million tokens kontekst, agentfunksjoner og et konkret løfte om åpne vekter samme måned. Jeg er forsiktig optimistisk. Men Mistral har ikke levert den viktigste delen før vektfilene ligger ute og andre kan teste dem utenfor selskapets egen scene.
Ofte stilte spørsmål
Kan jeg laste ned Mistral Large 4 nå?
Nei. Per 7. oktober 2026 er Mistral Large 4 tilgjengelig som offentlig API-preview. Mistral sier at de åpne vektene skal publiseres innen utgangen av oktober. Vent på selve utgivelsen, lisensen og maskinvarekravene før du planlegger lokal drift.
Kan Mistral Large 4 kjøre på én vanlig GPU?
Det er svært lite sannsynlig. Modellen har 1,05 billioner parametre totalt, mens Mistrals egne sider oppgir 49 eller 52 milliarder aktive parametre. Et grovt 4-bit-regnestykke gir rundt 525 GB bare til vektene, før teknisk overhead. Praktiske krav blir klarere når vektfilene og inference-oppsettet publiseres.
Støtter Mistral Large 4 bilder og lange dokumenter?
Ja. Modellen er nativt multimodal, har en vision encoder på 1,6 milliarder parametre og et kontekstvindu på én million tokens. Den støtter også Document QnA, function calling og structured outputs, noe som gjør den aktuell for dokumentanalyse og agentbaserte arbeidsflyter.
Er Mistral Large 4 bedre enn GPT og Claude?
Det er for tidlig å slå fast. Mistral viser sterke resultater i blant annet cybersikkerhet, agentarbeid og visuell analyse, men modellen er fortsatt i preview og mye av dokumentasjonen kommer fra leverandøren. Test den mot egne oppgaver før du trekker en praktisk konklusjon.