Innhold Vis
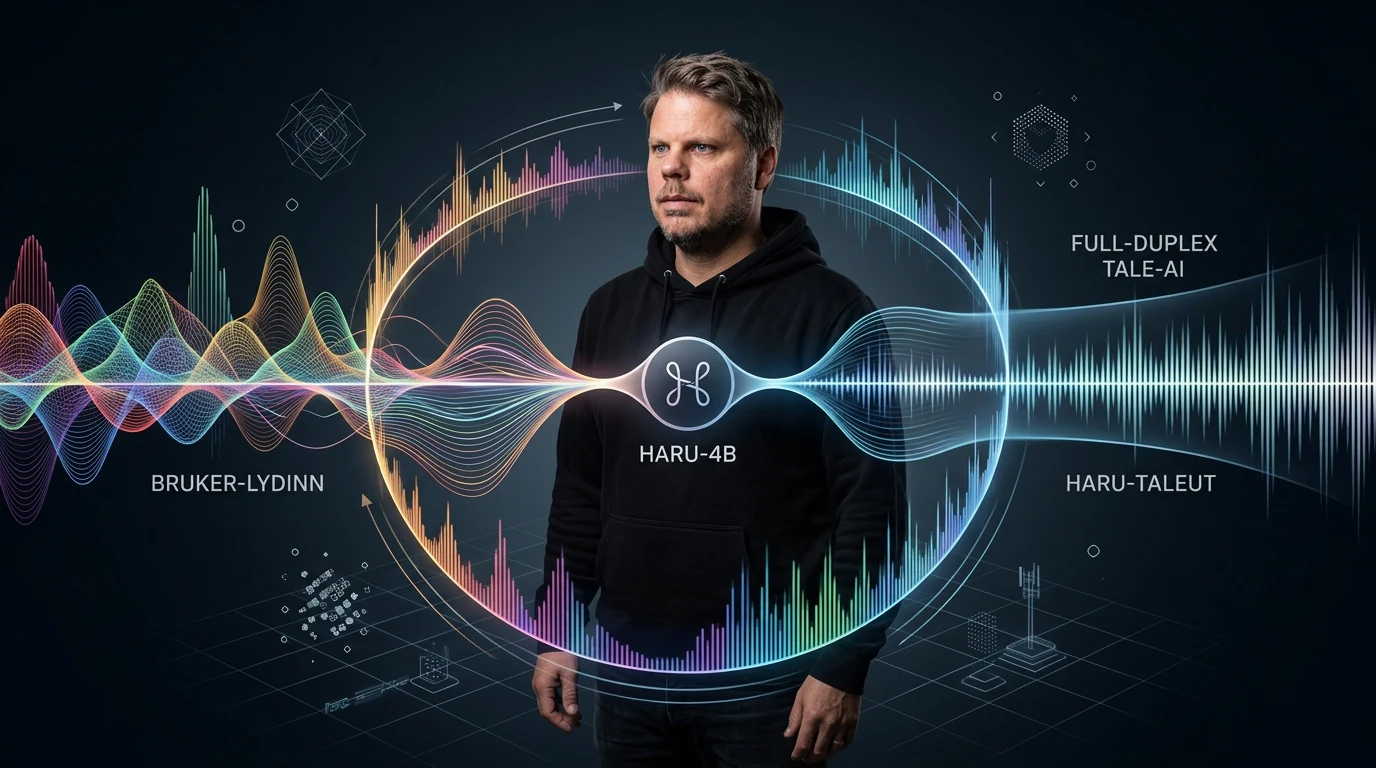
Haru-4B kan lytte og snakke samtidig, og det kan gi stemme-AI en langt mer naturlig samtalerytme. Modellen trenger ikke behandle hele samtalen som en stiv stafett der mennesket snakker ferdig, maskinen tenker og svaret først begynner etterpå. Lytting og tale kan overlappe.
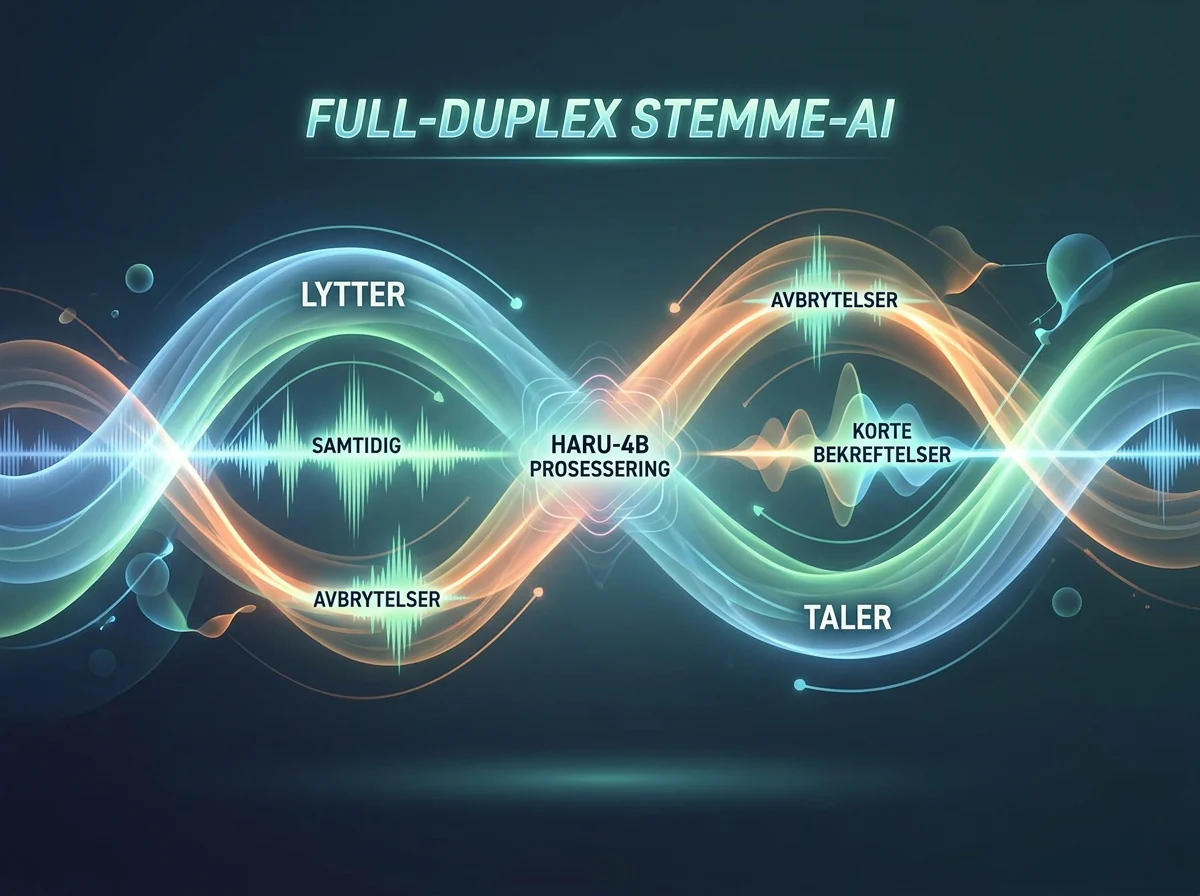
Det åpner for små, menneskelige signaler underveis. En stemmeagent kan i prinsippet komme med et kort «mhm» uten å slutte å lytte, eller registrere at brukeren avbryter mens den selv snakker. Haru-4B er ikke en ferdig forbrukertjeneste, men en grunnmodell og et sett med åpne byggesteiner som utviklere kan bruke videre.
Det er nettopp derfor jeg synes denne lanseringen er interessant. Higurashi har bygget samtidig lyd inn i en modell med Qwen3.5-4B som grunnlag, publisert vektene og inferenskoden og lagt til flere måter å kjøre den på. Samtidig er det viktig å skille naturlig flyt fra en klok og pålitelig assistent. Haru-4B kan høres mer samtaleaktig ut uten dermed å vite hva som er sant eller følge vanskelige instruksjoner riktig.
Hva er Haru-4B?
Haru-4B er en speech-to-speech-grunnmodell som tar imot og produserer tale som samtidige strømmer. Higurashi introduserte modellen 13. november 2026 og beskriver den som en full-duplex-modell bygget på Qwen3.5-4B.
«Full-duplex» er det sentrale begrepet. I en vanlig samtale venter ikke mennesker alltid høflig på at den andre skal levere et helt ferdig avsnitt. Vi gir små bekreftelser, tar sats, nøler og avbryter. En stemmeagent som må veksle mellom en ren lyttemodus og en ren snakkemodus, får lett den litt kunstige walkie-talkie-følelsen.
Haru behandler i stedet innkommende brukertale, sin egen tale og tekst som synkroniserte strømmer i én språkmodell. Lydstrømmen oppdateres 7,5 ganger i sekundet, altså omtrent hver 133. millisekund. Det tallet beskriver størrelsen på lydrammene, ikke hvor lang tid hele systemet bruker på å forstå deg og svare. Den forskjellen er liten på papiret og ganske viktig i praksis.
Modellen bruker VibeVoice til lydrepresentasjon og en lett MeanFlow-komponent til å produsere lyd i ett samplingsteg. Det tekniske poenget er ikke navnet på hver del, men at modellen samler lytting, språkarbeid og tale i en løpende prosess. Det gir et annet utgangspunkt enn en kjede som først gjør tale om til tekst, venter på et komplett tekstsvar og deretter starter en separat talesyntese.
Hvorfor betyr samtidig lytting og tale noe?
Samtidig lytting og tale betyr at en stemmeagent kan følge med mens den svarer. Det gjør avbrytelser, korte bekreftelser og skiftende taleturer lettere å håndtere uten at samtalen må nullstilles for hvert skifte. Dette er forklarende eksempler på hva full-duplex muliggjør, ikke resultater fra en norsk test.
Forskjellen merkes særlig når samtalen ikke går etter manus. Du kan begynne å korrigere et svar før agenten er ferdig, eller agenten kan gi et lite signal om at den følger med mens du forteller noe lengre. Den slags timing gjør ikke modellen mer kunnskapsrik, men den kan gjøre grensesnittet mindre mekanisk.
Jeg har tidligere skrevet om stemmen som grensesnitt til kodeverktøy. Haru-4B angriper et dypere lag i samme utvikling: selve modellen som holder lyd inn og lyd ut i gang samtidig. Det er relevant for alt fra samtalekarakterer til språktrening og framtidige stemmegrensesnitt, men dette er mulige bruksområder – ikke ferdige Haru-produkter du kan abonnere på i dag.
Det mest spennende er derfor ikke at en maskin kan lese opp et svar. Det kan mange systemer allerede. Nytten ligger i at utviklere får en åpen modell laget for selve rytmen i en samtale, også når partene snakker over hverandre. Hvis dette fungerer stabilt etter tilpasning, kan stemmeagenter slutte å føles som skjemaer med mikrofon.
Hva er åpent, og hva kan utviklere bygge?
Higurashi har publisert Haru-4B med modellvekter og inferenskode under Apache 2.0. Prosjektets README på GitHub beskriver en PyTorch-implementasjon med webdemo, en MLX-implementasjon med en native app for Apple Silicon og integrasjon med vLLM-Omni for serverbruk.
Det gjør modellen aktuell både for lokal utforsking og som grunnlag for en tjeneste utvikleren drifter selv. Lokal kjøring gir også mulighet til å kontrollere modell, lydflyt og tilpasninger uten å være helt avhengig av et lukket tale-API. Men åpne vekter betyr ikke at driften er gratis, eller at absolutt alt rundt treningen er offentlig.
Higurashi har publisert vektene og koden som trengs for inferens. Hele treningsdatasettet og treningskoden følger ikke med. Utvikleren sier at en mer detaljert teknisk rapport og treningskode er planlagt. Det er altså en reell åpen utgivelse som folk kan kjøre og bygge på, men ikke et komplett innsyn i hvert steg som skapte modellen.
Utviklere kan styre karakteren med et strukturert tekstkort og stemmen med et referanseklipp. README-en beskriver et rent opptak med én taler på mellom 3 sekunder og 3 minutter. Brukeren må ha rett til stemmen, og modellen leveres ikke med ferdige stemmeklipp. Det er en fornuftig byggekloss: personlighet og stemmereferanse kan tilpasses uten at prosjektet later som én standardstemme passer til alt.
Dette ligner på et viktig skille jeg har sett i lokal stemmekloning: stemmen, leveringen og samtalesystemet er forskjellige deler av problemet. Jeg har tidligere gått gjennom Chatterbox som lokal stemmekloning. Haru-4B har et annet hovedmål. Her er den store nyheten at samtalepartene kan produsere lyd samtidig.
Kan Haru-4B kjøres lokalt?
Ja, Haru-4B kan kjøres lokalt. Modellkortet og README-en oppgir en NVIDIA-GPU med omtrent 12 GB minne for det beskrevne PyTorch-oppsettet. Det er utviklerens omtrentlige krav, ikke en universell grense for alle maskiner, implementasjoner og framtidige kvantiseringer.
Apple Silicon har sitt eget spor gjennom MLX og en native app. Higurashi rapporterer omtrent 65 millisekunder i en måling på en MacBook Pro med M1 Max, int8-vekter og spesialiserte Metal-kjerner. Målingen omfatter lydkoding, språkmodell, lyddekoding og kablet mikrofon- og hodetelefontrafikk, men ikke innrammingen av lyden. Den kan legge til opptil 133 millisekunder.
Det er derfor feil å koke tallet ned til at «Haru svarer på 65 millisekunder». Testen beskriver et bestemt oppsett og et bestemt måleomfang. På en Nvidia B300 oppgir utvikleren rundt 15 millisekunder for lydkoding, lyddekoding og ett modellsteg, men det er enda et annet utsnitt av systemet. Tallene viser at sanntidskjøring er et seriøst mål, ikke at alle får identisk forsinkelse.
Lydutstyret spiller også inn. README-en anbefaler kablet mikrofon og hodetelefoner og oppgir at Bluetooth kan legge til 100 millisekunder eller mer. Det er lett å skylde på modellen når tregheten egentlig ligger i hele kjeden fra mikrofon til lydkort, rammeinndeling, modell og avspilling. Stemmesystemer lever ikke i et benchmark-vakuum.
Fungerer Haru-4B på norsk?
Det finnes ikke dokumentasjon som viser hvor godt Haru-4B forstår eller snakker norsk. Higurashis tekniske presentasjon oppgir trening på mer enn 40 millioner timer virkelig tale fra over 160 språk, men norsk er ikke blant de ni hovedspråkene utvikleren trekker fram.
De ni er engelsk, spansk, portugisisk, tysk, fransk, kinesisk, japansk, russisk og koreansk. At norsk kan finnes i et stort flerspråklig treningsgrunnlag, dokumenterer ikke god norsk uttale, dialektforståelse eller trygg håndtering av avbrytelser. Det dokumenterer heller ikke at norsk umulig kan virke. Svaret er rett og slett at kvaliteten ikke er undersøkt godt nok.
Utvikleren oppgir at treningsdataene ikke inneholder dialoger generert av språkmodeller eller tale laget med TTS. En senere treningsfase bruker mer enn 13 millioner timer separert samtalelyd, med eksempler på opptil 60 minutter. De 60 minuttene beskriver lengden på treningseksempler, ikke en lovet maksimal samtaletid i et ferdig produkt.
Jeg har ikke testet eller lyttet til Haru-4B, så jeg har heller ingen egen vurdering av den norske kvaliteten. Skal noen bygge en norsk tjeneste på Haru, må norsk lyd, reelle dialekter, støy og avbrytelser måles i den konkrete løsningen.
Hva kan ikke grunnmodellen gjøre ennå?
Haru-4B er en forhåndstrent grunnmodell for forskning, ikke en ferdig assistent. Modellkortet sier uttrykkelig at den ikke er en pålitelig faktakilde, og at den ikke følger instruksjoner slik en ferdigtrent assistentmodell gjør. En naturlig stemme og god timing kan gjøre feil svar mer overbevisende. Det er ikke det samme som at svarene blir riktige.
Dette er modellens viktigste begrensning, men ikke et argument mot prosjektet. En grunnmodell skal være noe andre kan tilpasse. Utviklere som vil lage kundestøtte, opplæring eller en samtalekarakter, må fortsatt bygge kunnskapsgrunnlag, instrukstrening, sikkerhetsgrenser, verktøybruk og kontroll rundt selve talesystemet.
Treningslyden har dessuten støy og feil fra separasjonen av samtalepartene, særlig når tale overlapper. Higurashi peker på bedre tilpasning med ekte tokanals samtaler, større modeller og sanntidsvideo som videre arbeid. Det siste er altså en plan, ikke en skjult videoegenskap i Haru-4B.
Lokal drift må også avgrenses riktig. Du kan kjøre modellen på egen maskin, men README-en har en valgfri delingsfunksjon som sender trafikk gjennom Gradio-servere. «Lokal modell» er derfor ikke automatisk det samme som at hver mulig konfigurasjon holder all lyd lokalt. Utvikleren må vite hvilke funksjoner som er slått på og hvor dataene faktisk går.
Hvorfor Haru-4B er verdt å følge
Haru-4B viser en retning jeg gjerne vil se mer av: avansert stemmeteknologi som ikke bare kommer ferdig innpakket bak et lukket API. Det beskrevne lokale oppsettet krever rundt 12 GB GPU-minne. Det er ikke lite for alle, men det plasserer modellen innenfor rekkevidde for langt flere utviklere enn et enormt forskningssystem.
Den viktigste nyheten er fortsatt samtaleflyten. Modellen er bygget for at lytting og tale kan skje samtidig, og Higurashi har åpnet nok av systemet til at andre kan undersøke, tilpasse og forbedre det. Det kan bli en nyttig byggestein for lokale stemmeagenter som oppfører seg mindre som walkie-talkier og mer som samtalepartnere.
Men byggestein er riktig ord. Haru-4B er ikke dokumentert som en god norsk assistent, den er ikke en pålitelig faktakilde og den er ikke et ferdig produkt for vanlige forbrukere. Den er et åpent teknisk utgangspunkt med en spennende evne: Den kan holde ørene åpne mens den bruker stemmen. Det er konkret nytt, og mer enn interessant nok uten å late som resten allerede er løst.
Ofte stilte spørsmål
Er Haru-4B gratis å laste ned?
Ja. Modellvektene og inferenskoden er publisert under Apache 2.0. Du må likevel betale for eller eie maskinvaren som kjører modellen, og åpen tilgang til vektene betyr ikke at hele treningsdatasettet og alle treningsdetaljene er publisert.
Hvor mye GPU-minne trenger Haru-4B?
Utvikleren oppgir omtrent 12 GB minne for det beskrevne lokale oppsettet med Nvidia-GPU. Det er et omtrentlig krav for denne implementasjonen, ikke en garanti for alle plattformer, kvantiseringer eller kombinasjoner av programvare og maskinvare.
Kan Haru-4B avbrytes mens den snakker?
Modellen er laget for full-duplex tale, slik at den kan behandle innkommende lyd mens den produserer sin egen. Det gir det tekniske grunnlaget for avbrytelser og overlappende tale, men hvor godt det fungerer, avhenger av tilpasningen og hele systemet rundt modellen.
Er Haru-4B en ferdig AI-assistent?
Nei. Haru-4B er en forhåndstrent grunnmodell for forskning og videre utvikling. Modellkortet sier at den ikke er en pålitelig faktakilde eller en ferdig instruksjonsmodell. Utviklere må bygge kunnskap, styring, sikkerhet og produktfunksjoner rundt den.