Innhold Vis
Qwen4-Max kan gjøre lange AI-agentjobber betydelig billigere, men ikke les «62 prosent lavere kostnad» som en rabatt som automatisk dukker opp på din egen regning. Alibaba har presset ned både tokenbruken og API-prisen. Det er en lovende kombinasjon for agenter som sender store mengder kontekst fram og tilbake gjennom mange steg.
Den nye toppmodellen har 2,4 billioner parametere totalt, aktiverer 71 milliarder for hvert token, tar imot tekst, bilder og video og har et kontekstvindu på én million tokens. Det er store tall, men den praktiske nyheten ligger i hvor mye arbeid modellen kan få gjort per krone – ikke i hvor imponerende modellkortet ser ut.
Her må jeg samtidig holde igjen applausen litt. Kostnadsfallet kommer fra Alibabas egen Work360-evaluering, og Qwen4-Max er en proprietær skytjeneste. Jeg har ikke testet modellen selv. For utviklere og bedrifter er den riktige reaksjonen derfor ikke å flytte alt på lanseringsdagen, men å sette Qwen4-Max opp mot egne oppgaver, egne kvalitetskrav og hele regningen.
Hva er Qwen4-Max?
Qwen4-Max er Alibabas nye proprietære toppmodell i Qwen-familien. Ifølge Alibabas lansering 16. november 2026 bruker modellen en Mixture-of-Experts-arkitektur med 2,4 billioner parametere totalt, men bare 71 milliarder aktive parametere per token. Den tar imot tekst, bilder og video og har et kontekstvindu på én million tokens. Det siste er ikke nytt for Qwen-familien – Qwen3.6-Plus hadde også én million tokens – så nyhetsverdien ligger først og fremst i pris og effektivitet.
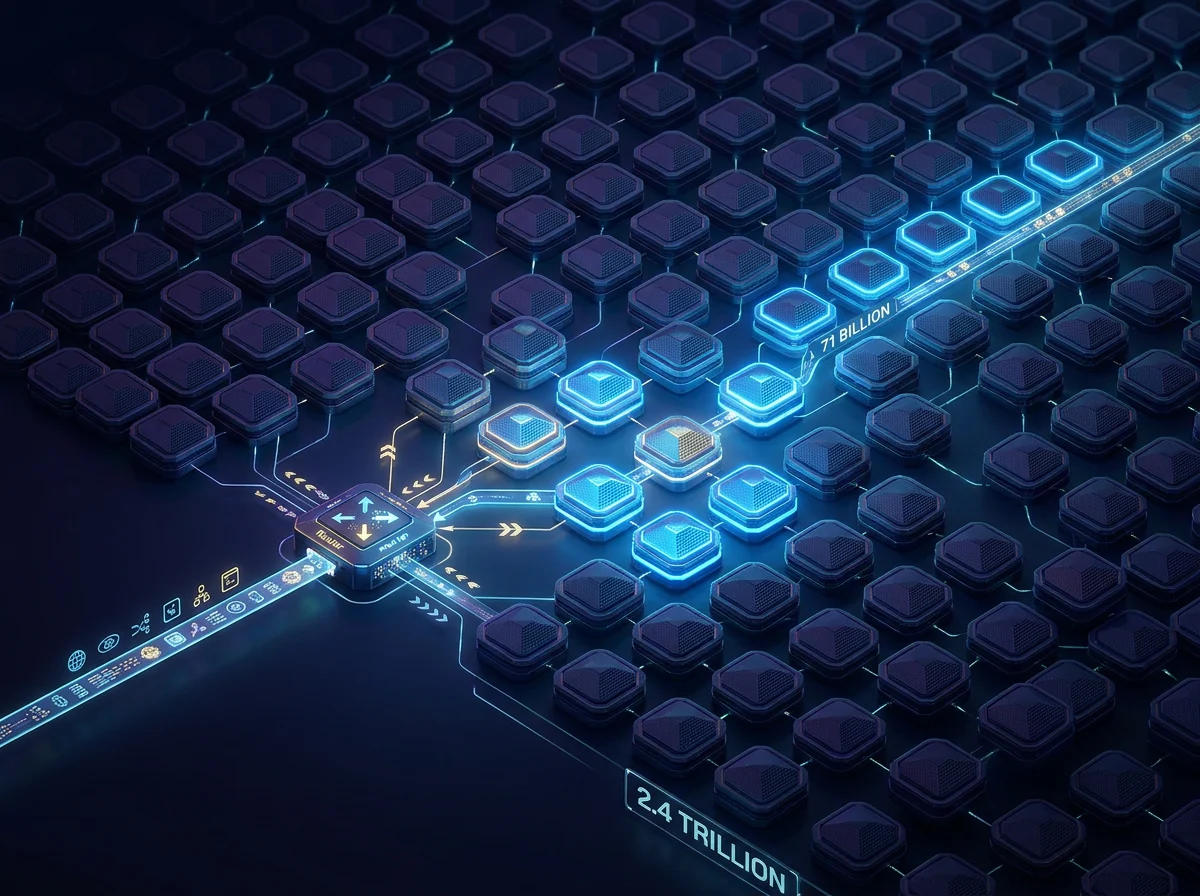
MoE-arkitektur betyr at hele modellen ikke må arbeide med hvert eneste token. Systemet sender oppgaven gjennom et utvalg eksperter, slik at Qwen4-Max kan ha svært stor samlet kapasitet uten at alle de 2,4 billionene må aktiveres hver gang. Alibaba oppgir at modellen aktiverer 25 prosent færre parametere enn Qwen3.8-Max, selv om begge har samme totale størrelse.
Det er viktigere enn selve rekordtallet. Færre aktive parametere kan redusere inferenskostnaden, men forteller ikke alene hvor god modellen er. Ruting, trening, minnebruk, programvare og hvor mange tokens modellen trenger for å løse oppgaven, betyr også mye. En enorm modell som tenker seg bort i en skog av unødvendig tekst kan fortsatt bli dyr i drift.
Hvorfor betyr 71 milliarder aktive parametere noe?
De 71 milliarder aktive parameterne forklarer hvordan Alibaba prøver å få mer kapasitet ut av mindre beregning per token. Qwen4-Max har omtrent 34 ganger flere parametere totalt enn den aktiverer i én behandling. Det gjør ikke modellen liten, men det gjør «2,4 billioner» langt mindre nyttig som mål på den faktiske kostnaden ved et API-kall.
For den som bygger en agent er antall aktive parametere heller ikke sluttmålet. Agenten skal lese dokumenter, velge verktøy, skrive kode, kontrollere resultatet og komme i mål uten fem ekstra runder med reparasjon. Hvis en billigere modell bruker færre tokens, men krever mer menneskelig opprydding, har man bare flyttet kostnaden fra API-et til arbeidstiden.
Alibaba hevder at Qwen4-Max bruker 35 prosent færre tokens enn Qwen3.8-Max i Work360 ved «High» reasoning effort. I den samme evalueringen økte poengsummen fra 47,74 til 52,69. Det er et bedre signal enn parameterantallet fordi det kobler ressursbruk til et resultat. Likevel er Work360 Alibabas egen evaluering av oppgaver innen 721 fagområder, og tallene er ikke en garanti for samme gevinst i din kodebase, dokumentflyt eller kundeservice.
Hvor mye koster Qwen4-Max?
Qwen4-Max koster 1,50 dollar per million input-tokens og 4,50 dollar per million output-tokens på QwenCloud, ifølge prisene gjengitt i lanseringsomtalen fra MarkTechPost. Med en dollarkurs på omtrent 9,6 kroner tilsvarer det cirka 14 kroner inn og 43 kroner ut per million tokens.
Cache-treff på input er priset til 0,075 dollar per million tokens, altså rundt 72 øre. Alibaba bekrefter denne cache-prisen og opplyser at modellen er tilgjengelig gjennom QwenClouds Token Plan og API, i tillegg til QwenWork og QwenStudio. MarkTechPost oppgir også OpenRouter som tilgangsvei. For en lang agentjobb kan caching være vel så viktig som listeprisen på vanlig input, fordi de samme instruksjonene, filene og tidligere verktøyresultatene ofte sendes inn igjen i mange runder.
Et enkelt regneeksempel gjør forskjellen tydelig. En forespørsel med 100 000 ukomprimerte input-tokens og 20 000 output-tokens koster omtrent 0,24 dollar, eller rundt 2,30 kroner, før eventuelle verktøykall, nye runder og andre tillegg. Hvis mesteparten av den gjentatte inputen treffer cachen, faller den delen av regningen kraftig.
Det betyr likevel ikke at én million tokens kontekst bør fylles bare fordi plassen finnes. Lange kontekster koster penger, kan gjøre relevante detaljer vanskeligere å finne og blir ofte sendt flere ganger i agentløpet. God kontekststyring er fortsatt bedre enn å dumpe hele filserveren inn i modellen og håpe på det beste. Én million tokens er kapasitet, ikke en oppfordring.
Hva betyr 62 prosent lavere kostnad?
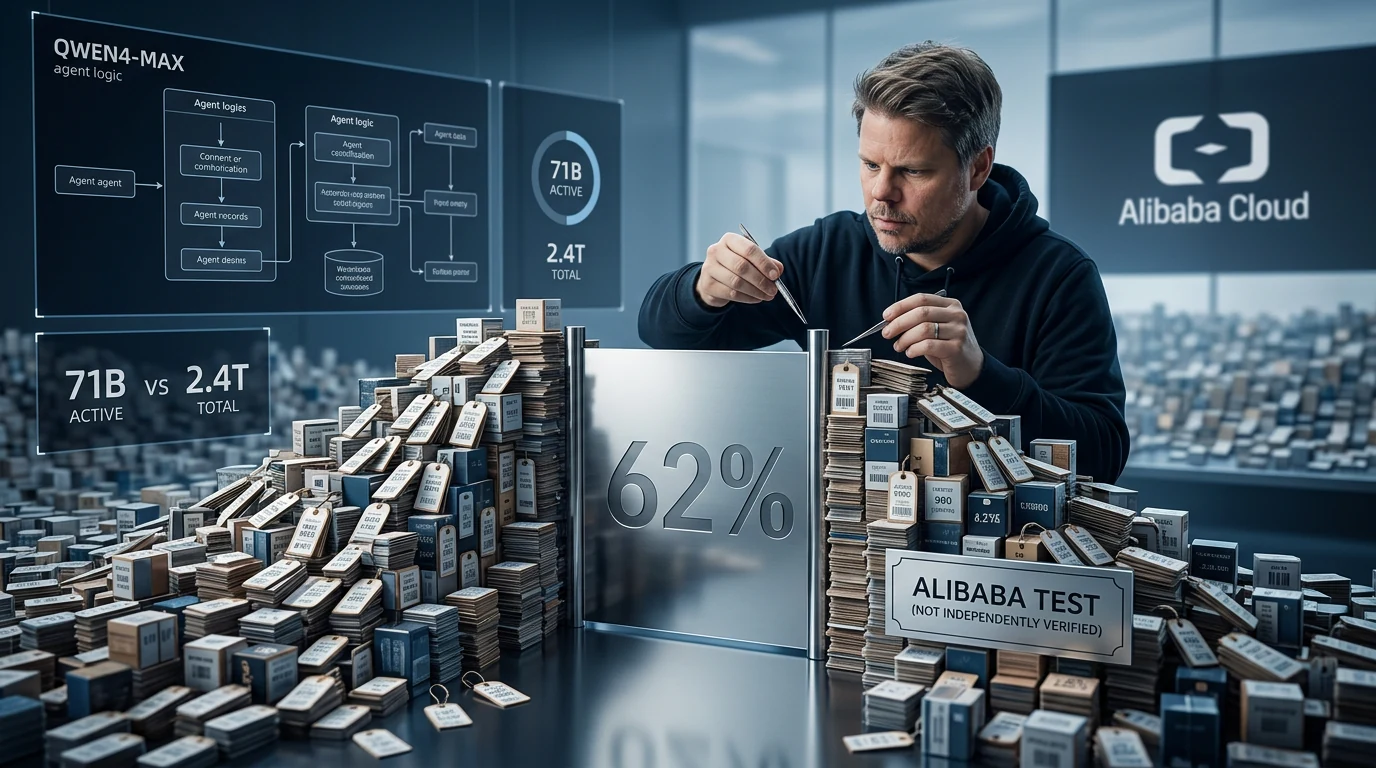
Alibaba målte en gjennomsnittlig Work360-kostnad på 1,67 dollar per oppgave med Qwen4-Max, mot 4,43 dollar med Qwen3.8-Max. Det er omtrent 16 kroner mot 42 kroner og en nedgang på 62 prosent. Samtidig steg Work360-resultatet, så på Alibabas egne oppgaver ble modellen både bedre og billigere.
Den besparelsen kommer fra to steder: lavere pris per token og færre brukte tokens. Den er ikke det samme som at hver API-pris er kuttet med 62 prosent. Den sier heller ikke at alle kundearbeidsflyter blir 62 prosent billigere. Oppgavemiks, effort-innstilling, cache-treff, verktøykall, retries og lengden på svarene kan endre resultatet mye.
Dette er et klassisk tilfelle der en leverandørpåstand både kan være matematisk riktig og lett å misforstå. Tallene fra 4,43 til 1,67 dollar henger sammen. Men Work360 er laget og kjørt av Alibaba, og det foreligger ikke i kildematerialet noen uavhengig gjentakelse av akkurat denne kostnadstesten. Jeg ville derfor brukt 62 prosent som en god grunn til å måle Qwen4-Max, ikke som et ferdig budsjettall.
Hva kan én million tokens og innebygd bildestøtte brukes til?
Én million tokens gjør Qwen4-Max aktuell for store dokumentmengder, lange kodebaser og agentløp der mye historikk må være tilgjengelig samtidig. Innebygd bildestøtte betyr at den samme modellen kan tolke tekst, diagrammer, skjermbilder og andre visuelle innspill uten en separat synsmodell. Det kan forenkle systemer som jobber på tvers av dokumenter og brukergrensesnitt.
Alibaba trekker fram koding, arbeidsoppgaver, visuell resonnering, 3D-modellering, spillutvikling og industrielt arbeid. I en demonstrasjon skal modellen ha redusert manuell programmering av et maskineringsstykke fra omtrent 475 til 24 minutter. Selskapet beskriver også en 48 timer lang agentkjøring for forskning på kjølevæske og et annet forsøk med 454 verktøykall og 3 239 målinger i utviklingen av molekylkandidater.
Dette viser hva Alibaba ønsker å selge modellen som: en motor for lange, verktøybrukende arbeidsflyter, ikke bare en chatbot med ekstra stor hukommelse. Demonstrasjonene er fortsatt leverandørens egne. De dokumenterer at systemet er bygget for slike oppgaver, men ikke at det kan slippes løs uten kontroll på maskinering, forskning eller andre områder der feil blir dyre.
Er Qwen4-Max en åpen modell?
Nei. Qwen4-Max tilbys som en proprietær tjeneste gjennom Alibabas plattformer og API. Alibaba sier at mindre Qwen4-modeller med åpne vekter kommer senere, men det løftet gjør ikke Max-modellen åpen i dag. Du kan bruke tjenesten, men du får ikke vektene til lokal kjøring eller full innsyn i modellen.
Det skillet er særlig viktig fordi Qwen-navnet ofte forbindes med modeller som kan lastes ned og kjøres selv. Qwen4-Max er et annet produktvalg. For bedrifter betyr det at pris, tilgjengelighet, databehandling og leverandørbinding må vurderes som for enhver annen skytjeneste.
Jeg er skeptisk til kinesiske modeller, men ikke interessert i å avvise dem på refleks. Qwen-modeller har flere ganger vært teknisk sterke og prismessig aggressive. Nettopp derfor bør vurderingen være konkret: Hvilke data sendes ut, hvor behandles de, hvilke avtaler gjelder, og er kvaliteten god nok på de faktiske oppgavene? Nasjonaliteten erstatter ikke den kontrollen, men en pen benchmark erstatter den heller ikke.
Bør du bruke Qwen4-Max til AI-agenter?
Qwen4-Max er verdt en avgrenset pilot hvis du har lange, dyre agentløp der kontekst, caching og mange verktøysteg dominerer regningen. Prisene er lave nok til at modellen kan være interessant som et alternativ i en modellruter, særlig for dokumenttunge oppgaver og arbeidsflyter med mye gjentatt input.
Ikke start med parameterantallet eller den beste søylen i et benchmark. Velg et lite sett representative oppgaver, lås kvalitetskriteriene på forhånd og mål hele løpet: fullføringsgrad, tokenbruk, antall retries, verktøyfeil, svartid og hvor mye menneskelig retting som gjenstår. Sammenlign kostnaden per godkjent resultat, ikke bare kostnaden per første svar.
Hold samtidig sensitive produksjonsdata ute til databehandling, lagring og avtaleverk er avklart. Det rådet gjelder alle eksterne modell-API-er, men proprietær drift gjør at du ikke kan kontrollere løsningen på samme måte som en modell med åpne vekter på egen maskin.
Qwen4-Max ser kort sagt ut som et seriøst prisangrep på markedet for agentmodeller. Kombinasjonen av én million tokens, innebygd bildestøtte, færre aktive parametere og svært billig cache kan få praktisk betydning. Men den virkelig interessante testen begynner først når Alibabas oppgaver byttes ut med dine. Mål før du flytter. Det er mindre spennende enn «62 prosent billigere», men langt mer nyttig.
Ofte stilte spørsmål
Kan Qwen4-Max kjøres lokalt?
Nei. Qwen4-Max er en proprietær modell som tilbys gjennom QwenCloud og andre Alibaba-tjenester. Alibaba har varslet mindre Qwen4-modeller med åpne vekter, men det betyr ikke at vektene til Max-modellen blir tilgjengelige for lokal kjøring.
Hva koster én million tokens med Qwen4-Max?
QwenCloud-prisen er 1,50 dollar for én million input-tokens og 4,50 dollar for én million output-tokens, omtrent 14 og 43 kroner. Cache-treff på input koster 0,075 dollar, cirka 72 øre per million tokens.
Blir alle AI-agentoppgaver 62 prosent billigere?
Nei. 62 prosent er kostnadsfallet Alibaba målte i sin egen Work360-evaluering, fra 4,43 til 1,67 dollar per oppgave. Din besparelse avhenger blant annet av tokenbruk, cache-treff, verktøykall, retries og hvor mye arbeid som kreves etterpå.
Hvor stor kontekst har Qwen4-Max?
Qwen4-Max har et kontekstvindu på én million tokens. Det gir plass til store dokumentmengder, lange kodebaser og omfattende agenthistorikk, men hele vinduet bør ikke fylles uten grunn. Mer kontekst kan øke både kostnaden og mengden irrelevant informasjon.