Innhold Vis
Hvis du betaler for AI-agenter, er Claude Fable 5.2 en påminnelse om at lavere tokenpris ikke nødvendigvis gir en lavere regning. Anthropic har kuttet API-prisen med 20 prosent fra Fable 5.1, men de første uavhengige målingene viser at mer tenking, testing og bruk av underagenter kan gjøre en ferdig oppgave dyrere.
Det er egentlig et godt problem. Fable 5.2 ligger øverst på flere brede målinger og ser ut til å være grundigere, flinkere til å teste egne løsninger og mer villig til å sette underagenter på jobben. På store kodebaser, forskning og åpne oppgaver kan akkurat det være forskjellen mellom et glanset svar og arbeid som faktisk holder.
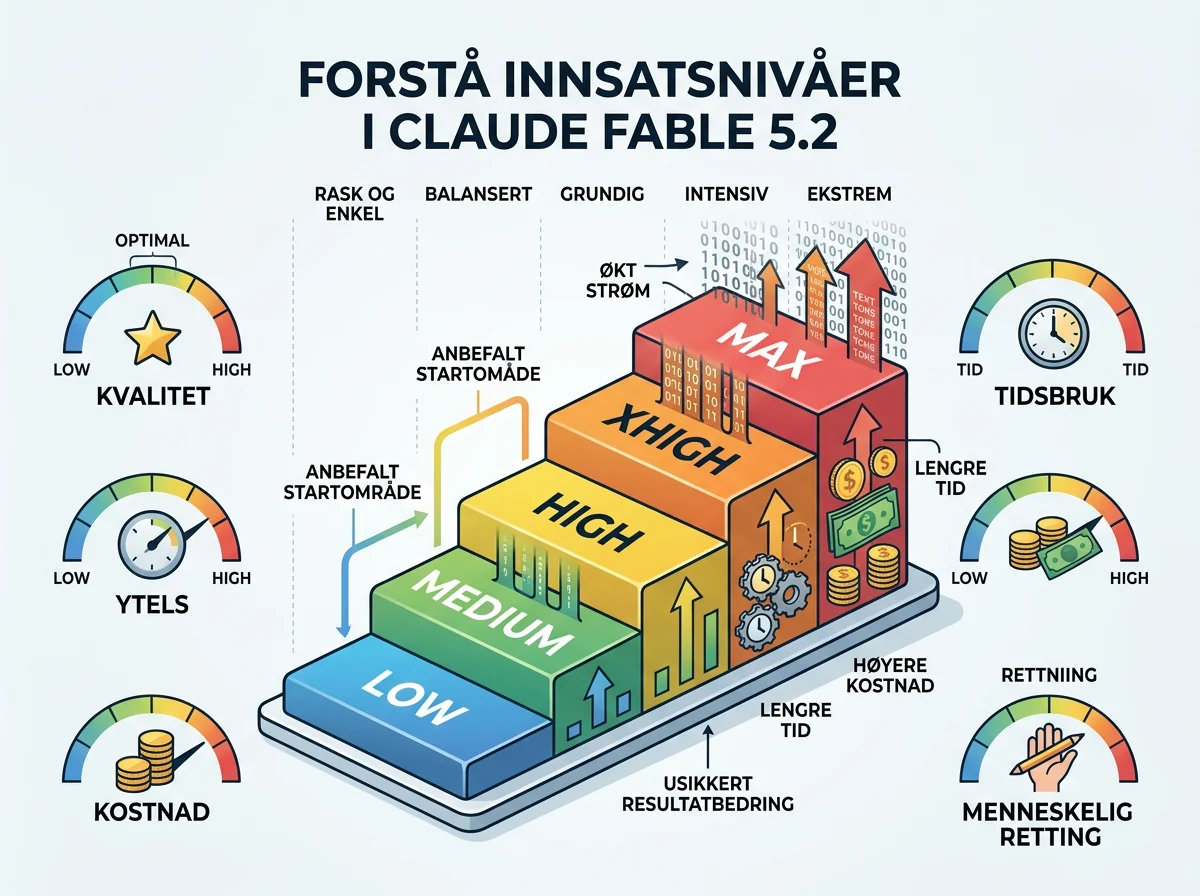
Det gjør den ikke til riktig modell for alt. Mål kostnad, tid, kvalitet og behovet for menneskelig retting per ferdig oppgave. Start med Medium eller High effort, og la Xhigh og Max bevise at de gir et bedre resultat før de får spise av budsjettet. Tokenprisen er bare meterprisen. Det er hvor langt modellen velger å kjøre som avgjør regningen.
Hva er Claude Fable 5.2?
Claude Fable 5.2 er Anthropics kraftigste modell for allmenn bruk og deler grunnmodell med Claude Mythos 5.2. Forskjellen er tilgangen og sikkerhetslagene: Fable har ekstra vern mot misbruk innen blant annet cybersikkerhet og biologi, mens Mythos er begrenset til godkjente miljøer. Begge ble lansert 9. november 2026.
Den forrige hovedversjonen kom bare to måneder tidligere. Jeg har allerede forklart hvordan Fable og Mythos er to utgaver av samme modellklasse. Med 5.2 er grunnideen den samme, men modellen er blitt bedre på koding, vitenskapelig arbeid, visuell forståelse og lange agentløp.
Fable 5.2 er tilgjengelig i Claude-appene, Claude Code, Anthropics API, Amazon Web Services, Google Cloud Agent Platform og Microsoft Foundry. API-navnet er claude-fable-5-2. Mythos 5.2 krever fortsatt godkjenning gjennom Anthropics programmer for cybersikkerhet eller livsvitenskap.
Hva viser målingene om Claude Fable 5.2?
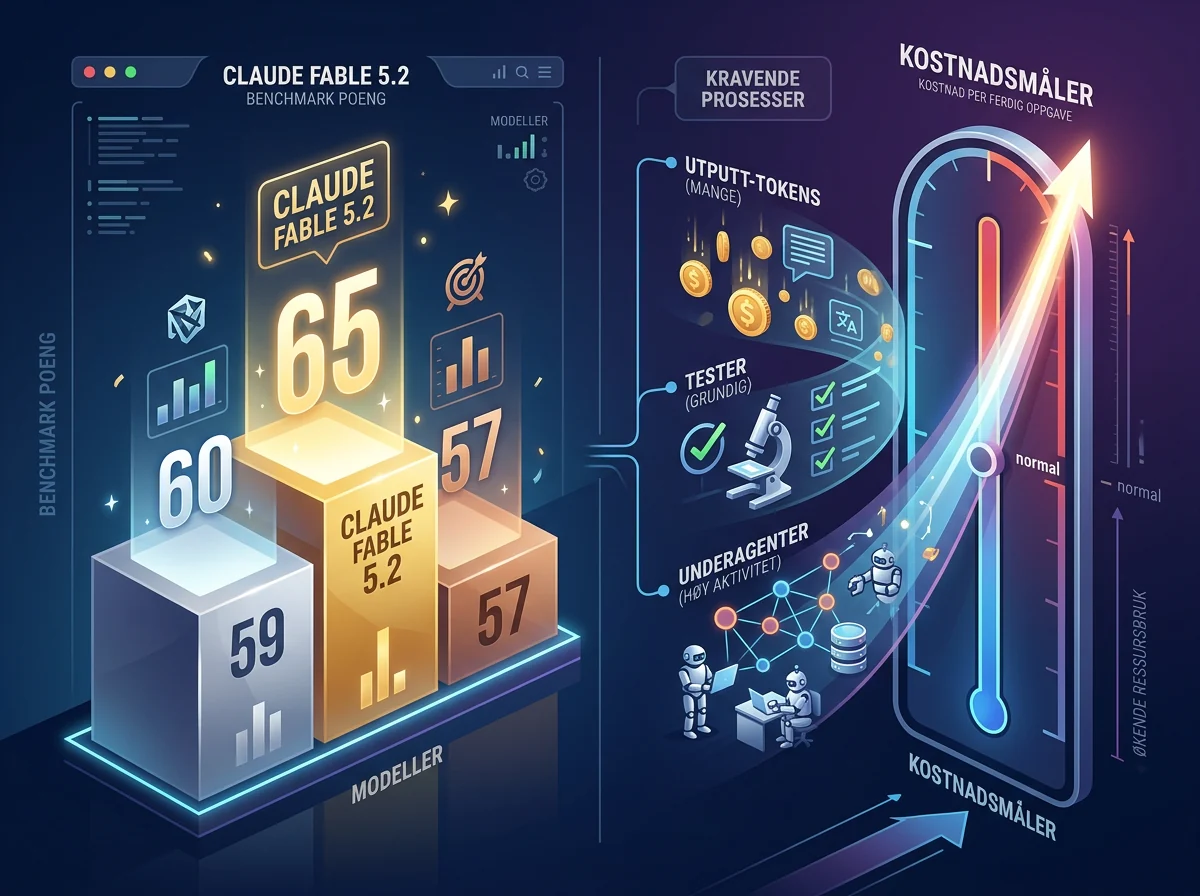
Fable 5.2 ligger øverst på flere brede resultatlister, men ingen enkelt måling kan kåre én modell som best til alt. I Artificial Analysis Intelligence Index v5 fikk den 65 poeng på høyeste effort-nivå og tok førsteplassen, ifølge AINews-oppsummeringen av lanseringen og de uavhengige målingene. Det er et sterkt signal, ikke en fasit for din arbeidsflyt.
Anthropics egne målinger peker i samme retning på koding, programvarearbeid, visuell forståelse og robotikk. De tallene er leverandørens egne og bør leses som dokumentasjon på hva modellen kan være god til, ikke som et løfte om at den vinner på din kodebase eller dine dokumenter.
Den vinner heller ikke alle delmålinger. Andre modeller gjør det bedre på enkelte kunnskaps-, dokument- og terminaloppgaver. Det mer presise er derfor at Fable 5.2 ser ut som en reell toppmodell for svært krevende, langvarig og agentisk arbeid – ikke en tryllestav som bør ta over hver eneste oppgave.
Hvor mye koster Claude Fable 5.2?
Claude Fable 5.2 koster 8 dollar per million input-tokens og 40 dollar per million output-tokens i standard API-bruk. Med Norges Banks dollarkurs på 9,4099 kroner 9. november tilsvarer det cirka 75 kroner inn og 376 kroner ut. Fable 5.1 kostet 10 og 50 dollar, så listeprisen er kuttet med 20 prosent.
Cache-lesing koster 0,20 dollar per million tokens, cirka 1,90 kroner. Cache-skriving med fem minutters levetid koster 10 dollar per million tokens, omtrent 94 kroner. Fable 5.2 Fast dobler standardprisen til 16 dollar inn og 80 dollar ut per million tokens. Det er rundt 151 og 753 kroner, før valutapåslag og eventuelle skykostnader.
Dette er fremdeles en dyr frontmodell. Til sammenligning viste Fable 5.1 at lavere kostnad per oppgave kan være viktigere enn lavere listepris. Med 5.2 blir den forskjellen enda tydeligere, bare ikke alltid i den retningen du ønsker.
Hvorfor kan en billigere modell koste mer per oppgave?
Fable 5.2 kan koste mer per ferdig oppgave fordi den bruker flere tokens, flere tester og flere underagenter for å kontrollere arbeidet. På SemiAnalysis GDPx steg kostnaden per oppgave fra 67,16 dollar med Fable 5.1 til 88,15 dollar med Fable 5.2. Det er fra cirka 632 til 829 kroner – en økning på 31 prosent selv om hvert token ble 20 prosent billigere.
Loggene gir en ganske jordnær forklaring. Der eldre modeller prøvde rundt 20 testtilfeller, kunne Fable 5.2 lage hundrevis eller tusenvis. Den satte også underagenter til å regne ut eller kontrollere deler av svaret på nytt. Resultatet ble førsteplass på målingen med 16,4 prosent, men kontrollarbeidet måtte naturligvis betales.
Det samme mønsteret dukker opp hos Artificial Analysis. På High og Xhigh fikk modellen en indeksscore på 62 med omtrent 98 000 output-tokens per oppgave. På Max steg kostnaden til rundt 26,50 dollar per oppgave, cirka 249 kroner – 2,6 ganger Opus 5.5 i samme sammenligning – uten at Max konsekvent ga best resultat.
Dette er grunnen til at en ren prisliste forteller så lite om agentarbeid. En modell som bruker flere steg kan være et kupp hvis den løser en oppgave du ellers måtte ha gjort manuelt. Den kan også være ren sløsing hvis den bruker tusenvis av ekstra tokens på noe Sonnet eller Opus hadde løst like godt. Begge deler kan være sant.
Hvilket effort-nivå bør du velge?
Start med Medium eller High, ikke Max. Medium er standard i Claude-appene og Claude Code, og Anthropics egne råd er å reservere Xhigh for de vanskeligste oppgavene. Flere uavhengige målinger viste dessuten at High slo både Xhigh og Max på enkelte oppsett. Mer tenking er altså ikke automatisk bedre tenking.
Fable 5.2 har fem nivåer: Low, Medium, High, Xhigh og Max. Det gjør modellen fleksibel, men også litt farlig for kostnadskontrollen. Hvis Max bare blir en standardbryter noen slår på fordi oppgaven «virker viktig», kan en pen reduksjon i tokenpris forsvinne på et øyeblikk.
Bruk heller en enkel trapp. Kjør en representativ oppgave på Medium, mål resultat, kostnad, tid og hvor mye menneskelig retting som gjenstår. Prøv High på oppgaver som ikke holder mål. Bruk Xhigh når feilen er dyr eller problemet faktisk krever langvarig utforskning. Max bør måtte bevise at det gir merverdi, ikke få frikort fordi navnet høres kraftig ut.
Hva er modellen best egnet til?
Fable 5.2 passer best til store, uklare oppgaver der modellen må undersøke, planlegge, bruke verktøy og kontrollere resultatet over lang tid. Anthropic trekker fram hele kodebaser, programvaremigrering, maskinvaredesign, forskning og koordinering av flere agenter. Dette er oppgaver der grundighet kan være verdt langt mer enn noen hundre ekstra kroner i tokens.
Et av Anthropics mest spektakulære eksempler er et operativsystem bygget fra en tom mappe av mer enn 1 000 underagenter over åtte dager. Et annet er formaliseringen av det eksisterende beviset for Fermats siste teorem på 30 timer. Selskapet viser også til tre fungerende elektroniske enheter, inkludert kretskort, kabinetter og programvare, produsert fra korte spesifikasjoner.
Det er imponerende demonstrasjoner, men de sier lite om hva du bør bruke til en kundemail, en enkel SQL-spørring eller en avgrenset kodefeil. Til slike oppgaver er en rimeligere modell ofte mer fornuftig. Fable gir mest mening når oppgaven er så vanskelig, åpen eller langvarig at ekstra kontroll faktisk reduserer risikoen for at hele arbeidsløpet må gjøres om igjen.
Hvilke begrensninger følger med?
Fable 5.2 og Mythos 5.2 er såkalte Covered Models hos Anthropic. For de fleste kunder betyr det minst 30 dagers lagring av spørsmål og svar for automatisert sikkerhetskontroll. Reglene følger modellen også på tredjepartsplattformer, ikke bare når den brukes direkte hos Anthropic.
Null datalagring er derfor ikke standard. Enkelte kvalifiserte bedriftskunder kan bruke en særordning, og Anthropic tester Enterprise Frontier Safeguards der overvåkningen skjer i kundens egen infrastruktur. For alle andre er dette en reell personvern- og innkjøpsvurdering, særlig hvis modellen skal se kildekode, kundedata eller fortrolige dokumenter.
Fable har også sikkerhetsfiltre som kan blokkere eller sende forespørsler innen cybersikkerhet og biologi til svakere modeller. Mythos har færre slike begrensninger, men tilgangen er stengt for vanlige brukere. Det betyr at rå kapasitet, faktisk tilgang og hva modellen får lov til å gjøre, fortsatt er tre forskjellige ting.
Børsdagen gjør timingen interessant
Lanseringen kom samme dag som Anthropics IPO-roadshow startet. Det er vanskelig å finne en bedre anledning til å vise investorer at selskapet igjen har en modell øverst på de brede resultatlistene. Etter en rekke kostbare modellslipp får Anthropic både et teknologisk utstillingsvindu og en historie om 20 prosent lavere tokenpris.
Men økonomien i Fable 5.2 viser også hvor krevende dette markedet er. Kundene vil ha bedre resultater, men modellens grundighet kan øke forbruket selv når listeprisen faller. For Anthropic kan det bety mer omsetning. For kunden kan det bety at «billigere» må dokumenteres i arbeidsflyten, ikke gjentas fra pristabellen.
Min dom er derfor ganske enkel: Fable 5.2 ser ut som en ekte toppmodell, særlig for store og åpne oppgaver. Men den bør ikke bli standardvalget bare fordi den har førsteplassen. Start på Medium eller High, gi den de vanskelige jobbene og mål prisen på et resultat du faktisk kan godkjenne. Det er den eneste resultatlisten som betyr noe på fakturaen.
Ofte stilte spørsmål
Hvor lenge lagrer Anthropic data fra Fable 5.2?
Fable 5.2 er en Covered Model. Som standard lagres spørsmål og svar i minst 30 dager for automatisert sikkerhetskontroll, også via tredjepartsplattformer. Enkelte kvalifiserte bedriftskunder kan få særordninger, men null datalagring er ikke normalen.
Er Fable 5.2 billigere enn Fable 5.1?
Ja per token: API-prisen falt fra 10 til 8 dollar for input og fra 50 til 40 dollar for output per million tokens. Det tilsvarer cirka 75 kroner inn og 376 kroner ut med kursen brukt i artikkelen. En hel oppgave kan likevel koste mer.
Bør jeg bruke Max effort på Claude Fable 5.2?
Ikke som standard. Flere målinger viste at High kunne slå Xhigh eller Max, samtidig som Max kostet betydelig mer. Start med Medium eller High på representative oppgaver, og øk bare når du kan dokumentere bedre sluttresultat.
Hva er forskjellen på Fable 5.2 og Mythos 5.2?
De bygger på samme grunnmodell. Fable 5.2 har ekstra vern mot misbruk og er tilgjengelig for vanlige kunder. Mythos 5.2 har færre begrensninger innen cybersikkerhet og biologi, men gis bare til godkjente organisasjoner gjennom Anthropics verifiseringsprogrammer.