Innhold Vis
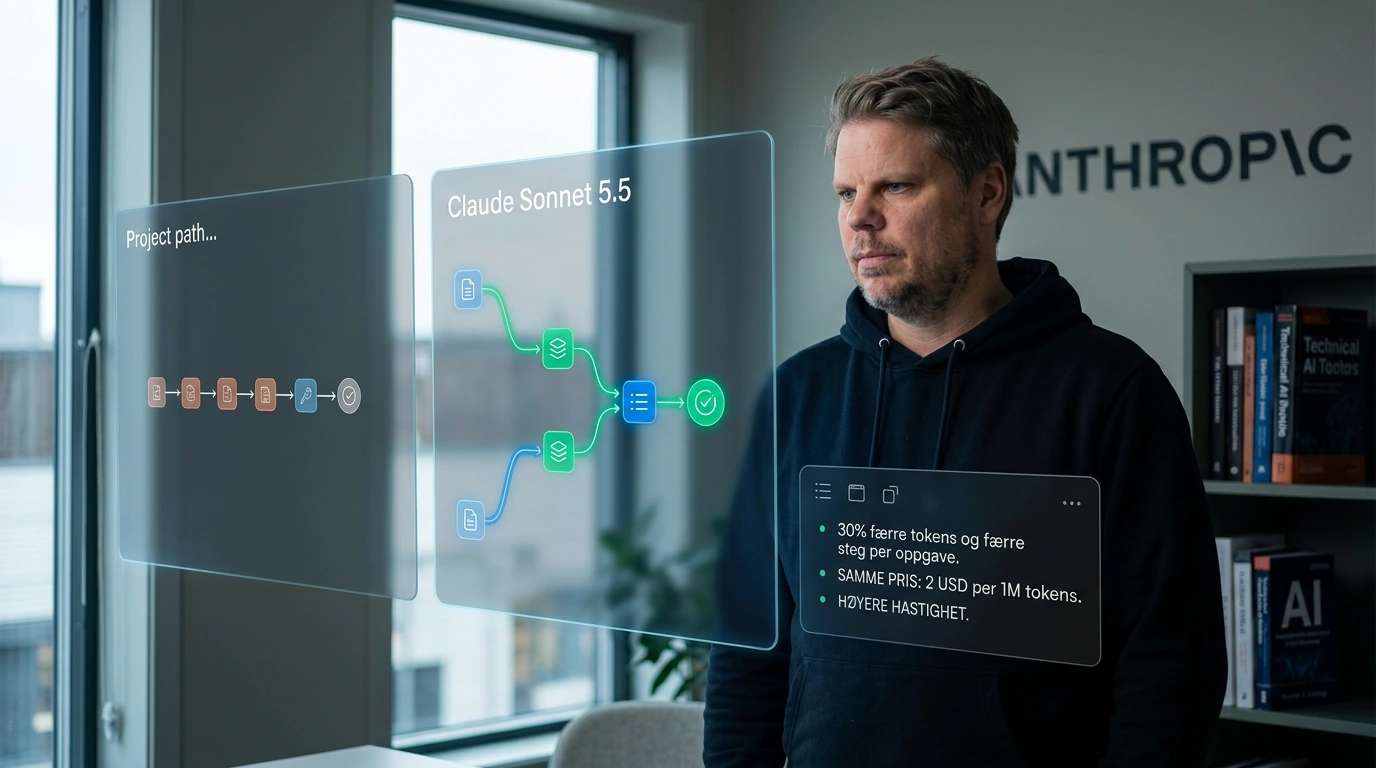
Claude Sonnet 5.5 er laget for deg som vil få mer arbeid ut av hver krone og slippe å vente like lenge på svar. Anthropic oppgir at modellen genererer tekst over 30 prosent raskere enn Sonnet 5 og kan koste opptil 30 prosent mindre per oppgave. Det siste er viktig: Prisen per token er ikke satt ned. Modellen skal rett og slett bruke færre tokens på å bli ferdig.
Det er en langt mer interessant forbedring enn enda en tabell med benchmark-tall. Når en AI-agent skriver kode, undersøker dokumenter eller lager en presentasjon, betaler du ikke for en plassering på en resultatliste. Du betaler for alle stegene, verktøykallene, feilsporene og forsøkene fram til jobben faktisk er gjort.
Sonnet 5.5 er derfor ikke først og fremst en billigere modell på papiret. Den er Anthropics forsøk på å gjøre mellommodellen til det fornuftige arbeidsverktøyet for avgrensede hverdagsoppgaver, mens Opus 5.5 fortsatt skal ta de åpne oppgavene som krever mer skjønn. Hvis påstandene holder i vanlig bruk, er dette akkurat den typen modelloppgradering bedrifter og utviklere faktisk merker.
Hva er Claude Sonnet 5.5?
Claude Sonnet 5.5 er den andre modellen i Claude 5.5-familien og en raskere, rimeligere makker til Opus 5.5. I lanseringen 28. september 2026 beskriver Anthropic den som sterkest på tydelig avgrensede oppgaver, feilretting, dokumenter, presentasjoner og regneark.
Plasseringen i modellfamilien er ganske enkel. Opus er fortsatt ment for komplisert, åpent arbeid som krever vedvarende vurdering. Sonnet skal være raskere å samarbeide med når oppgaven allerede har et klart mål. Haiku 5.5 skal komme i løpet av de neste ukene og ta den mest kostnadsfølsomme bruken med høyt volum.
Tre måneder etter Sonnet 5 fortsetter Anthropic å flytte mer agentarbeid ned i den rimeligere modellklassen. Jeg skrev tidligere om hvordan Opus 4.6 og Agent Teams pekte i den retningen. Sonnet 5.5 gjør skillet tydeligere: Sonnet for avgrenset arbeid i volum, Opus for de åpne oppgavene.
Hvor mye raskere og billigere er den?
Anthropic oppgir over 30 prosent høyere genereringsfart og opptil 30 prosent lavere kostnad per oppgave enn med Sonnet 5. API-listen er likevel uendret: 2 dollar per million input-tokens og 10 dollar per million output-tokens. Med en dollarkurs på omtrent 9,51 kroner tilsvarer det cirka 19 kroner inn og 95 kroner ut.
Cache-lesing koster 0,20 dollar per million tokens, cirka 1,90 kroner. Sammenlignet med Opus 5.5 er Sonnet-prisen halvparten: Opus koster 4 dollar inn og 20 dollar ut per million tokens. Det er lett å se hvorfor Sonnet kan være et bedre standardvalg for store mengder rutinearbeid, selv når Opus fortsatt er sterkere på de vanskelige oppgavene.
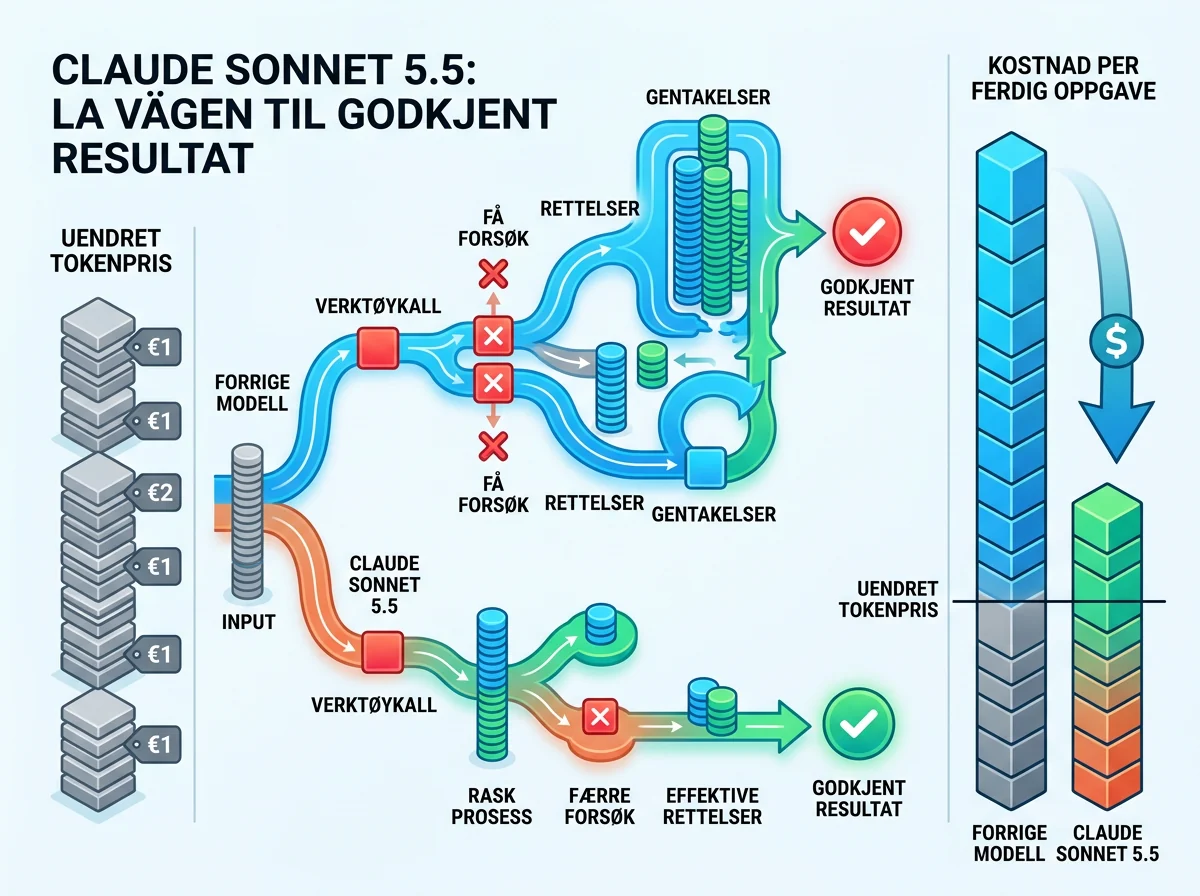
Men «opptil 30 prosent billigere» betyr ikke at fakturaen automatisk faller med 30 prosent. Besparelsen kommer fordi Sonnet 5.5 ifølge Anthropic bruker færre tokens og færre steg for å løse den samme oppgaven. Den virkelige gevinsten vil derfor variere med promptene, verktøyene, effort-nivået og hvor mange ganger agenten må prøve på nytt.
Hvorfor betyr færre tokens mer enn en lavere listepris?
En modell kan være billig per token og fortsatt bli dyr hvis den tenker i ring, søker unødvendig, gjør for mange verktøykall eller må rette opp sitt eget arbeid. Derfor er kostnad per ferdig oppgave et bedre mål enn prisen på én million tokens. Den forteller noe om hele arbeidsløpet, ikke bare meterprisen på teksten.
De tidlige kundetestene Anthropic har valgt ut, peker i samme retning. Slack rapporterer omtrent 14 prosent færre output-tokens uten å endre promptene. Lovable så rundt en tredel færre verktøykall og omtrent halvparten så mange shell-kjøringer. I 118 appbygg brukte Base44 i gjennomsnitt 3,6 iterasjoner per bygg med Sonnet 5.5, mot 7,7 med Opus 5.
Det mest oppsiktsvekkende eksempelet kommer fra Balyasny Asset Management. På 2 441 interne finansoppgaver brukte Sonnet 5.5 rundt 121 000 tokens per svar, mot 497 000 for Sonnet 5. Det er leverandørvalgte eksempler fra tidlige testere, ikke en garanti for din arbeidsflyt. Likevel viser de hva som må måles: ferdige oppgaver, tokenbruk, verktøykall, ventetid og feil – ikke bare hvor modellen havner på en benchmark.
Hva er Sonnet 5.5 laget for?
Sonnet 5.5 er først og fremst laget for avgrenset kunnskapsarbeid med mange gjentakelser. Det kan være å rette konkrete kodefeil, analysere dokumenter, behandle supportsaker, lage presentasjoner etter en mal eller oppdatere et regneark. På slike oppgaver kan fart og lavere tokenbruk være viktigere enn den siste resten av resonnementsevne.
Anthropic framhever også koding. Tidlige testere beskriver raskere forståelse av kodebaser, færre mislykkede verktøykall og bedre evne til å samle flere verktøykall i samme steg. Det høres lovende ut for Claude Code og andre agentløp, men det er fremdeles selskapets lanseringsmateriale. En modell som arbeider raskere, kan også gjøre feil raskere.
Jeg ville derfor ikke byttet ut Opus i alle arbeidsflyter over natten. Start med oppgaver der fasiten kan kontrolleres: tester som kan kjøres, dokumenter som kan sammenlignes med en mal eller saker som allerede har en tydelig godkjenningsport. Mål deretter hvor ofte jobben blir ferdig uten ny runde. Det er først da du vet om lavere tokenbruk faktisk gir lavere kostnad.
Kan Sonnet 5.5 erstatte Opus 5.5?
Sonnet 5.5 kan erstatte Opus 5.5 på mange avgrensede oppgaver, men Anthropic sier selv at Opus fortsatt er klart sterkere på komplisert, åpent arbeid som krever vedvarende skjønn. Sonnet er et arbeidsjern. Opus er modellen du henter fram når veien til målet ikke allerede er rimelig tydelig.
Det interessante er at Sonnet på lave og middels effort-nivåer ifølge Anthropic kan levere mye kapasitet for pengene. I Claude-appene og Claude Code er Medium standard. På Claude Platform er High standard. Lavere effort gir raskere og kortere svar, mens høyere nivåer lar modellen bruke mer tid og kontrollere arbeidet grundigere.
Det gir en praktisk modellstrategi: Bruk Sonnet som standard for oppgaver med klart omfang, og eskaler til Opus når problemet er uklart, dyrt å gjøre feil på eller krever flere runder med selvstendig vurdering. Det er også slik Anthropics fleragent-opplegg for Code Review blir mest interessant: Den dyreste modellen trenger ikke gjøre alle deloppgavene dersom en raskere modell kan utføre det avgrensede arbeidet godt nok.

Hva med sikkerhet og begrensninger?
Sonnet 5.5 har ifølge Anthropic cyberkapasiteter på nivå med Opus 5. Det gjør den til den første Sonnet-modellen som lanseres med tilsvarende cybervern og fallback-mekanismer som selskapets kraftigste modeller. Vanlig utvikling og feilretting skal fungere som før, mens enkelte forespørsler med høy risiko kan bli sendt tilbake til Sonnet 5.
Biologivernet er det samme som i Sonnet 5. Modellen får også nye tiltak mot industriell distillering, der aktører bruker store mengder falske kontoer for å hente ut egenskapene til en modell. Anthropic sier at de fleste utviklere ikke vil merke dette, men flytting av samtaler mellom kontoer – blant annet kontobytte midt i en Claude Code-økt – kan påvirkes av såkalt preserved thinking.
Dette er verdt å kjenne til før en automatisering flyttes. Bedre modellkvalitet fjerner ikke behovet for minst mulige tilganger, logger, tester og menneskelig godkjenning før irreversible handlinger. Fart er en fordel når agenten gjør riktig jobb. Den er ikke en sikkerhetsmekanisme.
Hvor er Claude Sonnet 5.5 tilgjengelig?
Claude Sonnet 5.5 er tilgjengelig på Anthropics egne plattformer og gjennom Amazon Web Services, Google Cloud og Microsoft Azure. Utviklere bruker modellnavnet claude-sonnet-5-5 på Claude Platform. Den finnes også på OpenRouter som anthropic/claude-sonnet-5.5. Modellen kan brukes med null datalagring på Anthropics plattformer for arbeidsflyter som har behov for det.
Det finnes én konkret migreringsdetalj utviklere bør få med seg. Hvis Sonnet kjøres med thinking slått av, må integrasjonen bytte til innstillingen between_tools før overgangen til 5.5. Den beholder den innledende tenkingen avslått, men lar modellen tenke mellom verktøykall. Anthropic beskriver endringen i den offisielle migreringsguiden for Sonnet 5.5.
Det er også lurt å kontrollere effort-nivået i samme runde. En arbeidsflyt som får andre standardinnstillinger på plattformen enn i Claude Code, kan gi en annen kostnad og responstid enn forventet. Kjør noen representative oppgaver, noter total tokenbruk og sammenlign kvaliteten på sluttresultatet før modellen får hele køen.
Er dette en oppgradering som faktisk betyr noe?
Ja – dersom Sonnet 5.5 faktisk gjør den samme jobben med færre steg. Over 30 prosent høyere fart er fint, men kombinasjonen av kortere ventetid, færre tokens og uendret tokenpris er det som kan flytte regnestykket. På en enkelt chat merkes det som bedre flyt. I tusenvis av agentoppgaver kan det bli reelle penger.
Samtidig kommer tallene fra Anthropic og utvalgte tidlige kunder. Jeg vil se hvordan modellen oppfører seg i ordinære kodebaser og automatiseringer, særlig når verktøy feiler og oppgaven varer lenge. Benchmarkene kan fortelle at kapasiteten er der. De forteller ikke om modellen blir stabil nok i akkurat din arbeidsflyt.
Det fornuftige er å prøve Sonnet 5.5 på tydelig avgrenset arbeid, måle kostnad per godkjent resultat og beholde Opus til oppgavene som trenger mer skjønn. Hvis Sonnet leverer like godt med færre tokens og færre omveier, har Anthropic truffet noe langt mer nyttig enn en pyntet modelltabell.
Ofte stilte spørsmål
Er Claude Sonnet 5.5 billigere enn Sonnet 5?
API-prisen per token er den samme: 2 dollar per million input-tokens og 10 dollar per million output-tokens, cirka 19 og 95 kroner. Anthropic sier likevel at Sonnet 5.5 kan koste opptil 30 prosent mindre per oppgave fordi den normalt bruker færre tokens og færre steg.
Hva er forskjellen på Sonnet 5.5 og Opus 5.5?
Sonnet 5.5 er raskere og koster halvparten per token. Den er laget for godt avgrensede hverdagsoppgaver. Opus 5.5 er fortsatt Anthropics valg for komplisert, åpent arbeid som krever mer tid, helhetsforståelse og vedvarende skjønn.
Hva heter Sonnet 5.5 i API-et?
Modellnavnet på Claude Platform er claude-sonnet-5-5. Anthropic oppgir at modellen også er tilgjengelig gjennom Amazon Web Services, Google Cloud og Microsoft Azure. Kontroller migreringsguiden dersom integrasjonen kjører med thinking avslått.
Bør jeg bytte alle Claude-arbeidsflyter til Sonnet 5.5?
Nei, start med avgrensede oppgaver der resultatet kan kontrolleres. Mål kostnad per godkjent oppgave, tokenbruk, ventetid og antall nye forsøk. Behold Opus til uklare eller risikofylte oppgaver som trenger mer selvstendig vurdering.