Innhold Vis
Hvis du lager en stemmeagent, er Qwen-Audio-3.1-Realtime interessant av én enkel grunn: Modellen er trent til å avgjøre om den skal tenke, bruke et verktøy, svare eller holde munn. Det siste høres kanskje trivielt ut. I en ekte samtale er det helt avgjørende.
En stemmeassistent kan ha flott lyd og lav forsinkelse, men fortsatt være ubrukelig hvis den svarer på TV-en i bakgrunnen, avbryter brukeren eller begynner å prate før et verktøykall er ferdig. Alibaba prøver å løse hele denne koordineringen i samme modell. I selskapets tekniske rapport faller svar på bakgrunnstale fra 73 til 13 prosent sammenlignet med Qwen-Audio-3.0-Realtime.
Det er den typen forbedring jeg følger med på. Ikke fordi ett leverandørtall beviser at modellen fungerer i din resepsjon, bil eller kundeservice, men fordi målingen treffer et problem brukeren faktisk merker. Qwen-Audio-3.1-Realtime er tilgjengelig som driftet API under modell-ID-en qwen-audio-3.1-realtime-plus. Den er ikke presentert som en lokal modell du laster ned og kjører selv.
Hva er Qwen-Audio-3.1-Realtime?
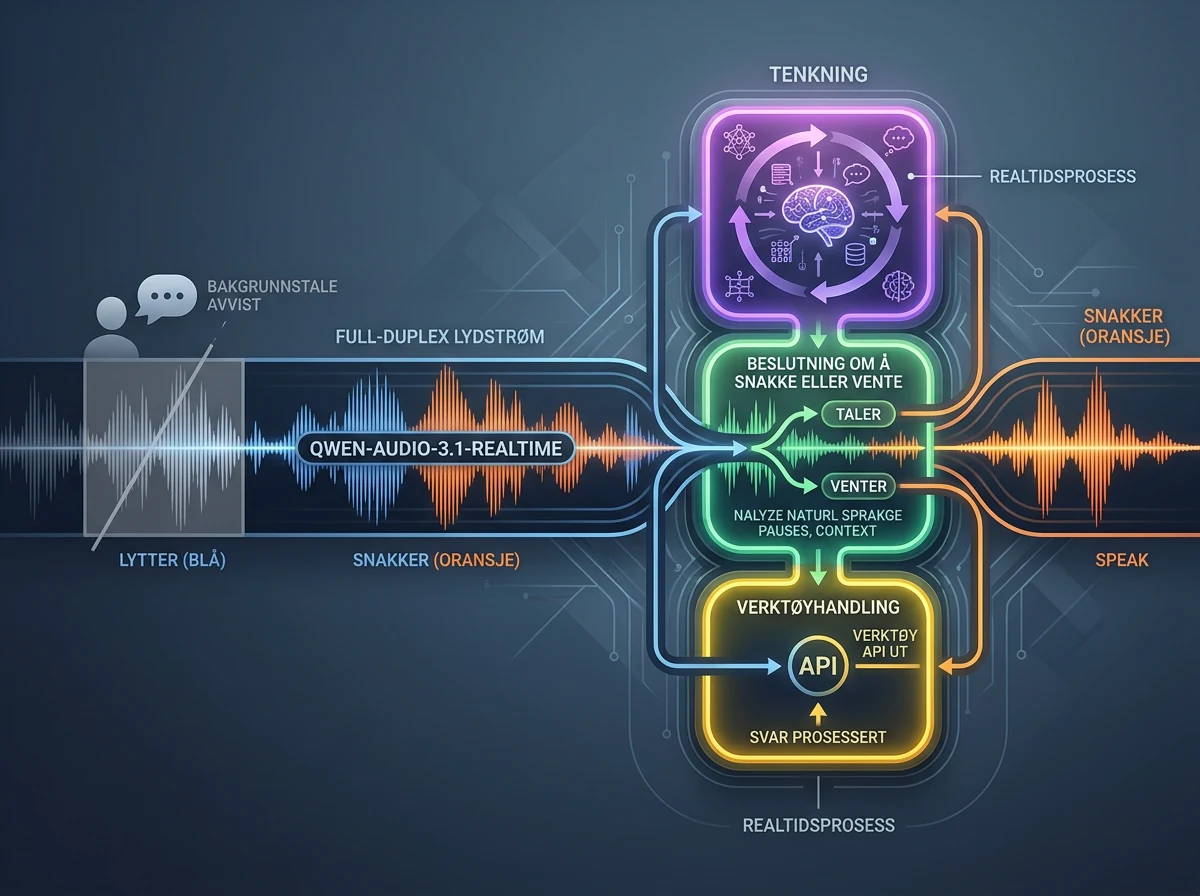
Qwen-Audio-3.1-Realtime er en full-duplex tale-til-tale-modell for sanntidssamtaler. Den kan motta lyd mens den selv snakker, håndtere avbrytelser og bruke funksjonskall. I den tekniske rapporten beskriver Qwen-teamet systemet gjennom tre deler: Think, Act og Speak and Coordinate.
Think-delen skal forstå tale, følge instruksjoner over flere runder og holde orden på krav som endrer seg underveis. Act-delen skal velge og bruke verktøy, lese svaret fra verktøyet og fullføre oppgaven. Speak and Coordinate handler om samspillet: når modellen skal svare, når den skal vente, og om neste steg bør være tale eller handling.
Dette er en annen jobb enn ren talegjenkjenning eller tekst til tale. En tradisjonell kjede kan transkribere stemmen, sende teksten til en språkmodell og lese svaret høyt. Qwen-Audio-3.1-Realtime er laget for selve samtalen, der lyd, turbytte, verktøykall og svar må henge sammen mens brukeren fortsatt er til stede.
Modellen støtter tekst og lyd inn, samt tekst og lyd ut. Den offisielle produktsiden hos QwenCloud oppgir også function calling, web search, flerspråklige samtaler og en kontekst på 262 144 tokens. Websøk og function calling kan imidlertid ikke være aktivert samtidig. Det er en konkret begrensning du må ta høyde for i agentdesignet.
Hvorfor betyr full-duplex mer enn raskere tale?
Full-duplex betyr at begge sider kan sende lyd samtidig. Modellen trenger ikke behandle samtalen som walkie-talkie, der den ene parten må bli helt ferdig før den andre får begynne. For en god stemmeagent gir det mulighet til å bli avbrutt, oppfatte små bekreftelser og vente når brukeren åpenbart ikke er ferdig.
Men en åpen mikrofon slipper inn mer enn brukerens kommando. Andre mennesker snakker, en podcast står på, noen roper fra et annet rom, og modellen hører kanskje sin egen lyd fra høyttaleren. Derfor er tallet for bakgrunnstale viktig: På Full-Duplex-Bench v1.5 rapporterer Qwen-teamet at modellen svarte på bakgrunnstale i 13 prosent av tilfellene, mot 73 prosent for forrige versjon.
Det er en reduksjon på 60 prosentpoeng. Likevel er 13 prosent ikke null. I en demo kan det se imponerende ut at modellen lytter hele tiden. I produksjon kan ett uønsket svar være nok til å forvirre kunden eller starte feil handling. Resultatet bør derfor leses som et lovende tegn på bedre turstyring, ikke som tillatelse til å droppe testing, bekreftelser og tydelige grenser for hva agenten får gjøre.
Qwen-teamet måler også såkalt over-interruption, altså at modellen stopper sin egen tale når den ikke burde. Den offisielle presentasjonen samler resultatene under ideen om at modellen skal styre hvordan, når og om den snakker. Det er egentlig kjernen i hele lanseringen. En stemmeagent trenger ikke bare en stemme. Den trenger folkeskikk.
Kan modellen faktisk utføre oppgaver?
Qwen-Audio-3.1-Realtime er trent for verktøybruk og oppgaver som utvikler seg gjennom en samtale. På Qwen-teamets halv-duplex, tale-til-tekst-tilpasning av tau-Voice steg samlet oppgavesuksess fra 78,4 til 82,0 prosent. Det tilsvarer 3,6 prosentpoeng over Qwen-Audio-3.0-Realtime.
Fordelingen sier mer enn totalen. Resultatet for flyoppgaver steg fra 64,0 til 74,0 prosent, butikkoppgaver fra 72,8 til 73,7 prosent og telekomoppgaver fra 90,4 til 93,9 prosent. Dette er scenarioer der agenten må forstå en muntlig bestilling, følge begrensninger og bruke verktøy for å komme fram til et faktisk resultat.
Her må bremselyset på. Rapporten sier uttrykkelig at tau-Voice-resultatet kommer fra en halv-duplex tale-til-tekst-tilpasning, ikke benchmarkens offisielle full-duplex tale-til-tale-oppsett. Tallene kan derfor ikke sammenlignes direkte med offisielle tau-Voice-resultater fra andre systemer. Alibaba har dessuten evaluert sin egen modell. Det gjør ikke resultatet verdiløst, men det gjør uavhengig testing nødvendig.
Verktøybruk er også mer enn å velge riktig funksjonsnavn. Agenten må sende fornuftige argumenter, forstå feilmeldingen, prøve igjen når det er riktig og aldri late som handlingen lyktes før den faktisk gjorde det. På SpeechFCEval steg nøyaktigheten fra 83,28 til 86,00 prosent. Bedre, ja. Ferdig, nei.
Qwen-teamets interne WebSearch1K-test viser dessuten en interessant avveining. Gjennomsnittlig antall søkespørringer falt fra 4,37 til 1,05, mens F1-resultatet samtidig sank fra 60,87 til 58,61 prosent. Modellen søker altså langt mindre, men traff litt svakere på når søk skulle utløses. Færre verktøykall er bare en gevinst når modellen fortsatt kaller riktig verktøy til riktig tid.
Hvordan kobler du til API-et?
Den tilgjengelige modellen heter qwen-audio-3.1-realtime-plus og leveres gjennom QwenCloud og Alibaba Cloud Model Studio. Den offisielle Realtime API-dokumentasjonen oppgir støtte for AOQ, WebRTC og WebSocket. Valget handler om hvor klienten kjører og hvilke nettverksforhold den skal tåle.
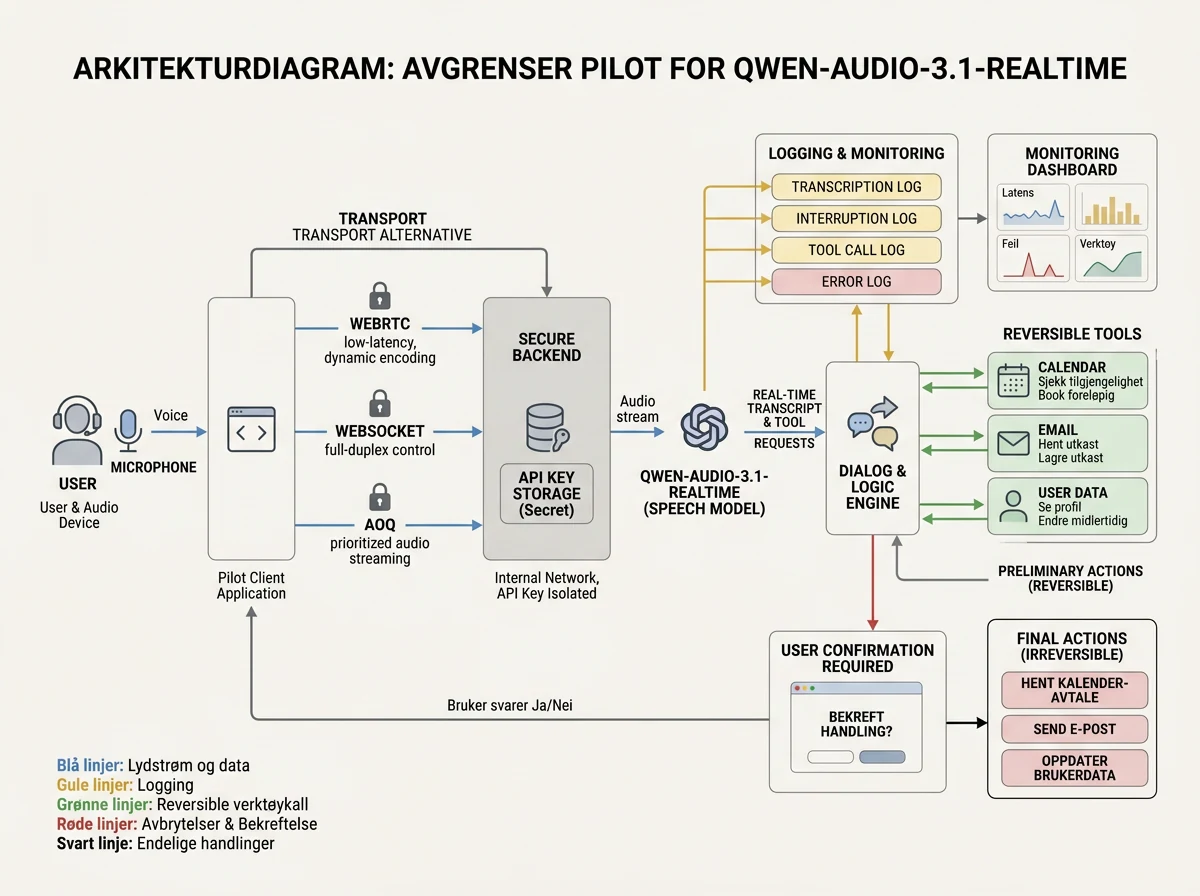
WebSocket er den enkleste inngangen for serverbaserte prototyper og støttes på de fleste plattformer. Ulempen er at klienten selv må håndtere ekkokansellering og støyreduksjon. WebRTC passer bedre i nettleser og vanlige lyd- og videosamtaler, mens AOQ er Alibabas transport for mobile sanntidsopplevelser og svake nettverk. Dokumentasjonen oppgir innebygd ekkokansellering og støyreduksjon for både AOQ og WebRTC.
Den offisielle Python-koden åpner en WebSocket mot wss://maas.qwencloudapi.com/api-ws/v1/realtime?model=qwen-audio-3.1-realtime-plus og sender lyd fortløpende. API-nøkkelen skal ligge på serveren, ikke bygges inn i appen. For nettleser- eller mobilklienter bør backend utstede kortvarig tilgang i stedet for å sende hovednøkkelen ut til brukeren.
Modellen har en kontekstgrense på 262 144 tokens, maksimalt 245 760 tokens inn og 16 384 tokens ut. Standardgrensen er 60 forespørsler og 100 000 tokens per minutt i både Singapore- og Beijing-regionen. Det er romslig for utvikling, men samtidighet, lange samtaler og lydtrafikk kan spise kvoten raskere enn en enkel tekstchat.
Jeg ville startet med en avgrenset pilot: ett språk, noen få verktøy og handlinger som kan reverseres. Logg transkripsjon, valgte verktøy, argumenter, verktøysvar, avbrytelser og hvorfor modellen begynte å snakke. Test med TV-lyd, to personer i rommet, dårlig mikrofon og brukere som endrer bestillingen midt i en setning. Det er der full-duplex enten blir nyttig eller bare dyr bakgrunnsstøy.
Hva koster Qwen-Audio-3.1-Realtime?
I Singapore-regionen koster tekst inn 0,80 dollar per million tokens, lyd inn 6,40 dollar, tekst ut 6,40 dollar og lyd ut 24 dollar per million tokens. Med siste tilgjengelige referansekurs 28. september 2026 på omtrent 9,51 kroner per dollar blir det cirka 8, 61, 61 og 228 kroner per million tokens. Prisene står i den offisielle modelloversikten hos Alibaba Cloud.
Lyd ut er klart dyrest. Det betyr at en prissammenligning basert bare på teksttokens blir misvisende for en stemmeagent. Hvor mange minutter en million audiotokens tilsvarer, avhenger av leverandørens tokenisering og lydflyt. Jeg ville derfor målt faktisk kostnad per fullført samtale i piloten, ikke forsøkt å selge inn prosjektet med en pen pris per million.
Beijing-regionen har lavere listepriser: 0,688 dollar for tekst inn, 5,501 dollar for lyd inn og tekst ut, samt 20,628 dollar for lyd ut per million tokens. Det tilsvarer cirka 7, 52, 52 og 196 kroner med samme kurs. Region er likevel ikke bare en prisbryter. Forsinkelse, tilgjengelighet, avtalevilkår og hvor lyddata behandles må vurderes sammen. Den billigste regionen kan bli den dyreste hvis samtalen føles treg eller databehandlingen ikke passer kravene dine.
Hva er de viktigste begrensningene?
Først: Dette er leverandørens egne resultater og en driftet tjeneste. Det er ikke publisert modellvekter du kan kjøre lokalt, og QwenCloud-siden oppgir Alibaba Cloud Model Studio som leverandør av inferensen. For virksomheter med sensitive samtaler er region, datalagring, logging og kontraktsvilkår en del av modellvalget.
Andre begrensning er at de to mest iøynefallende tallene må holdes fra hverandre. 82,0 prosent oppgavesuksess ble målt i et halv-duplex tale-til-tekst-oppsett. Fallet fra 73 til 13 prosent for bakgrunnstale ble målt på Full-Duplex-Bench v1.5 med tale til tale. De dokumenterer to ulike sider av systemet, men de er ikke én samlet ende-til-ende-test av din ferdige agent.
Tredje begrensning er selve handlingsevnen. En stemmeagent som kan kalle verktøy kan også bestille feil vare, endre feil reservasjon eller bekrefte noe den ikke har gjort. Derfor bør irreversible handlinger ha eksplisitt bekreftelse, idempotente API-kall og tydelige tillatelser. Modellen kan gjerne bestemme når den skal snakke. Den bør ikke alene bestemme hvor mye skade et feil verktøykall får gjøre.
Jeg er forsiktig positiv. Sammenlignet med Qwen-Audio-3.0-TTS, som først og fremst lager stemmen ut, prøver 3.1 Realtime å ta ansvar for hele samtaleflyten. Og sammenlignet med Grok Voice Think Fast 2.0, der fart og pris stod sentralt, er Qwens mest spennende påstand at agenten blir bedre til å la være å svare.
Det høres nesten komisk ut at en AI-modell må trenes hardt for å holde munn når andre snakker. Samtidig er det kanskje det mest menneskelige problemet i hele stemmeagent-markedet.
Qwen-Audio-3.1-Realtime er dermed verdt en pilot for utviklere som trenger sanntidstale, avbrytelser og verktøykall i samme flyt. Men bygg piloten rundt feilene, ikke bare demoen: bakgrunnstale, endrede instrukser, mislykkede verktøy og handlinger som krever bekreftelse. Hvis modellen består den testen i ditt miljø, begynner dette å ligne en nyttig agent i stedet for en høyttaler med språkmodell.
Ofte stilte spørsmål
Er Qwen-Audio-3.1-Realtime tilgjengelig nå?
Ja. Den driftede modellen er tilgjengelig via QwenCloud og Alibaba Cloud Model Studio med modell-ID-en qwen-audio-3.1-realtime-plus. Du trenger API-nøkkel og kobler til gjennom AOQ, WebRTC eller WebSocket. Det er ikke oppgitt åpne modellvekter for lokal kjøring.
Kan Qwen-Audio-3.1-Realtime bruke verktøy?
Ja. Modellen støtter function calling og er trent til å velge verktøy, tolke resultatet og fortsette oppgaven i samtalen. QwenCloud oppgir også web search, men dokumentasjonen sier at websøk og function calling ikke kan aktiveres samtidig i samme oppsett.
Hva betyr full-duplex for en stemmeagent?
Full-duplex betyr at modellen kan lytte mens den snakker. Dermed kan brukeren avbryte, endre en bestilling eller komme med korte bekreftelser uten å vente på en stiv turveksling. Løsningen krever fortsatt god håndtering av ekko, støy og tale fra andre personer.
Hvor mye koster lyd i Qwen-Audio-3.1-Realtime?
I Singapore-regionen koster lyd inn 6,40 dollar og lyd ut 24 dollar per million tokens, omtrent 61 og 228 kroner med siste tilgjengelige referansekurs 28. september 2026. Mål kostnad per faktisk samtale, fordi audiotokens ikke uten videre kan oversettes til et fast antall minutter.