Innhold Vis
Ming-Image-0.1-Design gjør AI-generert design langt mer interessant ved å kombinere en åpen 6B-bildemodell med en egen modell som kan dele et ferdig design opp i redigerbare lag. Det siste er poenget. En flat PNG er fin å se på, men håpløs når logoen skal flyttes, bakgrunnen byttes eller et enkelt element skal brukes videre.
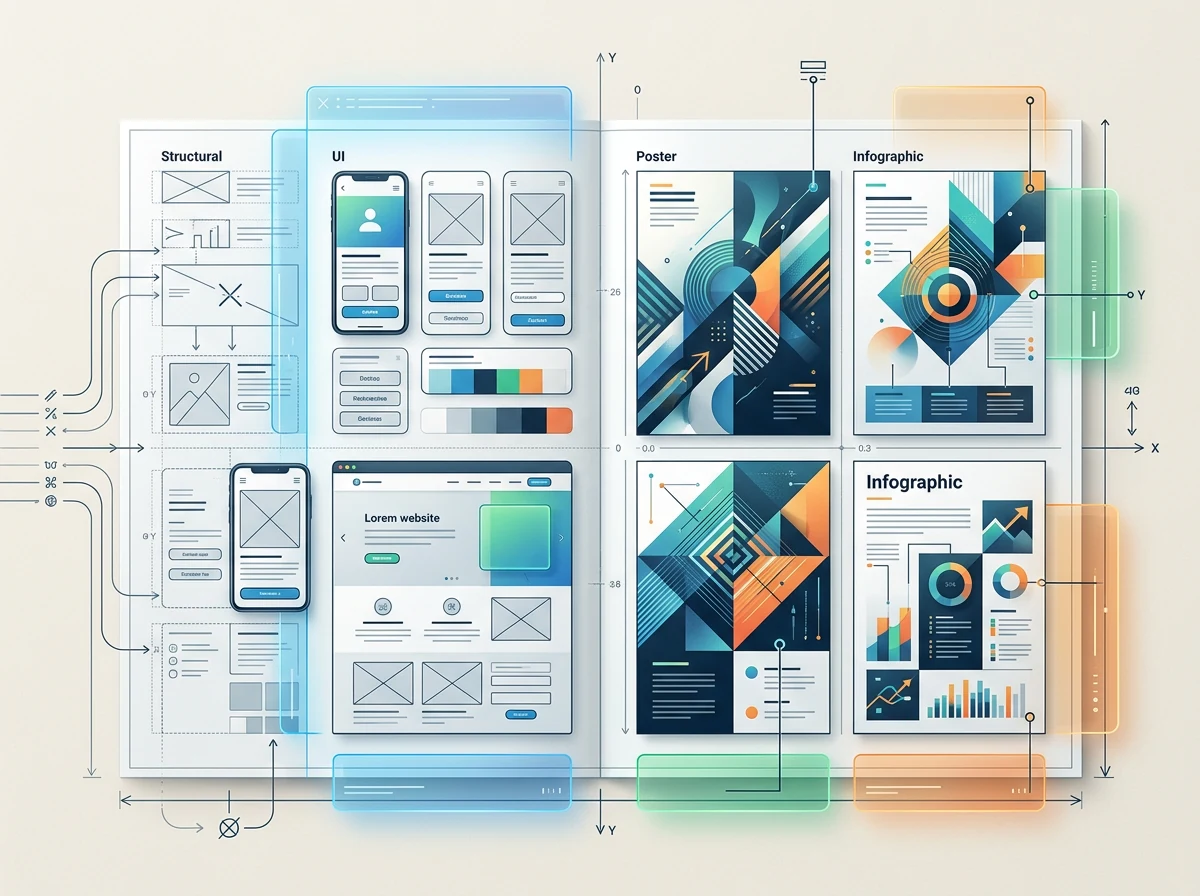
inclusionAI har sluppet to modeller under MIT-lisens. Ming-Image-0.1-Design lager komplette komposisjoner for blant annet UI, infografikk og plakater. Søstermodellen Ming-Image-0.1-Design-Layer tar et flatt design og en plan for lagene, og leverer separate RGBA-filer med gjennomsiktighet.
Dette er en retning jeg har savnet i bildegenerering. Flere pene bilder er ikke nødvendigvis det verden trenger mest akkurat nå. Flere resultater som faktisk kan plukkes fra hverandre, endres og brukes videre i en arbeidsflyt? Ja takk. Men 6B-navnet kan gi et litt for optimistisk inntrykk av hvor lett dette er å kjøre lokalt. Den validerte konfigurasjonen krever én CUDA-GPU med 80 GiB minne.
Hva er Ming-Image-0.1-Design?
Ming-Image-0.1-Design er en familie med to åpne modeller på 6 milliarder parametre. Den ene genererer komplette design, mens den andre bryter et eksisterende design ned i selvstendige lag. Begge modellene og inferenskoden er offentlig tilgjengelige gjennom inclusionAIs Ming-Image-repository og er utgitt med MIT-lisens.
Genereringsmodellen er laget for visuell design, ikke først og fremst naturtro fotografier. Den retter seg mot grensesnitt, plakater, infografikk og andre strukturerte komposisjoner. Modellen kan levere både vanlige bilder og RGBA-resultater med gjennomsiktig bakgrunn. Det gjør den mer aktuell for designarbeid enn en generell modell som bare spytter ut et ferdig, flatt motiv.
Den anbefalte oppløsningen er 2 048 x 2 048 piksler, med 1 024 x 1 024 som raskere alternativ. Standardoppsettet bruker 12 samplingsteg, CFG på 1,0 og BF16. Prompten kan først utvides til en strukturert beskrivelse av lerret, koordinater, farger og lag ved hjelp av Ling-3.0-flash-VL eller Qwen3.8-27B, men denne promptutvidelsen skjer utenfor selve inferensprogrammet.
Hvorfor er lagmodellen den store nyheten?
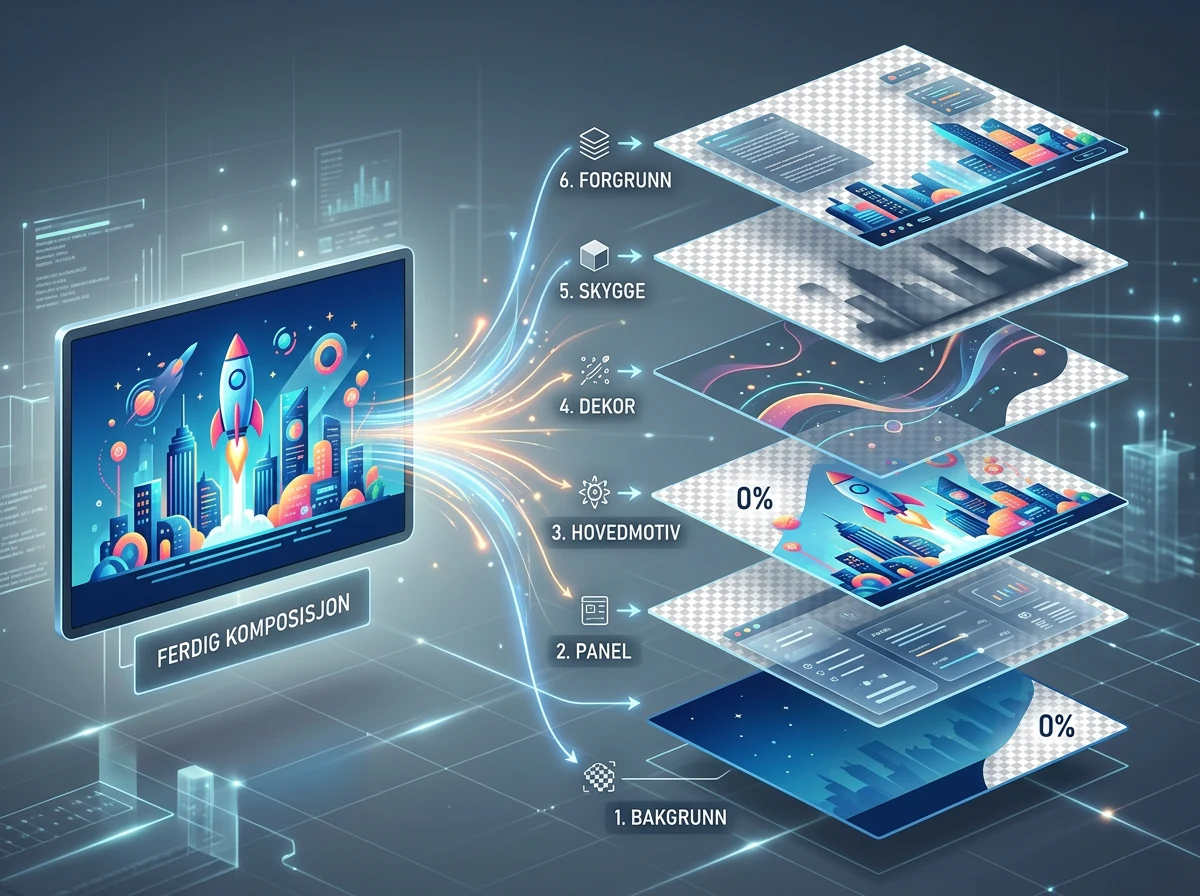
Ming-Image-0.1-Design-Layer kan gjøre en flat designfil om til et ønsket antall gjennomsiktige RGBA-lag. Du gir modellen et bilde og en lagplan, og får separate PNG-filer tilbake. Det offisielle eksemplet deler et kortdesign i seks lag som kan settes sammen igjen til originalen.
Forskjellen er praktisk. Vanlig bildegenerering gir deg sluttproduktet, omtrent som et fotografi av et ferdig skrivebord. Lagmodellen forsøker å gi deg delene på bordet hver for seg. Forgrunnselementer, hovedmotiv, paneler og bakgrunn kan dermed behandles separat i stedet for å være permanent bakt inn i samme pikselmatte.
Du kan enten skrive en detaljert spesifikasjon for hvert lag eller angi hvor mange lag du vil ha. Gir du en egen prompt, er antallet i prompten styrende. Uten prompt kan kommandoen bruke --num-layers N og lage en standardforespørsel. Modellen produserer først en samlet versjon og deretter de separate lagene; inferensverktøyet hopper over den første og lagrer resten som layer_01.png, layer_02.png og så videre.
Dette er ikke det samme som en ferdig Figma- eller PowerPoint-fil med perfekte, semantiske objekter. Et RGBA-lag er fremdeles et bilde. Men det er et mye bedre utgangspunkt for videre redigering, compositing og automatisering enn én låst PNG. Det kan også bli et nyttig mellomledd i agenter som skal lage design, kontrollere resultatet og rette bare den delen som bommet.
Kan Ming-Image kjøres lokalt?
Ja, Ming-Image kan kjøres lokalt, men den publiserte og validerte konfigurasjonen krever én CUDA-GPU med minst 80 GiB VRAM i BF16. Det er en viktig begrensning. Seks milliarder parametre høres ut som noe mange entusiaster kan laste på et godt forbrukerkort, men hele pipelinen er tyngre enn parameterantallet alene antyder.
For tekst-til-bilde anbefaler utviklerne 2 048-oppløsning og 12 steg. Lagmodellen bruker en arbeidsoppløsning på 1 024 som standard, eller 512 for raskere kjøring, også med 12 steg. Den bevarer sideforholdet fra kildebildet. Begge modellene kan kjøres fra en lokal checkpoint eller direkte fra en Hugging Face-ID, og utviklerne anbefaler vLLM-Omni for servering.
Det betyr at «open source» og «lokal» er sant, men ikke at dette er plug-and-play på maskinen under skrivebordet. Foreløpig er den dokumenterte ruten laget for kraftige arbeidsstasjoner eller server-GPU-er. Kvantisering, optimalisering og støtte i verktøy som ComfyUI kan endre regnestykket senere, men det er ikke dokumentert i den første utgivelsen. Ikke kjøp maskinvare på håp og en Reddit-overskrift.
Installasjonen er ellers ganske rett fram på papiret: klon repositoryet, installer requirements.txt og kjør infer.py med riktig modell og oppgave. Python 3.10 eller nyere og en CUDA-kompatibel PyTorch-installasjon er påkrevd. FlashAttention 2 er valgfritt. Standardvalget er eager, og dokumentasjonen advarer om at --attn-implementation sdpa stopper ved innlasting fordi språkmodelldelen ikke støtter den modusen.
Hva sier resultatlistene?
Ved lanseringen viste inclusionAI et resultat der Ming-Image-0.1-Design lå øverst blant modeller med åpne vekter i UI/UX-kategorien hos Artificial Analysis. Det er et positivt signal for en modell som er så tydelig rettet mot design, og den aktuelle UI/UX-resultatlisten hos Artificial Analysis er stedet å kontrollere rangeringen etter hvert som flere stemmer og modeller kommer inn.
Jeg ville likevel ikke valgt modell på dette alene. Resultatlister må fortelle hvor mange sammenligninger som ligger bak, hvilke modeller som faktisk er med, og om du ser på hele feltet eller bare modeller med åpne vekter. En førsteplass i et avgrenset utvalg betyr ikke automatisk at modellen slår alle kommersielle alternativer eller passer best til akkurat din grafiske profil.
Enda viktigere: lagdekomponering er en annen oppgave enn å vinne en blind smakstest på ferdige bilder. For den modellen viser inclusionAI egne resultater på Crello-testsettet, der lavere RGB L1 og høyere Alpha soft IoU er bedre. Tabellen er publisert som et bilde i modellkortet, ikke som en detaljert, maskinlesbar evaluering. Jeg vil se uavhengige tester og virkelige designfiler før jeg trekker store konklusjoner.
Hvordan skiller dette seg fra vanlig bilderedigering?
Vanlig AI-bilderedigering prøver ofte å endre hele bildet eller et maskert område og genererer deretter en ny, flat fil. Ming-Image-0.1-Design-Layer angriper problemet tidligere i arbeidsflyten: Den forsøker å hente ut byggesteinene som separate lag, slik at senere endringer kan gjøres mer målrettet.
Det gjør ikke vanlige bildeeditorer overflødige. Jeg har tidligere skrevet om Qwen Image Edit 2511 for lokal bilderedigering. En editor er riktig verktøy når du vil endre motivet. Lagdekomponering er mer interessant når du vil demontere komposisjonen og bygge videre på delene. Det er beslektede oppgaver, men ikke samme jobb.
Lanseringsomtalen trekker også fram to åpne agent-skills: Ling UI Design Skill og Image-to-Editable-PPT Skill. Ideen er henholdsvis en arbeidsflyt fra prompt eller skjermbilde til kode og nettleserkontroll, og en arbeidsflyt som bygger en redigerbar presentasjon fra et flatt lysbilde. Den offisielle Ming-Image-koden dokumenterer foreløpig modellene og inferensen, men gir ikke en komplett, samlet bruksvei for disse to skillene. Jeg ville derfor vurdert dem som tilhørende prosjekter som må kontrolleres hver for seg, ikke som ferdige funksjoner inne i modellen.
Hva bør du teste før du bygger på modellen?
Start med egne design, ikke galleriet til leverandøren. For genereringsmodellen bør du måle hvor ofte komposisjonen følger den strukturerte prompten, hvor stabilt elementene plasseres og hvor mye manuelt arbeid som gjenstår. For lagmodellen bør du se etter kanter, skygger, gjennomsiktighet og elementer som havner i feil lag.
Test også om lagene faktisk kan settes sammen igjen uten synlige sømmer. Be om både få og mange lag fra det samme bildet. En modell som lager seks filer er ikke nødvendigvis nyttig hvis motivet er delt på en måte som gjør videre redigering verre. Det avgjørende er ikke antallet lag, men om inndelingen følger måten en designer faktisk vil arbeide på.
Til slutt bør du måle tid og minnebruk på maskinvaren du har tenkt å bruke. Den offisielle konfigurasjonen er 80 GiB VRAM, og det finnes ingen offentlig API-pris i modellkortet. MIT-lisensen fjerner lisensavgiften, men drift, GPU-tid og integrasjonsarbeid er fortsatt reelle kostnader. Åpne vekter betyr frihet til å bygge. Det betyr ikke gratis produksjon.
Dette er en modellfamilie det er verdt å følge
Ming-Image-0.1-Design er lovende fordi inclusionAI har rettet den mot et konkret problem: design som skal videre i en arbeidsflyt. Genereringsmodellen lager komposisjonen, og lagmodellen kan gjøre resultatet mindre låst. Den kombinasjonen er mer nyttig enn en vanlig lansering som bare lover litt penere bilder.
Jeg er forsiktig med å anbefale den som et lokalt førstevalg før den er testet bredere og kan kjøres på mer tilgjengelig maskinvare. Den dokumenterte 80 GiB-konfigurasjonen er ingen liten fotnote. Resultatlisten er heller ikke en erstatning for egne tester, særlig når arbeidsoppgaven er lagdeling og ikke bare hvilket ferdigbilde folk foretrekker.
Likevel: MIT-lisens, åpne vekter, offentlig inferenskode og en egen modell for redigerbare lag er en skikkelig utgivelse. Hvis miljøet får ned minnekravet og bygger gode integrasjoner rundt lagene, kan dette bli langt mer enn en modell folk laster ned, ser på og glemmer. Redigerbarhet er veien fra AI-demo til verktøy. Det er her Ming-Image treffer noe viktig.
Ofte stilte spørsmål
Er Ming-Image-0.1-Design gratis å bruke?
Modellene og koden er utgitt under MIT-lisens, så det er ingen lisenspris for å laste dem ned og bruke dem. Du må likevel betale for egen maskinvare, GPU-tid eller skytjeneste, og modellkortet oppgir foreløpig ingen offentlig API-pris.
Hvor mye VRAM trenger Ming-Image-0.1-Design?
Den minste validerte konfigurasjonen i den offisielle dokumentasjonen er én CUDA-GPU med minst 80 GiB VRAM i BF16. Det kan komme lettere oppsett senere, men utgivelsen dokumenterer ikke en ferdig løsning for vanlige forbrukerkort.
Kan lagmodellen lage en redigerbar Figma- eller PowerPoint-fil?
Ikke direkte. Ming-Image-0.1-Design-Layer lager separate RGBA-bilder etter en lagplan. Det er nyttig for videre redigering og automatisering, men lagene må fortsatt settes inn i et design- eller presentasjonsverktøy av en egen arbeidsflyt.
Hva er forskjellen på de to Ming-Image-modellene?
Ming-Image-0.1-Design genererer komplette visuelle design fra en prompt. Ming-Image-0.1-Design-Layer tar et eksisterende, flatt design og deler det opp i et ønsket antall gjennomsiktige lag som kan behandles hver for seg.