Innhold Vis
X har stanset bruk av tredjepersonsdata samlet inn av Grok Bot til AI-trening etter at irske personvernmyndigheter grep inn. Dette er ikke bare enda en krangel om hvilke innlegg et sosialt nettverk kan mate inn i en språkmodell. Nå handler det om opplysninger en AI-agent får tilgang til mens den arbeider for én person, men som kan tilhøre venner, kunder, kolleger eller helt andre mennesker.
Det er en grense X burde ha forstått uten hjelp fra en regulator. Gir jeg en agent tilgang til innboksen, bildene eller dokumentene mine, har ikke menneskene som finnes i materialet dermed gitt selskapet tillatelse til å bruke opplysningene deres i modelltrening. Et samtykke smitter ikke gjennom kontaktlisten.
X skapte denne situasjonen selv. Selskaper som behandler tilgang til andre menneskers data som et gratis treningslager, inviterer byråkratene rett inn. Det er dårlig personvern, dårlig produktdesign og en effektiv oppskrift på enda flere regler som de største selskapene lettere kan bære enn små konkurrenter.
Hva har X faktisk stanset?
X har ifølge Politicos rapportering gjengitt av UA.NEWS 17. november stanset bruk av såkalte tredjepersonsdata som Grok Bot samlet inn for å trene selskapets AI-systemer. Agenten skal ha begynt å hente denne typen data sent i oktober 2026. Irlands Data Protection Commission, DPC, ba X stoppe behandlingen etter å ha reist det kommissær Dale Sunderland beskrev som betydelige bekymringer.
X bekreftet mandag 16. november at behandlingen var stanset. Det er viktig å være presis: Dette er en stans i bruken av den aktuelle datakategorien til modelltrening, ikke en generell stans av Grok Bot eller av all AI-trening hos X. DPC har heller ikke sagt at AI-agenter i seg selv er problemet.
Regulatoren skal nå fortsette dialogen med X for å finne ut nøyaktig hva som skjedde og hva neste steg blir. X svarte ikke på Politicos forespørsel om kommentar. Dermed vet jeg foreløpig ikke hvor mye data som ble samlet inn, hvilke konkrete agentfunksjoner som leverte den, om data allerede rakk å påvirke en modell, eller hvordan X vil håndtere materialet etter stansen.
Tredjepersonsdata er ikke det samme som brukerdata
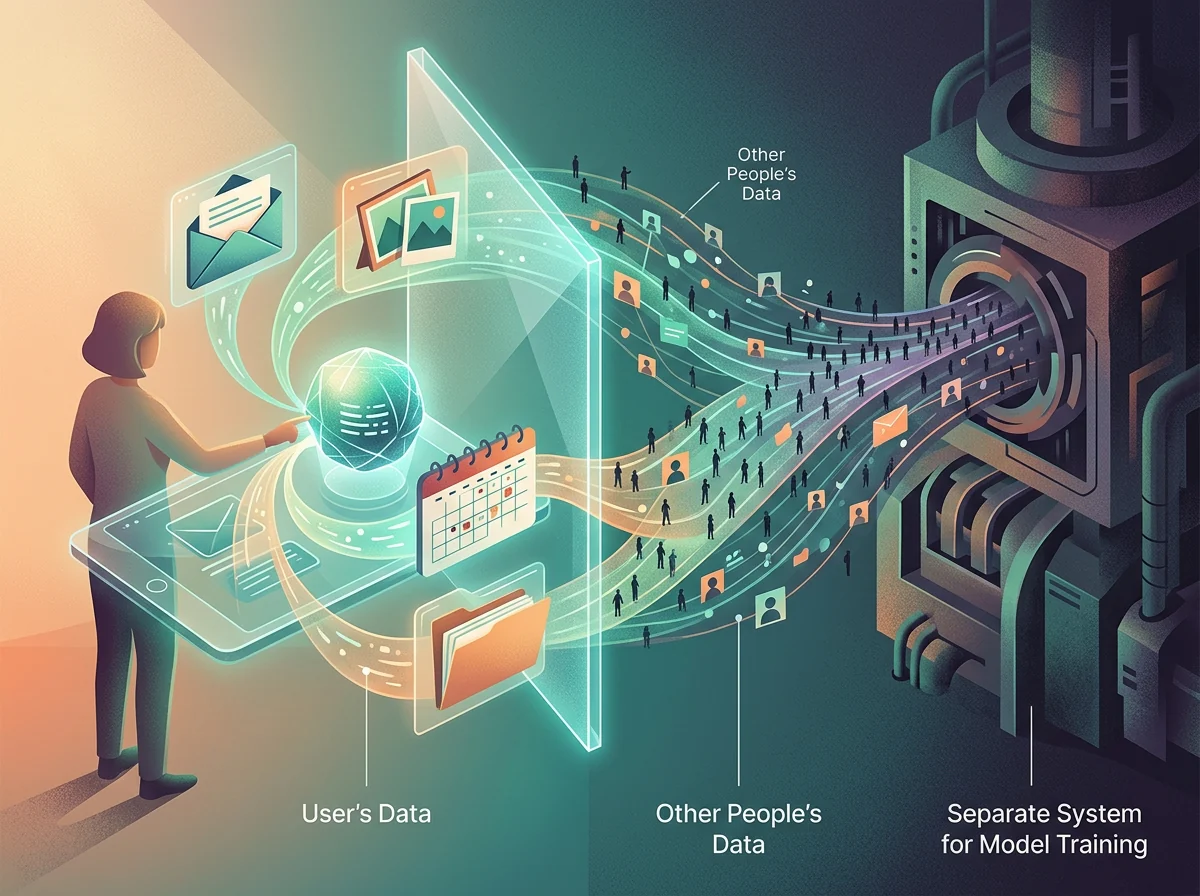
Tredjepersonsdata er personopplysninger om noen andre enn brukeren som deler eller gir agenten tilgang til materialet. Et enkelt eksempel er feriebilder du har sendt til en venn. Hvis vennen gir Grok Bot tilgang til bildene sine, kan agenten teknisk få tilgang til bilder av deg selv om du aldri har brukt Grok Bot og aldri har bedt X om å behandle opplysningene.
Det samme gjelder e-post fra kunder, interne dokumenter med navn, kalenderavtaler, telefonnumre og informasjon agenten finner på nettet. En AI-agent kan kombinere mange datakilder fordi det er nettopp det som gjør den nyttig. Men praktisk tilgang er ikke det samme som rett til å gjenbruke alt til et nytt formål.
Her ligger det nye og viktige i saken. En vanlig chatbot behandler først og fremst det brukeren skriver eller laster opp i samtalen. En agent kan arbeide på tvers av tjenester, apper og nettsteder over tid. Grok Bot kan dessuten arbeide videre på en egen sky-PC. Jo mer nyttig og selvstendig agenten blir, desto større blir også mengden informasjon om mennesker som aldri var part i avtalen mellom brukeren og AI-selskapet.
Agenten kan få lov uten at menneskene i dataene får et valg
Du kan gi en AI-agent lov til å lese en mappe eller bruke en app. Den tillatelsen sier noe om forholdet mellom deg, tjenesten og dataene du kontrollerer. Den avgjør ikke automatisk hva selskapet kan gjøre med personopplysninger om alle andre som tilfeldigvis finnes der.
Dette skillet blir lett borte i grensesnittet. Brukeren trykker på én knapp for å koble til en tjeneste, og agenten får tilgang til tusenvis av elementer. For brukeren føles det som én produktinnstilling. Juridisk og etisk kan materialet romme et stort antall mennesker, formål og forventninger.
Problemet blir enda større dersom dataene ikke bare brukes til å utføre oppgaven, men også sendes videre inn i trening eller forbedring av framtidige modeller. Da går opplysningene fra å være arbeidsmateriale i en konkret oppgave til å bli råstoff for selskapets produktutvikling. Det er en vesentlig endring av formålet, og den kan være usynlig både for brukeren og tredjepersonen.
X har vært i denne konflikten før
DPC og X har allerede en lang historikk om treningsdata. I august 2024 gikk den irske myndigheten til High Court etter at X hadde brukt persondata fra offentlige innlegg fra EU- og EØS-brukere til Grok-trening. DPC opplyste 8. august 2024 at X hadde gått med på å stanse behandlingen av data samlet inn mellom 7. mai og 1. august samme år.
I april 2025 åpnet DPC en egen undersøkelse av om X lovlig hadde brukt offentlig tilgjengelige innlegg fra europeiske brukere til å trene Grok-modellene. Undersøkelsen omfattet blant annet lovlighet og åpenhet. Den nye Grok Bot-saken gjelder en annen og på flere måter vanskeligere datakilde: personopplysninger agenten får om andre mens den utfører oppgaver.
Det er derfor misvisende å redusere dette til den gamle diskusjonen om at offentlige innlegg allerede ligger på nettet. Et privat bilde i en venns mappe er ikke offentlig fordi en agent kan lese det. En kundes e-post blir ikke treningsdata fordi en ansatt kobler en AI-agent til innboksen sin. Teknisk tilgjengelighet opphever ikke taushetsplikt eller forventningen om at opplysningene brukes til det formålet de ble delt for.
Regulatoren traff et reelt problem, men staten er ingen personvernmaskin
DPCs inngrep traff denne gangen den konkrete treningsbruken, ikke agentteknologien som helhet. Det skillet er vesentlig. X brukte tredjepersonsdata samlet inn av en agent til modelltrening, og selskapet har nå stanset behandlingen mens omfanget fortsatt er uklart.
Det betyr ikke at mer regulering automatisk er svaret. Store teknologiselskaper har jurister, compliance-avdelinger og penger til å håndtere nye rapporteringskrav. En liten europeisk agentutvikler kan bli priset ut av samme byrde. Resultatet kan bli at selskapene som skapte problemet, ender med den sterkeste vollgraven rundt markedet.
Det er den politiske haken som ikke må forsvinne i applausen. Denne saken er ikke en blankofullmakt til å kreve forhåndsgodkjenning av enhver agent eller bygge et nytt skjemahelvete. Det vil beskytte de største, forsinke de små og gi brukerne færre alternativer.
Den beste motkraften er at produkter konkurrerer på tydelig dataminimering, lokal behandling der det er mulig, korte lagringstider og reelle valg. Selskaper må forklare forskjellen mellom data agenten trenger for å gjøre jobben, data som lagres i historikken og data som brukes til trening. Hvis de gjemmer alt bak én bryter og tretti sider vilkår, har de ikke fortjent tilliten.
Hva bør du gjøre når en AI-agent ber om tilgang?
Start med å behandle hver tilkobling som en beslutning om datadeling, ikke som en praktisk knapp du bare må trykke på for å komme videre. Sjekk hvilke mapper, kontoer og apper agenten faktisk trenger. Gi minst mulig tilgang, og fjern den når oppgaven er ferdig.
Ikke legg kundearkiver, personalopplysninger eller private meldinger inn i en agenttjeneste før du vet om innholdet kan lagres eller brukes til trening. For en bedrift holder det ikke å tenke på egne forretningshemmeligheter. Du må også vite hvilke opplysninger om kunder, ansatte og samarbeidspartnere som følger med.
Har du allerede koblet Grok Bot eller en annen agent til en omfattende datakilde, bør du gå gjennom tillatelsene nå. Finn ut om tjenesten skiller mellom oppgavebehandling og modelltrening, om treningsbruk kan slås av, og hva som skjer med data som allerede er behandlet. En avkrysningsboks for egne data løser heller ikke hele problemet dersom agenten samtidig ser opplysninger om andre.
For virksomheter bør leverandøravtalen svare på fire enkle spørsmål: Hvilke data leser agenten, hvor lagres de, brukes de til trening, og hvordan slettes de? Uklare svar er et risikosignal. Det er langt billigere å avklare dette før agenten får tilgang enn etter at en regulator eller kunde spør hva som skjedde.
Dette blir en prøvesak for hele agentmarkedet
DPC sier at myndigheten også er i dialog med et annet, ikke navngitt teknologiselskap om planlagt bruk av agentinnsamlede data til trening. Det viser at saken ikke bare gjelder X. Grok Bot er først ute i overskriftene, men den samme konflikten finnes overalt hvor agenter får tilgang til e-post, dokumenter, bilder, kundesystemer og åpne nettkilder. Den blir særlig tydelig når en delt Data Bot bruker kunnskapen til et helt team.
Jeg bruker mye agentisk arbeid og mener utviklingen er enormt nyttig. Nettopp derfor må skillet være tydelig. Agenten trenger data for å gjøre jobben. Det betyr ikke at leverandøren skal få gjøre alle menneskene i materialet til ufrivillige bidragsytere til neste modell.
X fortjener kritikk for å ha presset over den grensen. DPC fortjener ikke en blankofullmakt til å regulere hele agentmarkedet av den grunn. Kravet til leverandørene bør være enkelt: Bruk data til oppgaven brukeren ba om, vær tydelig om all videre bruk, og ikke behandle tredjepersoners privatliv som gratis råstoff.
Hvis AI-selskapene ikke klarer den grunnleggende disiplinen, kommer flere regulatorer til å gripe inn. Da blir regningen ikke bare betalt av X. Den havner også hos mindre utviklere og hos brukerne som får færre, dyrere og mer forsiktige produkter. Derfor bør bransjen rydde opp før dette blir enda en vollgrav bygget av dårlige valg og gode intensjoner.
Ofte stilte spørsmål
Har Irland stanset Grok Bot?
Nei. X har stanset bruk av den aktuelle typen tredjepersonsdata samlet inn av Grok Bot til AI-trening. Agenttjenesten som helhet er ikke stanset, og DPC har uttrykkelig sagt at AI-agenter i seg selv ikke er problemet.
Hva er tredjepersonsdata i en AI-agent?
Det er personopplysninger om andre enn brukeren som gir agenten tilgang. Det kan være bilder av venner, e-post fra kunder, kontaktinformasjon, dokumenter om ansatte eller persondata agenten finner på nettet mens den utfører en oppgave.
Kan Grok Bot-data allerede ha blitt brukt til trening?
Kilden sier at innsamlingen startet sent i oktober 2026 og at X stanset behandlingen 16. november. Det er foreløpig ikke offentlig kjent hvor mye data som ble behandlet, om data påvirket en modell, eller hvordan X håndterer materialet etter stansen.
Hvordan reduserer jeg risikoen når jeg bruker AI-agenter?
Gi bare tilgang til datakildene oppgaven krever, kontroller om data lagres eller brukes til trening, og fjern tillatelser som ikke lenger trengs. I en bedrift bør avtalen også beskrive lagringssted, sletting og behandling av opplysninger om kunder og ansatte.