AI-Modeller
Anthropic på vei mot første overskudd – 10,9 milliarder dollar i kvartalsinntekter
Anthropic varsler første kvartal med driftsoverskudd og mer enn dobling av inntektene til 10,9 milliarder dollar. Her er hva det betyr.
Utforsk arkivet
Her tester og vurderer jeg AI-modellene som faktisk betyr noe. Fra Claude og GPT til Gemini, Llama og lokale modeller du kan kjøre på din egen maskin. Ingen PR-prat – bare ærlige erfaringer fra en som bruker disse verktøyene hver eneste dag. Hva funker, hva funker ikke, og hva er bare hype?
Anthropic varsler første kvartal med driftsoverskudd og mer enn dobling av inntektene til 10,9 milliarder dollar. Her er hva det betyr.
Stability AI lanserer Stable Audio 3 med tre open-weights modeller for musikk og lydeffekter. Kjører lokalt på MacBook, 120 sekunder på under 6 sekunder.
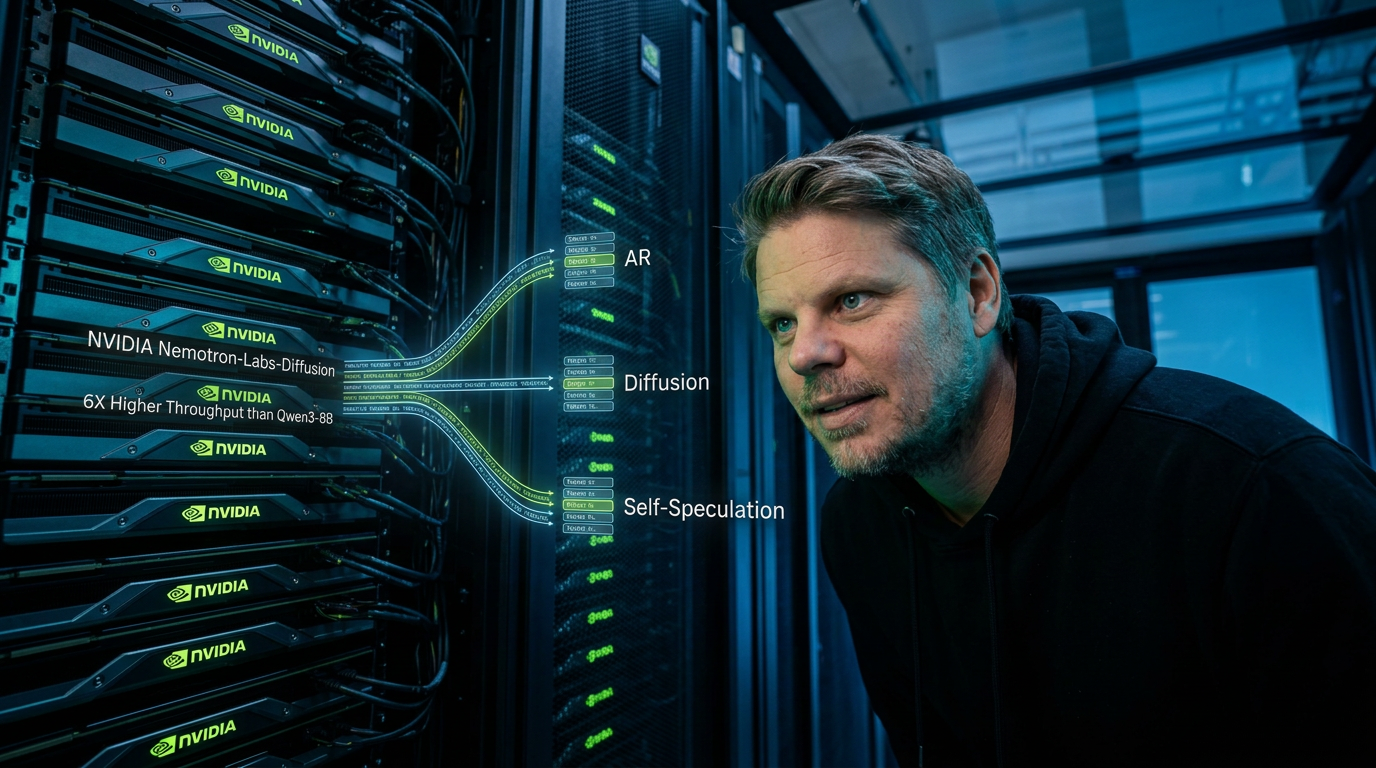
NVIDIA har sluppet Nemotron-Labs-Diffusion - en språkmodell som kombinerer tre dekodingsmodus i én arkitektur og leverer 6× høyere gjennomstrøm enn Qwen3-8B.
Carbon-3B fra Hugging Face er en open source DNA foundation model som matcher Evo2-7B på alle benchmarks, men er 275 ganger raskere. Her er…
Noen kjørte DeepSeek V4 Flash lokalt på fire brukte RTX 2080 Ti-er til under 25 000 kr - og fikk 255 prefill tokens per…
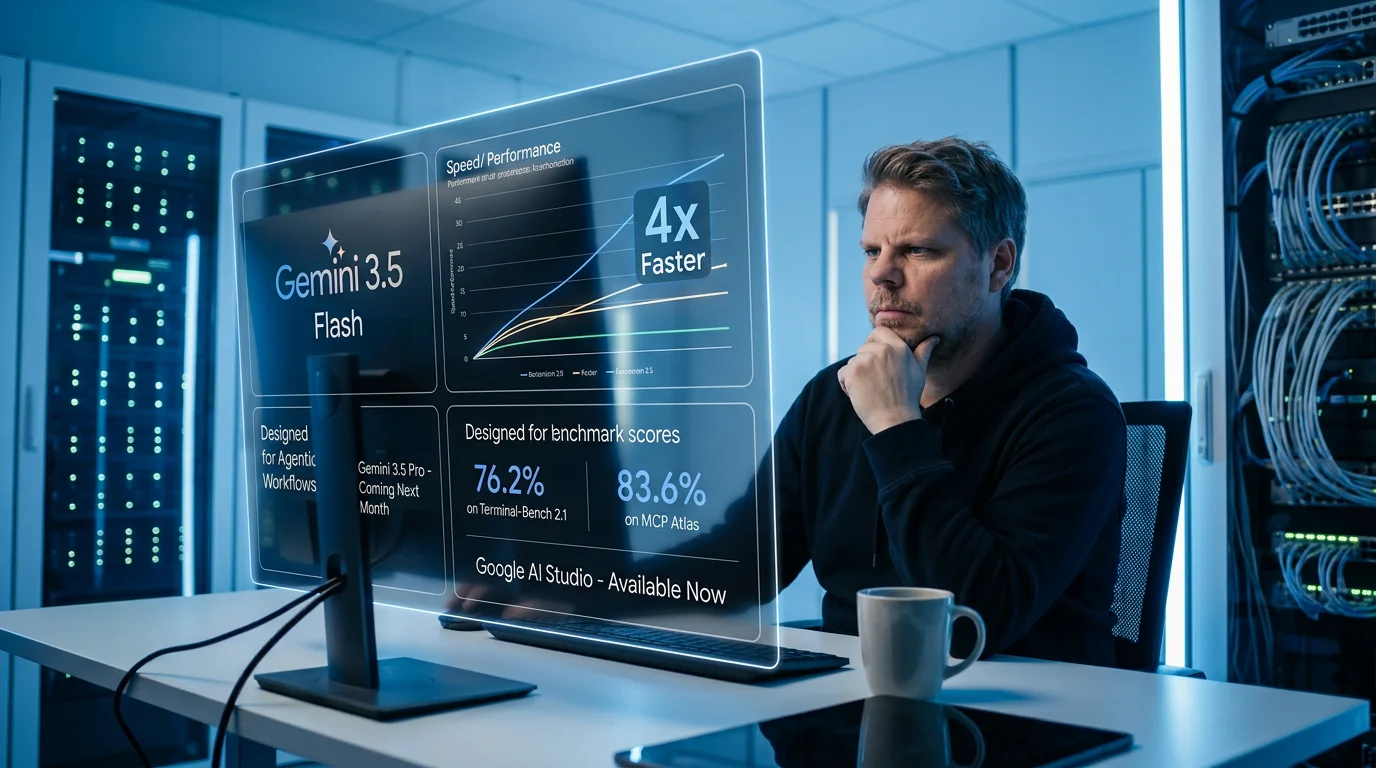
Gemini 3.5 Flash er lansert - 4x raskere enn andre frontiermodeller, og bygget for agentic workflows. Her er hva som er nytt og hva…
Sapient Intelligence trente HRM-Text 1B på 40 milliarder tokens med 16 GPUer på under 2 dager. Resultatet: bedre enn Llama 3.2 3B på MATH…

NVIDIA Cosmos Predict 2.5 kan fine-tunes med LoRA på 92 videoer. Fra 2,1 til 3,8 i instruction following-score - og du trenger bare én…
DystopiaBench testet 42 LLM-er på 36 eskalerende scenarier - fra uskyldig spørring til "bygg et sosialt kredittssystem". Funnene om closed-source-modeller er overraskende.

NVIDIA slipper SANA-WM - en 2,6 milliarder parameter open source videomodell som genererer 60 sekunder 720p-video med presis kamerakontroll på én GPU. Det er…
Lance er ByteDances nye 3B open source-modell som håndterer bildegenerering, videogenerering og bilderedigering i ett system. Apache 2.0-lisens, 40GB VRAM.
llama.cpp b9200 fikser MTP memory traffic overhead. Med riktig konfig på Qwen 3.6 27B mtp doblet draft acceptance rate for Hermes Agent på RTX…
Tre dagers parallell benchmark-kjøring av M5 Max, DGX Spark, AMD Strix Halo og RTX Pro 6000. Her er tallene - og de er ikke…
To RTX 2080 Ti med 22GB VRAM hver gir 38 token/s med Qwen3.6 27B via llama.cpp og Docker. Slik fungerer dual-GPU-oppsett for lokal AI…