Innhold Vis
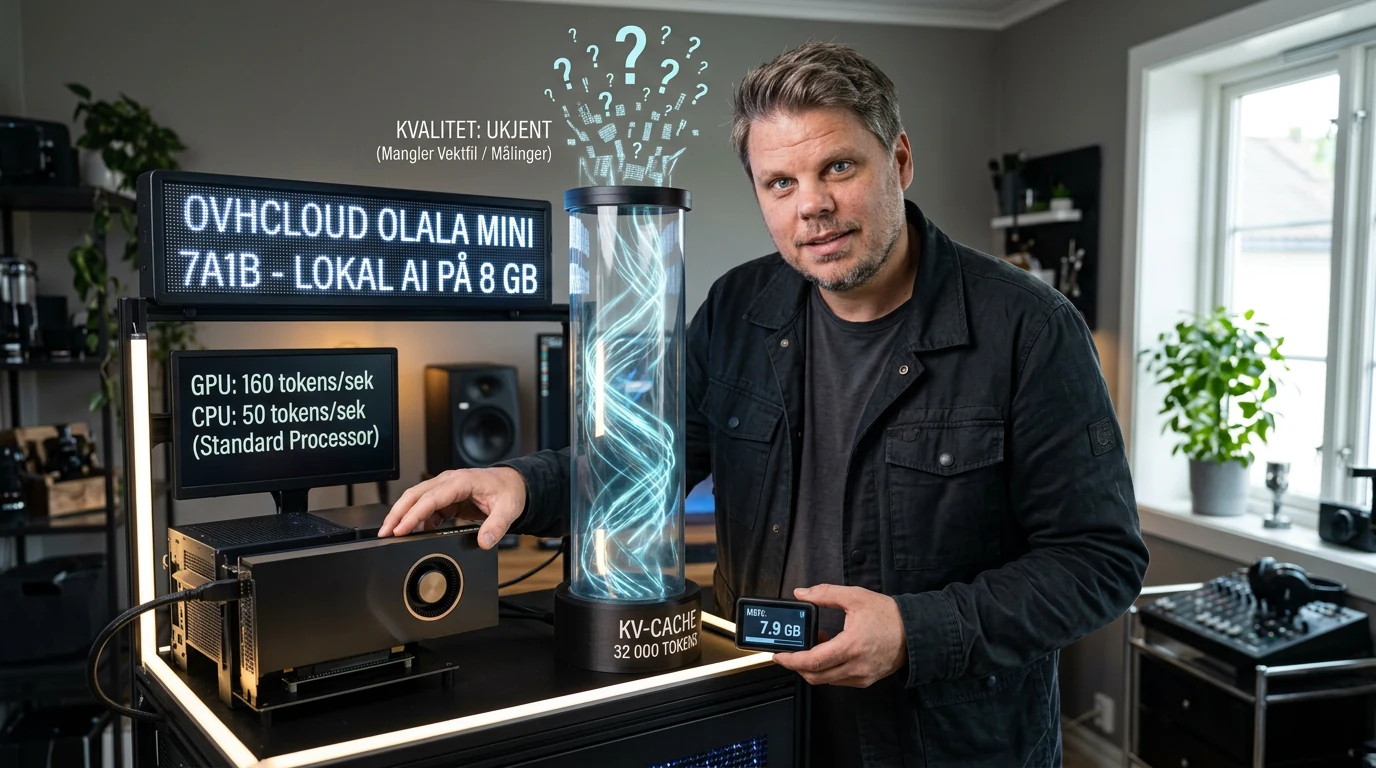
Olala mini 7A1B er OVHclouds første egenutviklede språkmodell, og den er laget for å kjøre lokalt med langt mindre maskinvare enn størrelsen skulle tilsi. OVHcloud hevder at modellen klarer seg med 8 GB GPU-minne, når 160 tokens i sekundet på en RTX A4500 og fortsatt leverer 50 tokens i sekundet på en vanlig prosessor.
Det er tall som gjør modellen praktisk interessant for utviklere, små bedrifter og entusiaster. En lokal modell som svarer raskt uten et dyrt skjermkort kan brukes på langt flere maskiner enn de store modellene som krever et lite kraftverk under skrivebordet.
Men farten er bare halve regnestykket. OVHcloud har foreløpig ikke lagt fram resultater som viser hvor gode svar modellen gir, og selve vektene er ikke ute når dette skrives 17. november. Olala mini er derfor en lovende arkitektur og en lansering å følge med på – ikke en modell jeg kan anbefale på grunnlag av dokumentert kvalitet ennå.
Hva er Olala mini 7A1B?
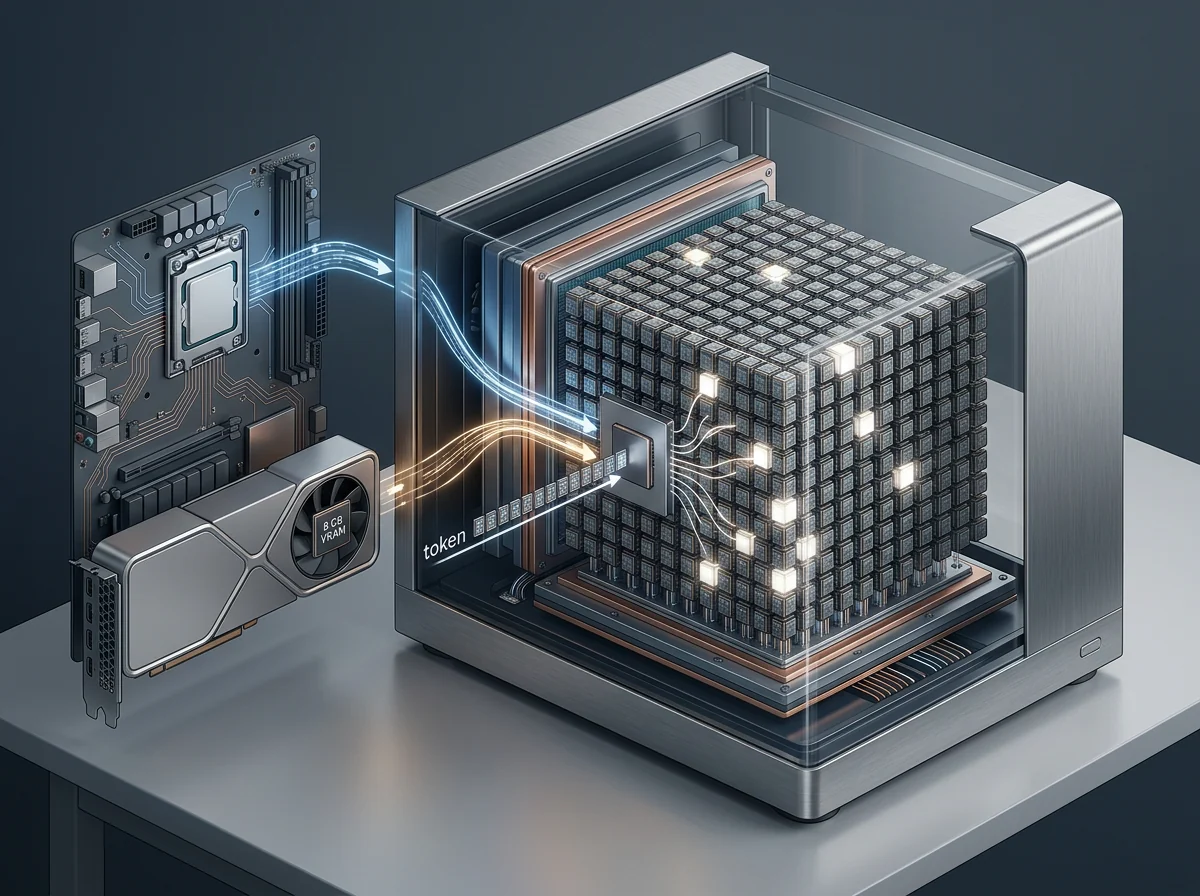
Olala mini 7A1B er en språkmodell med 7 milliarder parametere totalt, men bare 1 milliard aktive parametere for hver forespørsel. Ifølge OVHclouds kunngjøring 17. november 2026 fordeles arbeidet mellom 256 eksperter i hvert lag.
Dette er en Mixture-of-Experts-modell, ofte forkortet MoE. I stedet for å sende hvert token gjennom hele modellen, velger systemet en liten del av de tilgjengelige ekspertene. Tanken er å få mer kapasitet totalt uten å betale hele regningen i minnebruk og beregninger for hvert eneste svar.
Navnet 7A1B beskriver nettopp dette: omtrent 7 milliarder parametere i modellen og 1 milliard aktive. Det gjør ikke modellen automatisk like god som en tett 7B-modell eller like rask som en tett 1B-modell. Arkitekturen forteller hvor mye som arbeider, men ikke hvor godt arbeidet blir gjort.
OVHcloud kombinerer også Differential-TPA med Mamba-3 i en hybrid oppmerksomhetsarkitektur. Den korte forklaringen er at modellen blander vanlig token-oppmerksomhet med en mer strømorientert måte å behandle sekvenser på. Målet er lavere minnebruk og høy fart, særlig når teksten blir lang.
Hvor lite maskinvare trenger modellen?
OVHcloud oppgir 8 GB GPU-minne som minimum og hevder 160 tokens i sekundet på en Nvidia RTX A4500. Enda mer oppsiktsvekkende er påstanden om 50 tokens i sekundet på CPU uten GPU. Alle tre tallene kommer fra OVHcloud og er ikke uavhengig kontrollert.
50 tokens i sekundet på CPU er raskt nok til at teksten normalt kommer fortere enn de fleste klarer å lese. Hvis tallet holder på vanlig tilgjengelig maskinvare, med en brukbar kontekst og uten at kvaliteten faller sammen, kan Olala mini bli aktuell for lokale assistenter, bakgrunnsjobber og enkle agentoppgaver der kostnad og personvern betyr mer enn maksimal intelligens.
Her mangler det likevel viktige detaljer. Pressemeldingen sier ikke hvilken CPU som leverte 50 tokens i sekundet, hvor lang konteksten var, hvor mange samtidige brukere testen hadde eller hvilke innstillinger som ble brukt. «Standard processor» er ikke en maskinvarebeskrivelse noen kan gjenskape. Det er et rundt uttrykk i en pressemelding.
8 GB-påstanden trenger også mer forklaring. Modellen omtales i BF16-format, og 7 milliarder parametere i BF16 krever grovt regnet mer enn 8 GB bare til vektene. MoE reduserer beregningene per token, men alle ekspertene må normalt fortsatt lagres et sted. Den tekniske rapporten må derfor vise om OVHcloud strømmer eksperter fra systemminnet, bruker en form for komprimering eller har gjort andre arkitekturvalg som forklarer tallet.
Hva betyr 32 000 tokens kontekst?
Den første utgaven av Olala mini får en kontekst på 32 000 tokens. Det er nok til mange samtaler, dokumenter og avgrensede agentoppgaver, men langt fra de største kontekstvinduene på markedet. OVHcloud planlegger en versjon 1.1 med 128 000 tokens og bedre matematisk resonnering før utgangen av 2026.
Kontekstlengde er heller ikke det samme som god forståelse av hele konteksten. En modell kan teknisk ta imot 32 000 tokens og fortsatt miste viktige detaljer, blande opplysninger eller bli merkbart dårligere nær grensen. Dette må måles når modellen og rapporten faktisk er tilgjengelige.
For lokal bruk er 32 000 tokens likevel et fornuftig utgangspunkt. Lange kontekster bruker minne til KV-cache, og det passer dårlig med løftet om å fungere på små maskiner. Jeg vil heller se en modell som bruker 32 000 tokens godt innenfor et realistisk minnebudsjett enn en modell som skryter av en enorm grense få kan bruke lokalt.
Er Olala mini åpen?
OVHcloud sier at Olala mini skal publiseres på Hugging Face under Apache 2.0-lisensen. Planen omfatter modellvekter, den forhåndstrente basemodellen, en teknisk rapport og dokumentasjon knyttet til AI Act. Apache 2.0 er en romslig lisens som normalt tillater både endring og kommersiell bruk.
Ordvalget «skal publiseres» er viktig. Da kunngjøringen kom 17. november, var modellen ikke synlig blant OVHclouds modeller på Hugging Face. Den offisielle lanseringen er satt til OVHcloud AI Summit 19. november. Før filene ligger der, er dette en varslet åpen utgivelse – ikke en modell leseren kan laste ned og kontrollere.
Når vektene kommer, blir rapporten nesten like viktig som selve nedlastingen. Den bør forklare rutingen mellom de 256 ekspertene, minneoppsettet bak 8 GB-påstanden, testmaskinen bak CPU-tallet og hvilke datasett som er brukt til å måle kvalitet. Uten dette kan andre gjenta markedsføringen, men ikke målingene.
Åpne vekter og Apache 2.0 er likevel et godt utgangspunkt. Lokale modeller blir mer nyttige når utviklere kan kjøre dem uten nett, tilpasse dem og bygge dem inn i egne løsninger uten å være låst til én API-leverandør. Det er samme praktiske verdi som gjør Muse Glimmer interessant som lokal agentmodell på 24 GB, bare med en langt lavere lovet terskel her.
Hva vet vi om kvaliteten?
Foreløpig vet vi svært lite om kvaliteten. OVHcloud har ikke publisert sammenlignbare resultater for resonnering, koding, instruksjonsfølging, verktøybruk eller lange kontekster. Det gjør det umulig å plassere Olala mini mot andre små, lokale modeller på en ryddig måte.
Selskapet opplyser at Qwant allerede bruker modellen til korte svar i søkemotoren. Ifølge OVHcloud ble svarene 20 prosent raskere, mens driftskostnaden ble redusert til en tredel av kostnaden med modellen Qwant brukte tidligere. Det er et faktisk produksjonssignal, men sammenligningsmodellen, kvalitetsterskelen og målemetoden er ikke oppgitt.
Raskere og billigere svar betyr ikke nødvendigvis bedre svar. For en søkefunksjon kan en liten modell være glimrende hvis den får gode kilder og bare skal formulere et kort sammendrag. Det sier mindre om hvordan modellen takler kode, vanskelige resonnementer eller autonome agentløp.
Dette er grunnen til at gjennomstrømning aldri bør stå alene. 160 tokens i sekundet er verdiløst hvis modellen produserer feil i høy hastighet. På den andre siden trenger ikke Olala mini slå langt større modeller i alle tester for å være nyttig. Hvis den er god nok på avgrensede oppgaver, kan lavt minnebehov og høy fart være et sterkere salgsargument enn en pen plassering på en generell resultatliste.
Hvordan ble Olala mini trent?
Olala mini er ifølge OVHcloud trent fra bunnen av på de europeiske superdatamaskinene Jupiter, MeluXina og Jean Zay. Treningen brukte Nvidia GH200-, A100- og H100-GPU-er. Selskapet verdsetter den offentlige regnekraften til 7 millioner euro, omtrent 74 millioner kroner med Norges Banks siste tilgjengelige eurokurs.
Det er mye datakraft for en modell som bare aktiverer 1 milliard parametere om gangen. Samtidig er dette OVHclouds første modellfamilie, så arbeidet handler også om å bygge et lag, en treningsplattform og kunnskap som kan brukes videre. Selskapet har opprettet et eget Agentic Lab under navnet OVHai LLM.
Veikartet er større enn mini-modellen. Versjon 2.0 skal passere 100 milliarder parametere og få varianter rettet mot bedriftsagenter, cloud DevOps og cybersikkerhet. OVHcloud vil også bruke fremtidige modeller i en kryptert utgave av OVHai Workspace som kan kjøre direkte på arbeidsstasjonen.
Det er ambisiøst, men veikart er ikke produkter. Olala mini må først vise at OVHcloud kan levere gode vekter, forståelig dokumentasjon og reproduserbare målinger. Deretter kan selskapet snakke troverdig om modeller på over 100 milliarder parametere.
Hvem er modellen mest interessant for?
Olala mini er først og fremst interessant for dem som vil kjøre mange enkle og middels krevende tekstoppgaver lokalt. Det kan være klassifisering, oppsummering, søk med egne kilder, dokumentbehandling eller små agenter som kaller verktøy under tydelige rammer.
Små modeller blir stadig mer relevante når de kan gjøre én avgrenset jobb raskt og billig. MiniCPM5-1B viste den samme retningen med reasoning og tool use på 1 milliard parametere. Forskjellen er at Olala mini pakker den aktive milliarden inn i en større ekspertarkitektur som i teorien kan gi mer spesialisert kapasitet.
Bedrifter med følsomme data kan også ha nytte av at modellen kjører uten å sende tekst til en ekstern API-tjeneste. Men lokal kjøring løser ikke sikkerhet av seg selv. Modellen må fortsatt testes for prompt injection, uønsket datalekkasje, feil verktøykall og dårlige svar før den får tilgang til interne systemer.
Den riktige reaksjonen nå er derfor nysgjerrighet med en hånd på bremsen. Følg med på lanseringen 19. november, les rapporten og vent på målinger fra folk som faktisk har kjørt vektene. Hvis 8 GB- og CPU-tallene kan gjenskapes uten at kvaliteten blir borte, har OVHcloud laget noe som kan bli ordentlig nyttig. Hvis ikke, har selskapet foreløpig bare laget en svært rask pressemelding.
Ofte stilte spørsmål
Kan Olala mini kjøre uten skjermkort?
OVHcloud hevder at Olala mini når 50 tokens i sekundet på en vanlig prosessor uten GPU. CPU-modellen og testoppsettet er ikke oppgitt, så tallet bør behandles som en leverandørpåstand til vektene og den tekniske rapporten kan kontrolleres.
Kan jeg laste ned Olala mini nå?
Ikke da kunngjøringen kom 17. november 2026. OVHcloud sier at vektene, basemodellen og rapporten skal publiseres på Hugging Face under Apache 2.0. Den offisielle lanseringen er varslet til 19. november.
Er Olala mini god til koding og AI-agenter?
Det er ikke dokumentert ennå. OVHcloud omtaler Olala som en agentisk modellfamilie, men har ikke publisert sammenlignbare kvalitetsmålinger for koding, verktøybruk eller agentoppgaver. Den kommende rapporten og praktiske tester må gi svaret.
Hva betyr 7A1B i modellnavnet?
7A1B betyr at modellen har omtrent 7 milliarder parametere totalt og aktiverer omtrent 1 milliard for hver forespørsel. Ekspertruting reduserer beregningene per token, men navnet sier ikke alene hvor god modellen er.