Innhold Vis
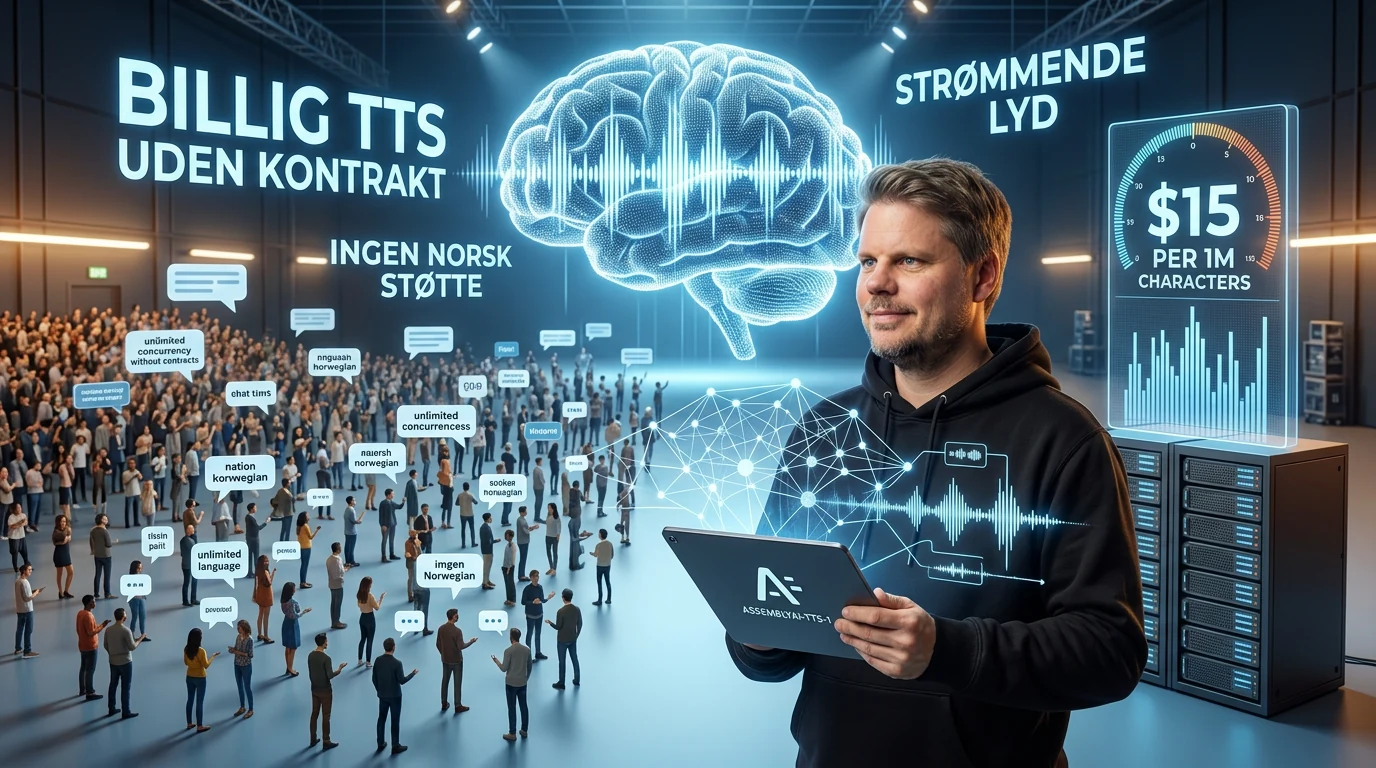
Hvis du bygger taleagenter på engelsk eller fem andre store europeiske språk, gjør AssemblyAI-TTS-1 to vanskelige ting uvanlig enkle: Prisen er 15 dollar per million tegn, cirka 140 kroner, og samtidige samtaler krever ingen egen kapasitetsavtale. Det er en kombinasjon som er langt mer interessant enn enda en pen stemmedemo.
AssemblyAI har fram til nå vært mest kjent for tale til tekst. Med AssemblyAI-TTS-1 leverer selskapet også den andre enden av samtalen som en separat TTS-tjeneste: Tekst går inn, strømmet lyd kommer ut. Modellen er generelt tilgjengelig fra 27. oktober 2026 og er laget for korte, løpende svar i taleagenter.
Det er likevel en viktig norsk hake. Modellen støtter engelsk, spansk, fransk, tysk, italiensk og portugisisk ved lansering. Norsk står ikke på listen. Dette er derfor en relevant nyhet for utviklere og bedrifter som betjener disse språkene, men ikke dokumentasjon på norsk uttale eller norske samtaler.
Hva er AssemblyAI-TTS-1?
AssemblyAI-TTS-1 er AssemblyAIs første frittstående modell for tekst til tale. Den er bygget for taleagenter og kan levere lyd gjennom både WebSocket og HTTP. Selskapet oppgir rundt 90 millisekunder til første lydstrøm, over 4 000 ferdige stemmer og samme stykkpris for vanlige og klonede stemmer i den offisielle lanseringen.
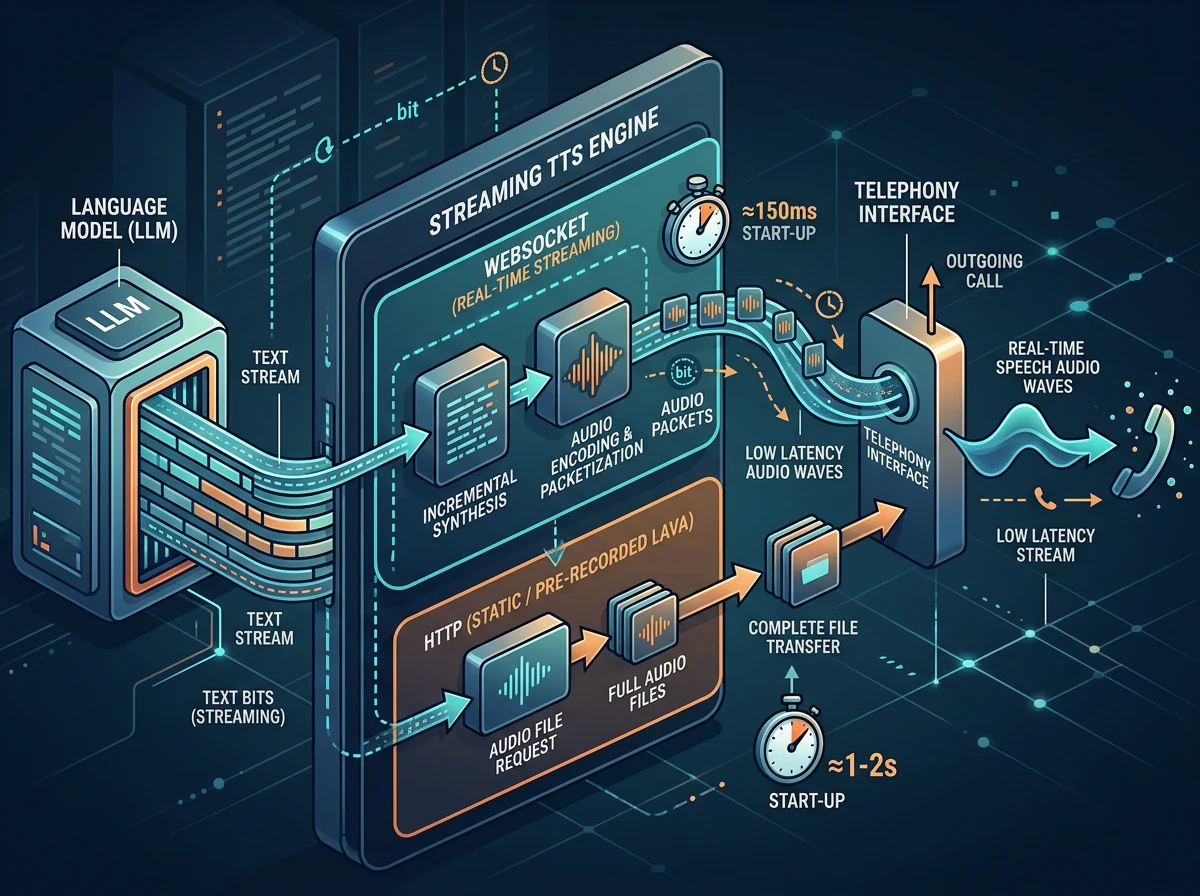
Poenget med streaming er at agenten ikke må vente på en ferdig lydfil før den begynner å snakke. En språkmodell kan produsere svaret bit for bit, TTS-tjenesten kan begynne å lage lyd fra den første delen, og brukeren kan høre starten mens resten fortsatt behandles. Det er akkurat sånn en taleagent unngår de lange, kunstige pausene som får en samtale til å føles som en gammel telefonmeny.
HTTP-grensesnittet passer bedre når hele teksten allerede er klar, for eksempel til varsler, forhåndsvisninger eller lyd som kan lagres i hurtigbuffer. WebSocket er laget for den løpende samtalen. AssemblyAI tilbyr også et OpenAI-kompatibelt endepunkt, noe som kan redusere jobben når en eksisterende integrasjon allerede bruker samme API-form.
Hvorfor er prisen mer interessant enn den ser ut?
Listeprisen er 15 dollar per én million tegn. Med Norges Banks dollarkurs på 9,2944 kroner 28. oktober blir det omtrent 139 kroner, avrundet til cirka 140 kroner. Det tilsvarer rundt 1,40 kroner per 10 000 tegn. Mellomrom og tegnsetting teller med i faktureringen.
Prisen inkluderer alle språkene, hele stemmebiblioteket, stemmekloning, tidsstempler på ordnivå og databehandling i USA eller EU. Det er ingen egen avgift per stemme, ingen minstebestilling og ingen separat samtidighetspris på pay-as-you-go. Volumpris finnes for kunder som vil forplikte seg, men forpliktelsen er ikke inngangsbilletten til å komme i gang.
Prising per tegn gjør kostnaden relativt enkel å beregne før en tjeneste settes i produksjon. Har agenten i gjennomsnitt 2 000 tegn utgående tale per samtale, koster selve TTS-delen omtrent 2,8 øre per samtale. Det er et regneeksempel, ikke et løfte om totalprisen. Tale til tekst, språkmodell, telefoni, lagring og resten av infrastrukturen kommer i tillegg.
Den virkelige regningen avhenger også av hvor mye tekst agenten rekker å sende før brukeren avbryter. En god integrasjon må stoppe både lydavspillingen og videre generering ved en avbrytelse. Ellers betaler du for en agent som fortsetter å holde foredrag til en bruker som allerede prøver å komme til orde. Det er dårlig samtaledesign med faktura på toppen.
Hva betyr samtidighet uten kontrakt?
AssemblyAI sier at pay-as-you-go-kunder ikke trenger å kjøpe en bestemt samtidighetsklasse eller signere en årlig avtale. Ti og 10 000 samtidige samtaler bruker samme API og samme pris per tegn. For en tjeneste med uforutsigbare trafikktopper fjerner det en kommersiell sperre som ofte dukker opp lenge før den tekniske grensen.
Det betyr ikke at resten av systemet automatisk tåler 10 000 samtaler. WebSocket-forbindelser, telefoni, språkmodell, køer, logging og applikasjonen din må fortsatt skaleres og overvåkes. «Ubegrenset samtidighet» beskriver leverandørens prismodell og tilgang, ikke en garanti for at hele arkitekturen din er uendelig.
Dette er likevel nyttig for små og mellomstore bedrifter. De kan bygge og pilotere uten å forhandle fram kapasitet på forhånd, og de slipper å velge mellom en for liten standardkvote og en stor kontrakt før trafikken er kjent. Betal for tegnene som faktisk sendes, og mål resten av kjeden under realistisk last.
Hvor raskt begynner modellen å snakke?
AssemblyAI markedsfører modellen med rundt 90 millisekunder til første lyd. I selskapets egen sammenligning startet AssemblyAI-TTS-1 å strømme data etter 47 millisekunder ved medianen og 54 millisekunder ved 90-persentilen. Det er raske tall, men målingen er gjort av AssemblyAI fra én klient og gjelder tid til første byte fra TTS-API-et.
Brukeren opplever noe annet: tiden fra vedkommende slutter å snakke til første hørbare lyd fra agenten. Før TTS i det hele tatt får teksten, skal systemet oppdage at taleturen er ferdig, transkribere lyd og få språkmodellen til å begynne på et svar. Nettverk, buffering og avspilling kommer i tillegg. For en nærmere forklaring av hele kjeden har jeg tidligere skrevet om hva som faktisk skaper lav forsinkelse i Voice AI.
Derfor bør ingen selge dette inn som en taleagent med 47 millisekunders svartid. Det korrekte er at TTS-leddet ser raskt ut i leverandørens måling. Den nyttige produksjonsmålingen er siste lyd inn til første hørbare lyd ut, fordelt på median, 90-persentil og de verste tilfellene. Mål også hvor ofte agenten avbryter feil eller fortsetter etter at brukeren har begynt å snakke.
Hva følger med i API-et?
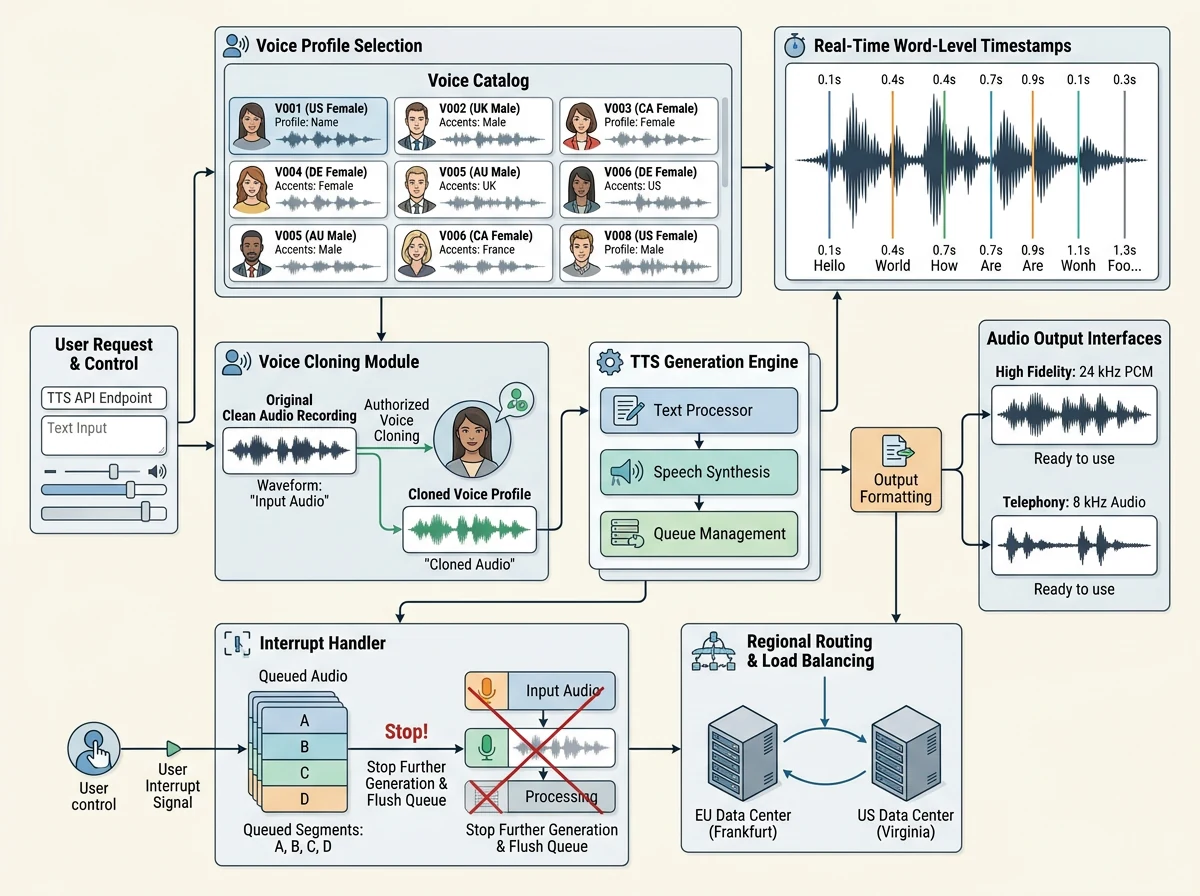
Stemmekatalogen inneholder over 4 000 stemmer med navn, beskrivelser og tagger. En tillatt stemme kan også klones fra et kort, rent lydopptak og brukes med en egen stemme-ID. AssemblyAI oppgir at klonede stemmer koster det samme som katalogstemmene, men brukeren må selvfølgelig ha tillatelse fra personen som eier stemmen.
Tidsstempler på ordnivå følger med. De gjør det mulig for en agent å vite hvor langt avspillingen faktisk var kommet da brukeren avbrøt. Det er viktig når samtaletilstanden skal oppdateres: Agenten bør ikke anta at brukeren hørte siste halvdel av en setning som aldri kom ut av høyttaleren.
AssemblyAIs integrasjonseksempel viser HTTP-endepunktet POST https://tts.us.assemblyai.com/v1/speech og WebSocket-endepunktet wss://tts.us.assemblyai.com/v1/ws. WebSocket kan levere rå 16-bits PCM ved 24 kHz, mens mu-law og A-law ved 8 kHz er tilgjengelig for telefoni. HTTP kan returnere en ferdig WAV-fil.
Det finnes også separate verter for behandling i USA og EU til samme pris. Dette løser ikke automatisk alle krav til personvern og databehandling, men det gir en konkret regional innstilling å ta med i arkitekturen. Bedrifter bør fortsatt kontrollere databehandleravtale, lagring, logger, sletting og hva som skjer med lyd brukt til stemmekloning.
Hvor god er AssemblyAI-TTS-1?
AssemblyAI rapporterer 99,0 prosent ordnøyaktighet og 93,7 prosent nøyaktighet på 580 vanskelige mål med blant annet tall, koder og forkortelser. Selskapet oppgir også 3,85 av 5 i gjennomsnitt på automatiske modeller som forsøker å forutsi menneskelige kvalitetsvurderinger. Målingene er grundig beskrevet, men de er fortsatt utført og publisert av leverandøren.
Testsettet for ordnøyaktighet omfatter blant annet Seed-TTS English og LibriSpeech. Uttaletesten er transkribert og vurdert maskinelt, mens naturlighet blant annet er målt med automatiske preferansemodeller. Slike tall kan vise at modellen er teknisk konkurransedyktig, men de forteller ikke alene hvordan kunder opplever en lang samtale, en bestemt bransje eller en bestemt aksent.
Et uavhengig resultat er mer blandet. MarkTechPost viser til Cekuras benchmark, der AssemblyAI-TTS-1 fikk 159 millisekunder median strømmeforsinkelse og 81,5 prosent lesenøyaktighet. Inworld TTS-2 Flash målte 45 millisekunder og 93,2 prosent til samme listepris. Metoden er en annen enn AssemblyAIs måling av tid til første byte, så tallene kan ikke legges rett oppå hverandre. De er likevel en god påminnelse om hvorfor modellen må vurderes i faktisk trafikk.
AssemblyAI sier selv at den avgjørende testen er faktisk produksjonstrafikk. Det er en fornuftig erkjennelse. Sammenlign fullførte oppgaver, avbrudd, gjentakelser, misforståtte navn og hvor ofte et menneske må overta. En stemme som vinner en isolert lydsammenligning kan fortsatt være feil valg hvis agenten leser kundenummer dårlig eller blir slitsom etter ti minutter.
Støtter AssemblyAI-TTS-1 norsk?
Nei, ikke ved lansering. De seks oppgitte språkene er engelsk, spansk, fransk, tysk, italiensk og portugisisk. Hver stemme skal kunne brukes på alle seks når språket settes i forespørselen. AssemblyAI sier at flere språk og aksenter kommer senere, men har ikke dokumentert norsk støtte eller oppgitt en norsk lanseringsdato.
Dette må ikke blandes sammen med AssemblyAIs tale-til-tekst-modeller, der norsk kan være støttet. At en tjeneste kan forstå norsk lyd betyr ikke at den nye TTS-modellen kan snakke norsk. Det er to forskjellige modeller og to forskjellige egenskaper.
Det finnes heller ingen norsk kvalitetsmåling i lanseringsmaterialet som kan brukes til å vurdere uttale, dialekter eller prosodi. Dermed er den ærlige vurderingen enkel: AssemblyAI-TTS-1 er foreløpig ikke et dokumentert norsk TTS-alternativ. Ingen grunn til å late som en engelsk benchmark besvarer det spørsmålet.
Hvem bør vurdere modellen nå?
Modellen er mest aktuell for utviklere som allerede har en egen taleagent-pipeline og vil bytte eller sammenligne TTS-leddet. WebSocket, avbruddsmelding, ordtidsstempler og telefoni-tilpassede lydformater gjør den relevant for kundeservice, timebestilling, salg, reservasjoner og andre samtaler med korte turer fram og tilbake.
Bedrifter som trenger norsk tale bør vente på faktisk språkstøtte og relevant dokumentasjon. Det samme gjelder løsninger som krever SSML, egen uttaleordbok eller direkte kontroll over talehastighet og følelser. AssemblyAI opplyser at slike kontroller ikke er tilgjengelige ennå, selv om uttaleordbøker og følelsestagger er varslet senere.
For de støttede språkene ville jeg startet med et avgrenset trafikkutvalg og sammenlignet mot dagens løsning. Mål hele samtalen, ikke bare lyden: fullføringsgrad, første hørbare svar, avbrudd, riktige navn og tall, kostnad per løst henvendelse og menneskelig overtakelse. Hold også styr på antall sendte tegn, for det er der TTS-regningen faktisk kommer fra.
Min foreløpige vurdering er nøkternt positiv. 15 dollar per million tegn og samtidighet uten kontraktsport gjør AssemblyAI-TTS-1 lett å prøve og lett å regne på. Det er bra. Men leverandørens egne tester er starten på vurderingen, ikke slutten, og norske taleagenter må fortsatt se andre steder.
Ofte stilte spørsmål
Hvor mye er 15 dollar per million tegn i norske kroner?
Det er cirka 140 kroner med Norges Banks kurs på 9,2944 kroner per dollar 28. oktober 2026. Prisen tilsvarer omtrent 1,40 kroner per 10 000 tegn. Mellomrom og tegnsetting teller, mens tale til tekst, språkmodell, telefoni og annen infrastruktur kommer i tillegg.
Må jeg ha bedriftsavtale for mange samtidige samtaler?
Nei. AssemblyAI oppgir ubegrenset samtidighet på pay-as-you-go uten årlig kontrakt eller kjøp av en egen kapasitetsklasse. Det gjelder TTS-tjenesten, mens resten av applikasjonen og leverandørene i samtalekjeden fortsatt må dimensjoneres for den faktiske trafikken.
Kan AssemblyAI-TTS-1 brukes med en eksisterende taleagent?
Ja. Tjenesten har HTTP, WebSocket og et OpenAI-kompatibelt taleendepunkt. Den støtter avbrytelse, ordtidsstempler og lydformater for telefoni. Integrasjonen må likevel håndtere køet lyd og stoppe videre tekstgenerering når brukeren avbryter.
Kan modellen snakke norsk?
Ikke ifølge lanseringsdokumentasjonen. AssemblyAI-TTS-1 støtter engelsk, spansk, fransk, tysk, italiensk og portugisisk ved lansering. Norsk støtte, norsk uttale og norske dialekter er ikke dokumentert for denne modellen, selv om andre AssemblyAI-modeller kan støtte norsk tale til tekst.