Jan Sverre Bauge

Fra arkivet

Flere nyheter og erfaringer

Nyheter og erfaringer

Mine prosjekter ↗
Jan Sverre i tolkeboks med sanntidsoversettelse på skjerm - Qwen3.5-LiveTranslate-Flash

Qwen3.5-LiveTranslate-Flash – sanntidsoversettelse på 2,8 sekunder

Alibaba har sluppet Qwen3.5-LiveTranslate-Flash, en sanntidsoversettelsesmodell som håndterer 60 inngangsspråk og leverer taleoutput på 2,8 sekunder. Den prosesserer lyd og video parallelt - det vil si at den leser leppebevegelser, tekst på skjermen og visuelle objekter mens den oversetter det som sies.
Jan Sverre undersøker holografisk visualisering av Nemotron-Labs-Diffusion sine tre dekodingsmodus i NVIDIA serverrom

Nemotron-Labs-Diffusion – NVIDIAs språkmodell med 6× gjennomstrøm

NVIDIA har sluppet Nemotron-Labs-Diffusion, en ny språkmodellfamilie som kombinerer tre fundamentalt forskjellige dekodingsmodus i én og samme modell-checkpoint. Resultatet er 6 ganger høyere gjennomstrøm enn sammenlignbare modeller fra Qwen - uten at du trenger å bytte mellom separate modeller avhengig av brukstilfelle.

Jan Sverre Bauge analyserer Gemini 3.5 Flash i et moderne serverrom med holografisk display

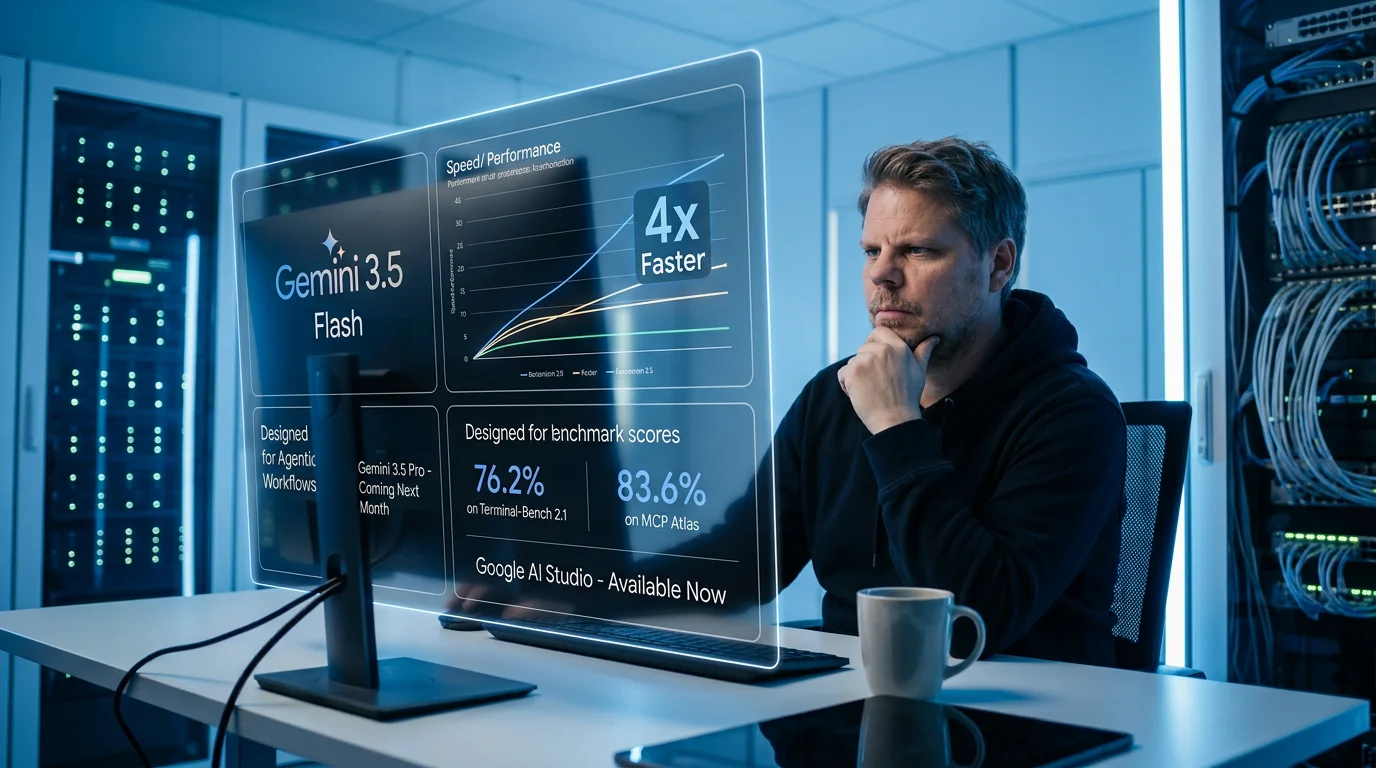
Gemini 3.5 Flash – Googles raskeste frontiermodell er her

Gemini 3.5 Flash er lansert, og Google lover 4x høyere hastighet enn andre frontiermodeller - til under halvparten av prisen. Modellen er designet fra bunnen av for agentic workflows: oppgaver som krever at AI-en tar beslutninger, bruker verktøy og jobber over lengre tid uten at du trenger å sitte og passe på.

Jan Sverre ved skrivebordet med llama.cpp-terminaler som viser MTP-aktivert inferens

MTP merget inn i llama.cpp – nå kan alle kjøre det

PR 22673 er merget inn i llama.cpp master, og det betyr at multi-token prediction (MTP) nå er tilgjengelig for alle som kjører modeller lokalt. Ingen eksperimentelle byggversjoner, ingen patcher. Bare git pull og en ny flagg i kommandolinjen.