Jan Sverre ser skeptisk på NVIDIA sin kvantisering av Alibabas Qwen3-27B modell for serverklasse GPU-er

Qwen3.6-27B i NVFP4 – NVIDIA kvantiserer Alibabas modell for Hopper og Blackwell

NVIDIA har kvantisert Qwen3.6-27B til NVFP4-format for Hopper og Blackwell GPU-er. Her er hva det betyr i praksis – og hvem det faktisk er relevant for.
Mann i hettegenser i et fremtidsrettet datasenter med oransje oscillerende lys fra server-rader

Kan Un-0 kutte AI-strømregningen med 1 000 ganger? Databricks-veteran mener ja

Naveen Rao, tidligere AI-sjef hos Databricks, hevder at hans nye selskap Unconventional AI kan kutte strømforbruket ved AI-inferens med 1 000 ganger – og lanserte i går bildegeneratoren Un-0 som bevis på konseptet.
Jan Sverre holder og undersøker en glødende AI-inferens-chip fra OpenAI og Broadcom

OpenAI og Broadcom lanserte Jalapeño – en chip bygd utelukkende for AI-inferens

OpenAI og Broadcom avslørte Jalapeño – en egenutviklet inferens-chip på TSMCs 3nm-prosess som skal gjøre AI-drift billigere og uavhengig av Nvidia.
Jan Sverre utforsker DFlash spekulativ dekoding - parallell token-generering visualisert som lysstrømmer i et serverrom

DFlash: slik kan spekulativ dekoding gi deg opptil 6x raskere AI-inferens

DFlash fra UC San Diego bruker block diffusion og KV injection for å generere hele token-blokker parallelt – og rapporterer opptil 6x lossless speedup på Qwen3-8B. Her er hva det betyr i praksis.
Jan Sverre i et moderne datasenter - Groq henter 650 millioner dollar i ny kapital

Groq tapte grunnleggeren til Nvidia – og hentet 7 milliarder kroner likevel

Groq bekreftet i går en finansieringsrunde på 650 millioner dollar etter at Nvidia hentet ut grunnleggeren og lisensierte teknologien. Nå satser selskapet tungt på neocloud-infrastruktur med 13 datasentre og et helt nytt lederteam.
Mann med hettegenser lytter konsentrert til AI-generert norsk tale på hjemmekontor med terminal-skjerm

Chatterbox: lokal, gratis norsk stemmekloning – men bare hvis du gjør det riktig

Chatterbox lover lokal, gratis norsk stemmekloning uten sky. Jeg testet det på RTX 4090 – her er hva som faktisk funker, og hva som gjør det syntetisk.
Jan Sverre ser på en futuristisk fullkropps ultralydsscanner i et medisinsk spa-miljø

Midjourney Medical: AI-bildeselskapet vil skanne kroppen din i et spa

Midjourney, firmaet du kjenner fra AI-bildegenerering, har kunngjort sitt andre produkt: en fullkropps ultralydsscanner som skal stå i et spa ved Union Square i San Francisco. Slik fungerer den.
Jan Sverre Bauge ser på hybrid AI-ruting mellom lokal PC og sky

Perplexity løser personvernproblemet med lokal AI – slik fungerer den nye smartruting-funksjonen

Perplexity AI lanserer hybrid lokal-sky-ruting som automatisk velger om AI-oppgaver kjøres på din PC eller i skyen. Slik fungerer det i praksis.
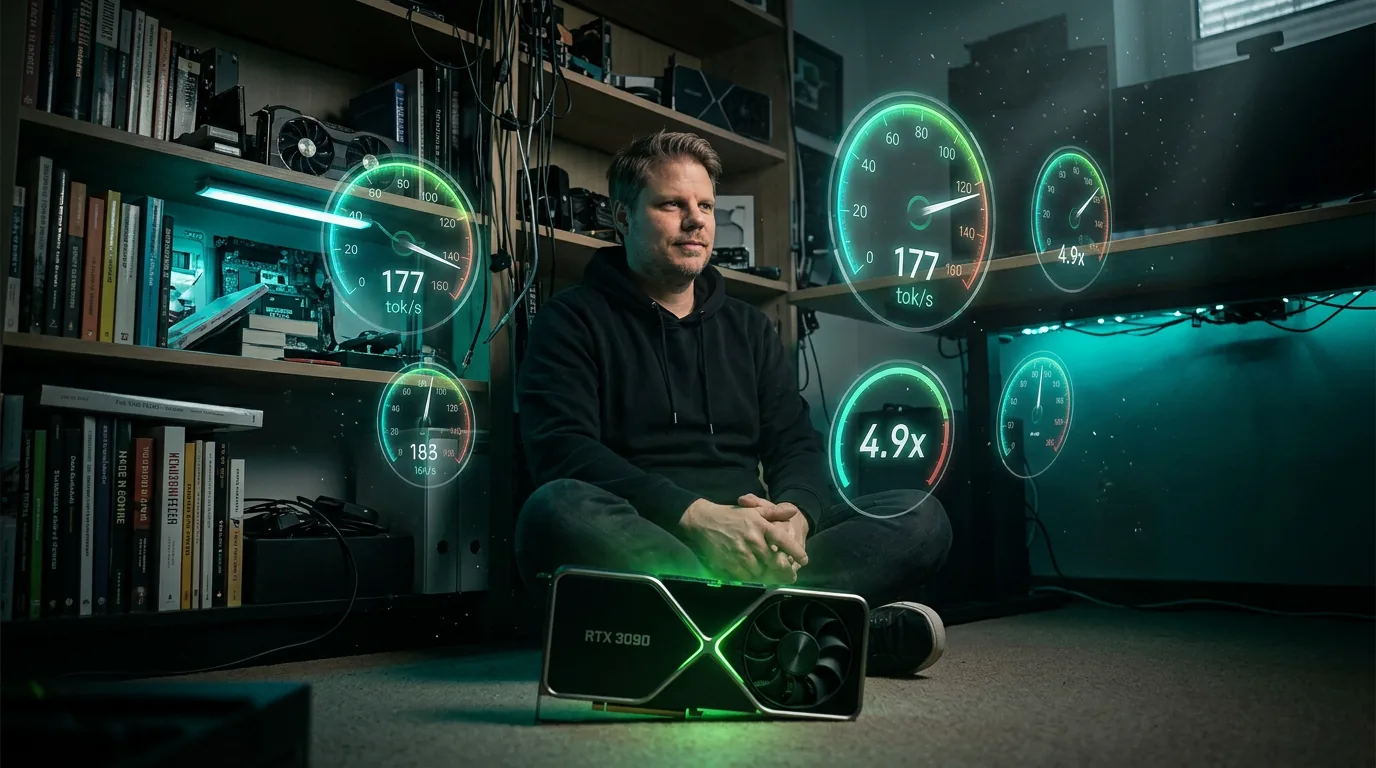
Jan Sverre ser på ytelsestall fra BeeLlama DFlash på RTX 3090 - 177 tokens per sekund

Slik får du nesten 5x raskere lokal AI på én RTX 3090 – BeeLlama v0.2.0 forklart

BeeLlama v0.2.0 gir opptil 4,9x raskere tekstgenerering med Gemma 4 31B og Qwen3.6 27B på én enkelt RTX 3090 – uten ekstra maskinvare.
Jan Sverre holder en RISC-V mikrokontroller og ser på en skjerm med et pikselert katteransikt

DCGAN på en mikrokontroller – 12,6 millioner parametere, 512 KB RAM og katteransikt på 26 sekunder

En utvikler kjørte en DCGAN-modell med 12,6 millioner parametere på en RISC-V mikrokontroller med bare 512 KB SRAM. Her er hvordan det faktisk fungerer.
Jan Sverre undersøker Orange Pi AIPro single-board computer med Ascend 310B NPU på arbeidsbenk

MiniCPM-V 4.6 på Orange Pi – C++ inferensmotor til 1 500 kr

En utvikler bygde en C++ inferensmotor fra bunnen for å kjøre MiniCPM-V 4.6 på Orange Pi AIPro med Ascend 310B NPU. Resultatet: 5,90 tokens per sekund, ingen PyTorch, åpen kildekode – for 1 500 kroner.
Jan Sverre undersøker AMD RDNA3 GPU-hardware med hipEngine benchmark-resultater på skjermen

hipEngine – ROCm-native inference engine for AMD RDNA3 og Strix Halo

hipEngine er et nytt open source inference engine for AMD RDNA3-GPUer – kjører Qwen3.6 35B på 103 tok/s på RX 7900 XTX uten PyTorch-overhead. 120+ egenskrevne HIP-kjerner, 50% raskere prefill enn llama.cpp ved 128K kontekst.
Jan Sverre studerer ytelsesdata fra DeepSeek V4 Flash kjørt på fire RTX 2080 Ti-er

DeepSeek V4 Flash lokalt på fire RTX 2080 Ti – 255 tokens per sekund for under 25 000 kr

Noen kjørte DeepSeek V4 Flash lokalt på fire brukte RTX 2080 Ti-er til under 25 000 kr – og fikk 255 prefill tokens per sekund. Her er hva de brukte og hvordan det fungerer.
Jan Sverre i et robotikk-lab med robotarmer og skjermer som viser videomodell-trening med LoRA for NVIDIA Cosmos Predict 2.5

NVIDIA Cosmos Predict 2.5 – fine-tuning med LoRA for robotvideo

NVIDIA Cosmos Predict 2.5 kan fine-tunes med LoRA på 92 videoer. Fra 2,1 til 3,8 i instruction following-score – og du trenger bare én H100.