Jan Sverre i et robotikk-lab med robotarmer og skjermer som viser videomodell-trening med LoRA for NVIDIA Cosmos Predict 2.5

NVIDIA Cosmos Predict 2.5 – fine-tuning med LoRA for robotvideo

NVIDIA Cosmos Predict 2.5 kan fine-tunes med LoRA på 92 videoer. Fra 2,1 til 3,8 i instruction following-score – og du trenger bare én H100.
SANA-WM NVIDIAs open source videomodell - kamerakontroll og 720p video generering

SANA-WM – NVIDIAs open source videomodell lager 60 sekunder 720p på én GPU

NVIDIA slipper SANA-WM – en 2,6 milliarder parameter open source videomodell som genererer 60 sekunder 720p-video med presis kamerakontroll på én GPU. Det er 36 ganger raskere enn konkurrentene.
Jan Sverre utforsker Lance, ByteDances 3B multimodale AI-modell for bilde og video

Lance – ByteDances 3B-modell for bilde og video i ett system

Lance er ByteDances nye 3B open source-modell som håndterer bildegenerering, videogenerering og bilderedigering i ett system. Apache 2.0-lisens, 40GB VRAM.
Jan Sverre undersøker benchmark-resultater fra M5 Max, DGX Spark, Strix Halo og RTX Pro 6000 side om side

M5 Max vs DGX Spark vs Strix Halo vs RTX Pro 6000 – hvem vinner for lokal AI?

Tre dagers parallell benchmark-kjøring av M5 Max, DGX Spark, AMD Strix Halo og RTX Pro 6000. Her er tallene – og de er ikke overraskende når du forstår minnebåndbredde.
Jan Sverre med to maskiner koblet via ethernet som kjører FLUX 2 delt over to GPUer

FLUX 2 over Ethernet – slik spreader du modellen på to GPUer uten NVLink

En utvikler har bygget en NVENC encoder bridge som lar deg splitte FLUX 2-modellen over to GPUer via Ethernet – uten NVLink. 4,4 sekunder per bilde med 5090 og laptop-4090 på to separate maskiner. Testet over WiFi og Tailscale VPN.
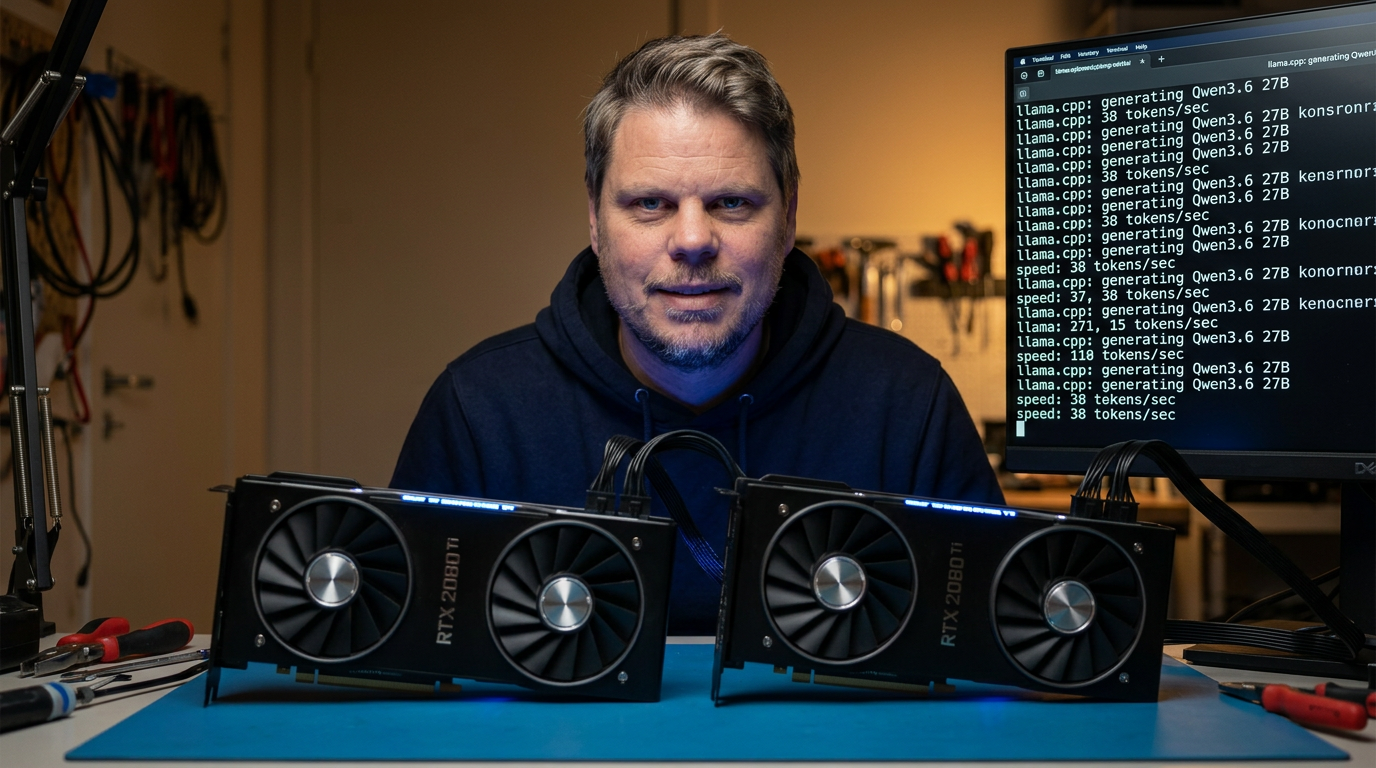
Jan Sverre inspiserer to RTX 2080 Ti grafikkort koblet i dual-GPU-oppsett for lokal AI-inferens

To gamle RTX 2080 Ti gir 38 token/s med Qwen3.6 27B – slik fungerer dual-GPU-oppsett

To RTX 2080 Ti med 22GB VRAM hver gir 38 token/s med Qwen3.6 27B via llama.cpp og Docker. Slik fungerer dual-GPU-oppsett for lokal AI – og hva koster det egentlig?
Jan Sverre kjører LoRA-trening med Anima TrainFlow på hjemme-PC med GPU

Anima TrainFlow – LoRA-trening på én side med 6GB VRAM

Anima TrainFlow er et gratis LoRA-treningsverktøy som samler alle viktige innstillinger på én side. Kjører på 6GB VRAM, portabelt, og basert på MIT-lisens.
Jan Sverre sitter i et hjemmelaboratorium omgitt av GPU-er og benchmarkgrafer på skjermen

RTX 5090 og lokal LLM – hva skjer med ytelse når du skrur ned strømmen?

Detaljert benchmark av RTX 5090 ved ulike strømnivåer: prompt parsing, token-generering og strøm-effektivitet for lokal LLM-kjøring. Hvor er sweet spot?
Jan Sverre holder en Game Boy Color med AI-tekst på pikselskjermen, varmt lampelys i mørkt rom

AI på Game Boy Color – ekte transformer-modell kjører på 8-bit hardware fra 1998

En utvikler har fått Andrej Karpathys TinyStories-260K transformer-modell til å kjøre lokalt på en umodifisert Game Boy Color – uten PC, Wi-Fi eller sky. Her er den tekniske forklaringen og hva det betyr for edge AI.
Jan Sverre ser på en AI-generert cinematic film laget av en open source pipeline med FLUX.2 og Wan2.2

Open source video pipeline – én prompt til ferdig film med FLUX.2 og Wan2.2

En open source pipeline tar én setning og leverer ferdig cinematic MP4 med karakterer, musikk og voice-over på 9 språk – alt på én AMD Instinct MI300X GPU på 45 minutter. FLUX.2 klein for keyframes, Wan2.2-I2V for animering, Vision Critic med auto-retry for kvalitetskontroll. Alle modeller Apache 2.0 eller MIT.
Jan Sverre studerer et Mixture of Experts-nettverksdiagram som viser ZAYA1-8B sin selektive parameteraktivering med AMD-hardware i bakgrunnen

ZAYA1-8B – Zyphra sin MoE-modell slår modeller 15 ganger større

ZAYA1-8B fra Zyphra aktiverer bare 760 millioner parametere per inferens, men slår modeller med 119 milliarder parametere på matematikk-benchmarks. Trent ende-til-ende på AMD Instinct MI300x og tilgjengelig under Apache 2.0-lisens.
Jan Sverre studerer distribuert AI-inferens med to maskiner koblet via nettverk på hjemmekontoret

LARQL – kjør Gemma 4 26B på to billige maskiner med decoupled attention

LARQL er et open source Rust-prosjekt som lar deg kjøre Gemma 4 26B spredt over to billige maskiner ved å koble attention-mekanismen fra modellvektene. Distribuert lokal AI-inferens uten dyr GPU-rigg – her er hva det betyr i praksis.
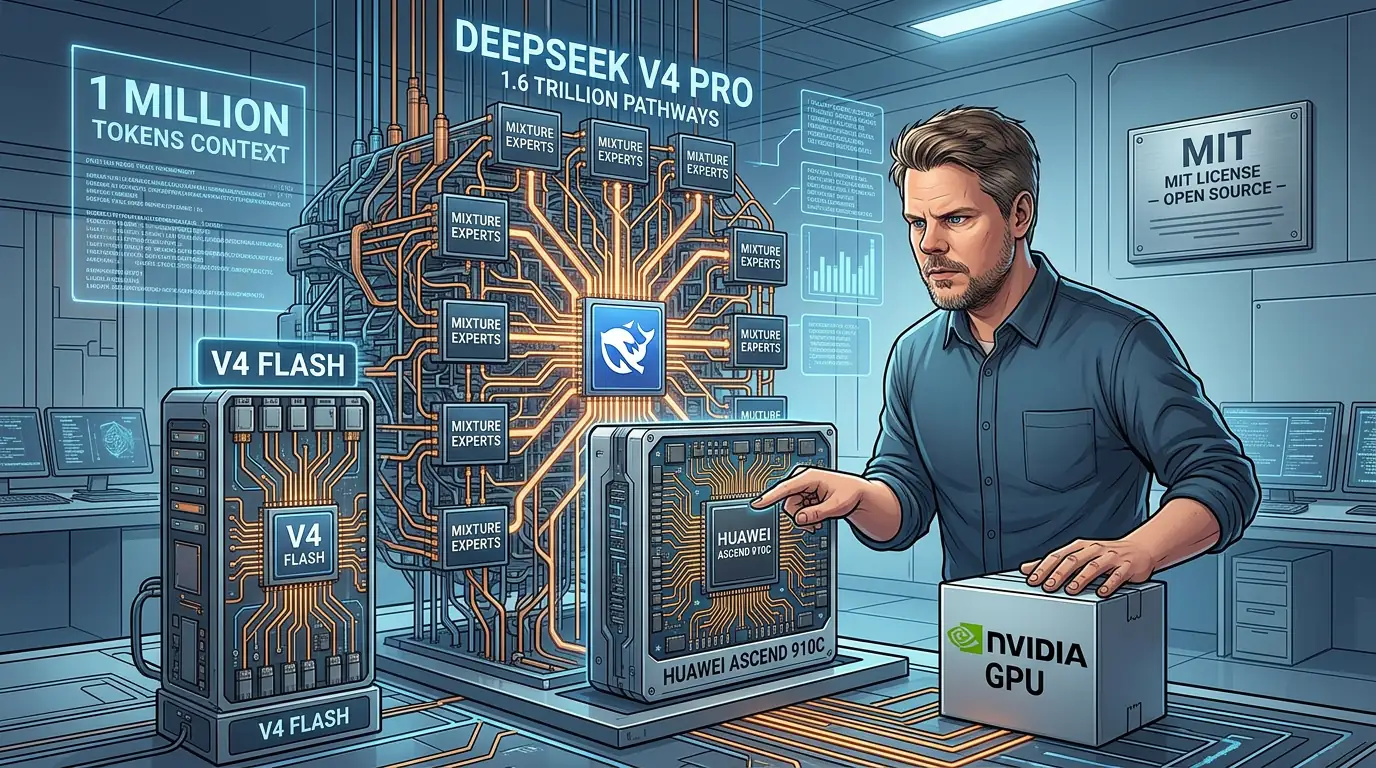
Jan Sverre analyserer DeepSeek V4 Pro og Flash - kinesiske open source AI-modeller med 1,6 billiarder parametere

DeepSeek V4 Pro og Flash – 1,6 billiarder parametere og Huawei Ascend-støtte

DeepSeek V4 Pro og Flash er lansert med 1,6 billiarder parametere, MIT-lisens og støtte for Huawei Ascend-chips. Modellen er god men ikke lenger benchmarks-leder – her er hva du trenger å vite.
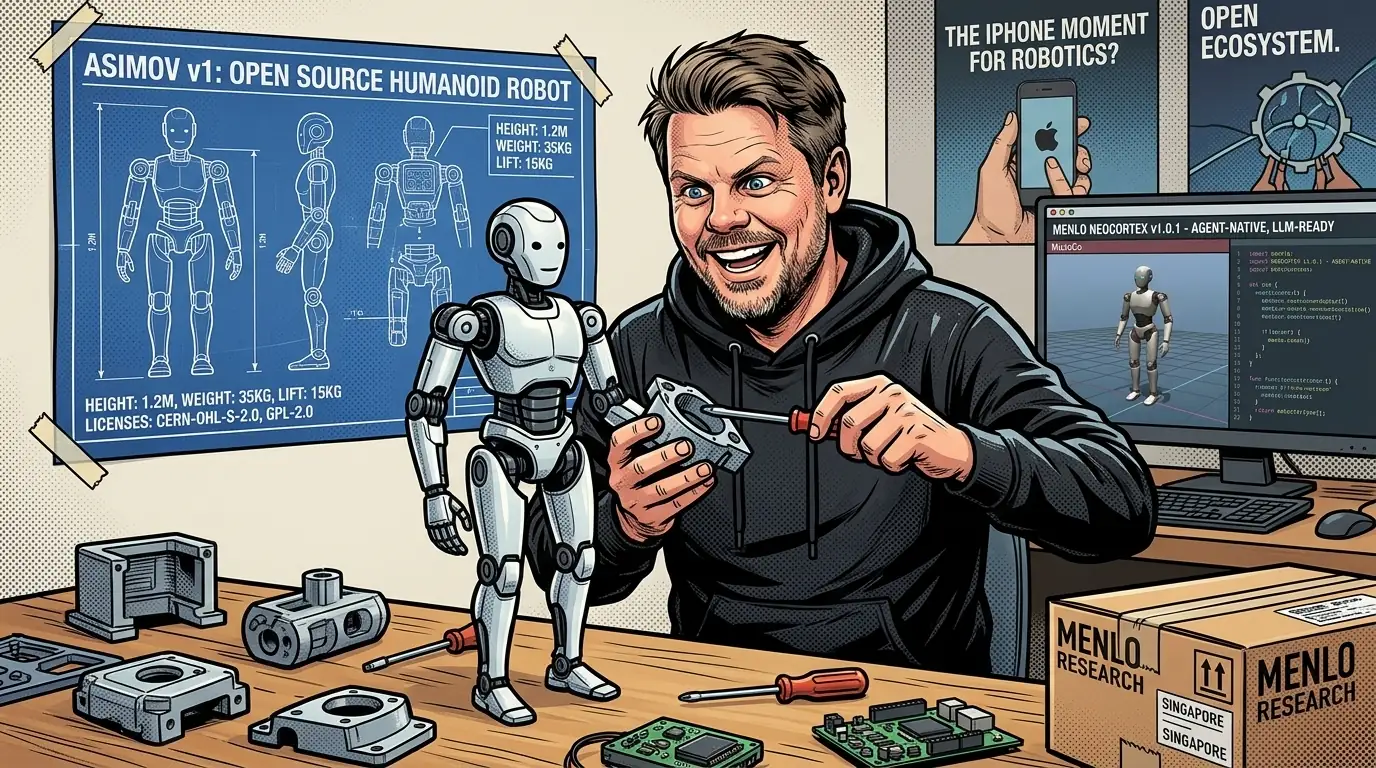
Jan Sverre studerer Asimov v1 humanoid robot fra Menlo Research - open source robot til 165 000 kroner

Asimov v1 – open source humanoid robot til 165 000 kroner

Asimov v1 er en open source humanoid robot på 1,2 meter og 35 kg fra Menlo Research – tilgjengelig som DIY-kit til 15 000 dollar (165 000 kr). CAD-filer og simuleringsmodell er allerede ute på GitHub under CERN-OHL-S og GPL-2.0-lisenser.