Innhold Vis
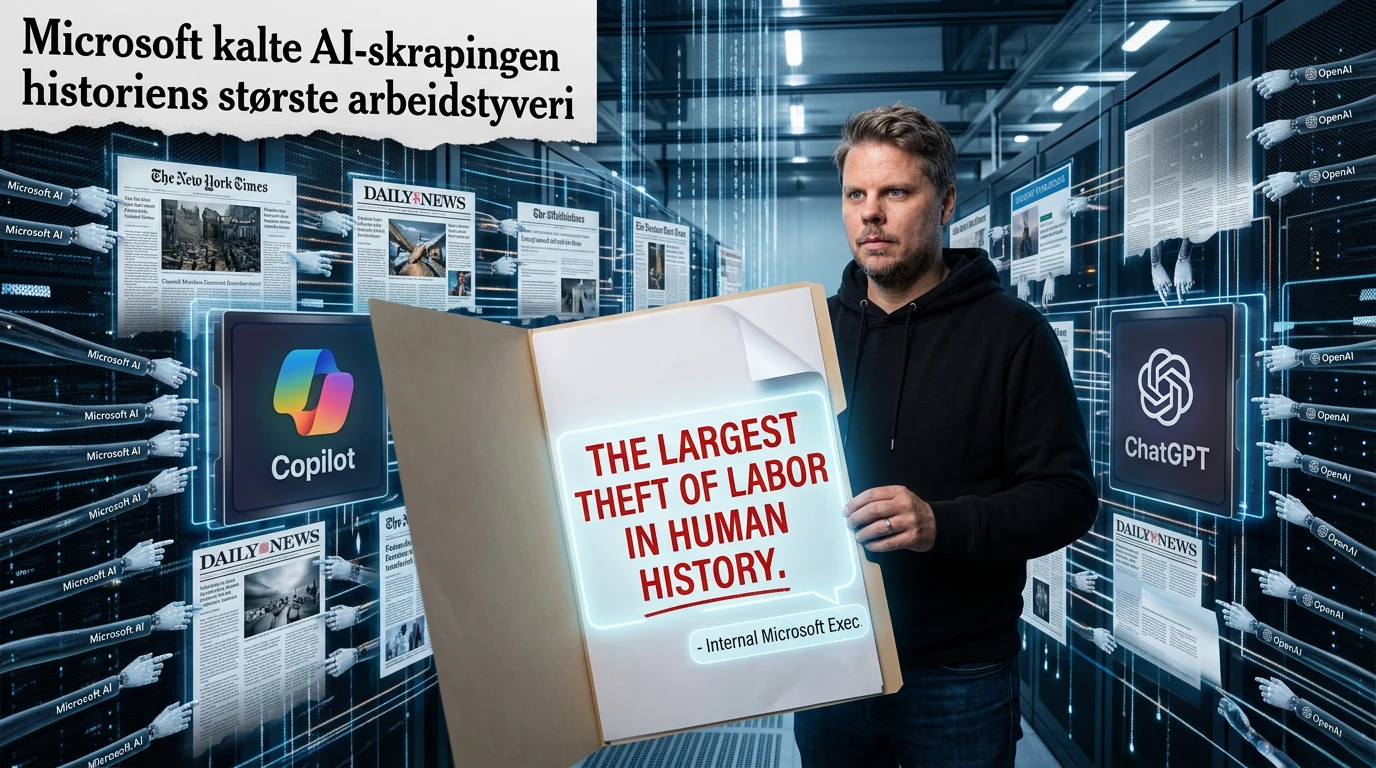
Microsoft kalte internt AI-skrapingen «historiens største arbeidstyveri». Samtidig skal Microsoft og OpenAI ha kopiert enorme mengder journalistikk, omgått betalingsmurer og bygd kommersielle AI-produkter på materialet.
Nye, mindre sladdede dokumenter i opphavsrettssaken mellom flere amerikanske mediehus og Microsoft og OpenAI viser en ganske annen temperatur bak lukkede dører enn den vi har fått servert offentlig. Microsoft-forskere advarte om at AI-svar kunne kutte trafikken til kildene, svekke økonomien deres og til slutt ødelegge selve tilgangen på godt innhold. OpenAI-ledere beskrev samtidig produktene som en direkte trussel mot utgiverne de lærte av.
Dette er stygt. Ikke fordi en leder brukte et dramatisk uttrykk i et internt notat, men fordi dokumentene ifølge saksøkerne viser at selskapene forsto sammenhengen: kopier innholdet, behold brukeren i AI-produktet, send mindre trafikk tilbake og gjør det vanskeligere for folkene som laget materialet å få betalt. Så fortsatte de.
Hva viser dokumentene om Microsoft og OpenAIs AI-skraping?
De nye dokumentene viser ifølge TechCrunchs gjennomgang av det uforseglede prosesskrivet at Microsoft og OpenAI internt diskuterte både omfanget av kopieringen og hvordan AI-produktene kunne erstatte originalkildene. Det mest brutale sitatet kom fra Brent Hecht, Microsofts direktør for Applied Science, i et internt notat fra januar 2023.
Hecht beskrev kopieringen som et tyveri uten sidestykke og som «the largest theft of labor in human history». På norsk blir det omtrent historiens største tyveri av menneskelig arbeid. Det er ikke en sint journalist eller en forfatterforening som bruker de ordene. Det er en Microsoft-leder som omtaler verdikjeden selskapets egne AI-produkter var avhengige av.
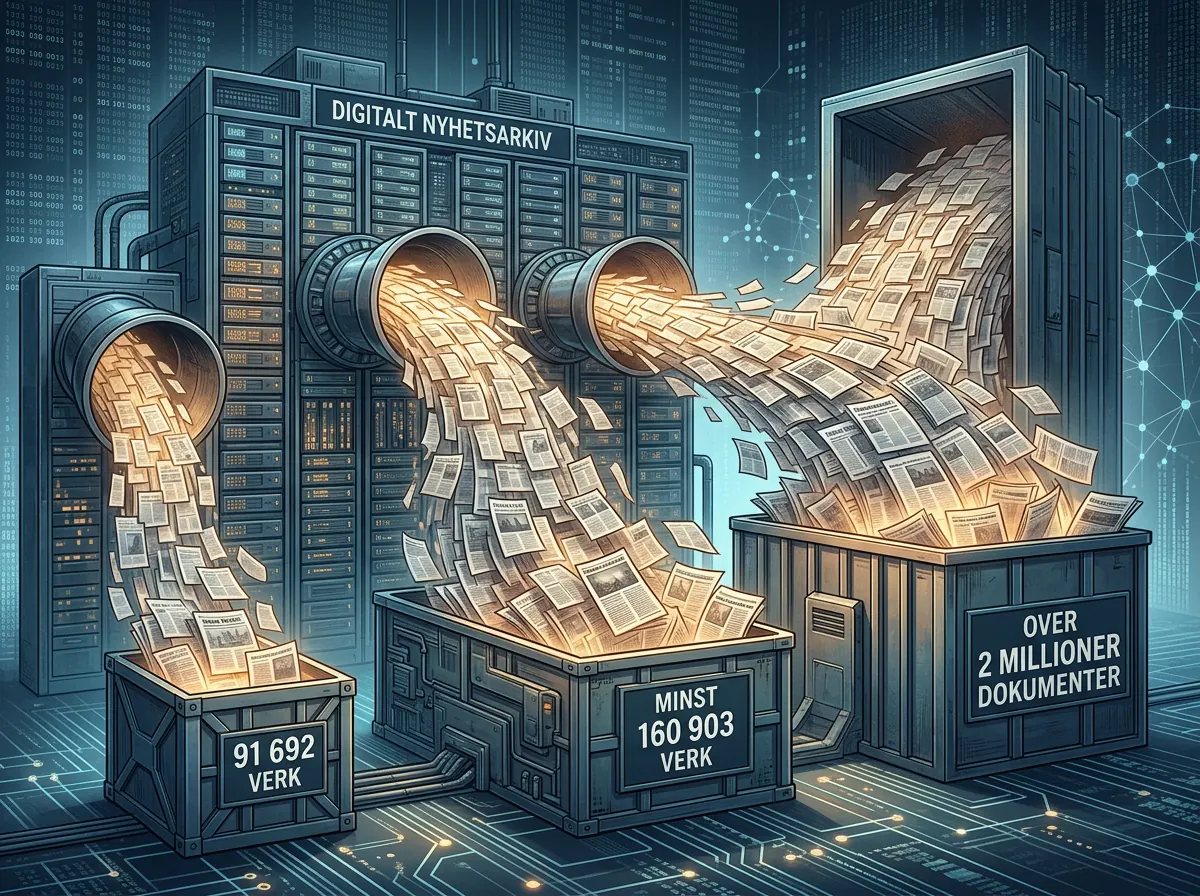
Omfanget er heller ikke en fotnote. Mellomtreningen av OpenAIs modeller skal alene ha inneholdt over 91 692 kopier av verk fra The New York Times, Daily News og Center for Investigative Reporting. Ett datasett basert på Common Crawl skal ha inneholdt over 2 millioner dokumenter fra nytimes.com, mens Microsofts Project Mango ifølge prosesskrivet samlet minst 160 903 unike verk fra mediehusene.
Dette er påstander og bevis sitert av saksøkerne i et pågående søksmål. De underliggende vedleggene er fortsatt forseglet, og sitatene er derfor ikke tilgjengelige i full opprinnelig sammenheng. Det er en viktig begrensning. Men tallene, de interne formuleringene og beskrivelsen av arbeidsflyten er konkrete nok til at selskapene må svare skikkelig på dem.
Microsoft skal ha målt opptil 93 prosent mindre trafikk
Microsofts egne målinger skal ha vist at Copilots svarmotor ga opptil 93 prosent lavere klikkrate til The New York Times enn vanlig Bing-søk. Det er kanskje sakens viktigste tall. Hele fair use-forsvaret blir vanskeligere når selskapets egne data peker mot at sluttproduktet faktisk erstatter kilden og svekker markedet for originalarbeidet.
En intern Microsoft-presentasjon fra januar 2024 kalte utviklingen en «doom loop». Logikken er enkel: AI-svaret holder brukeren borte fra nettstedet, nettstedet får færre besøk og mindre inntekt, redaksjonen får dårligere råd til journalistikk, og AI-selskapet får etter hvert dårligere materiale å trene og hente svar fra. Microsoft-dokumentet skal selv ha advart om at dette kunne skade både modellene og hele nettet.
OpenAIs daværende ChatGPT-sjef Nick Turley skal ha skrevet at utgivere sto overfor en eksistensiell trussel fordi chatbotene i stor grad erstattet innholdet, og ville gjøre det stadig mer etter hvert som de ble bedre. Satya Nadella er sitert på at innhold bak betalingsmur bør lisensieres når det brukes til trening eller som kunnskapsgrunnlag. Han skal også ha forklart at Microsoft kunne ha krevd ny trening av modellene dersom han hadde visst at OpenAI brukte materiale bak betalingsmur.
Det er nettopp dette som gjør saken så alvorlig. Selskapene kan ikke samtidig hevde at modellene ikke skader markedet, og internt advare om at de erstatter kildene og tapper dem for trafikk. Begge deler kan ikke være den ærlige beskrivelsen.
Hvordan skal innholdet ha blitt samlet inn?
Prosesskrivet beskriver flere veier inn i datasettene. OpenAI skal ha levert hele GPT-3-datasettet til Microsoft for evaluering i kommersielle produkter. Microsoft skal på sin side ha levert treningsdata gjennom prosjektene Taxi og Mango. I tillegg skal store mengder journalistikk ha kommet via Bing-indeksen og Common Crawl.
Det mest belastende er påstanden om betalingsmurene. En OpenAI-forsker skal ha fortalt president Greg Brockman om en metode for å komme rundt betalingsmuren til The New York Times uten å bli oppdaget. Svaret hans var kort og begeistret. Hvis fremstillingen holder når vedleggene en dag kan leses i full sammenheng, er dette langt unna et passivt spørsmål om hva som tilfeldigvis lå åpent på nettet.
Dokumentene beskriver også at opphavsrettsmerker ble fjernet fra treningsdata før materialet nådde modellen. Begrunnelsen skal ha vært at forskerne ikke ønsket at modellen skulle gjengi slike merker til brukerne. Samlet tegner dette et bilde av en organisert datastrøm, ikke en tilfeldig robot som snublet over noen nettsider.
OpenAI forsvarer på sin side treningen som fair use og sier at modellene trenes på offentlig tilgjengelige data. Selskapet mener bruken er transformerende, og at The New York Times fremstiller saken som et falskt valg mellom menneskelig skapende arbeid og AI. Det er OpenAIs tydelige offentlige posisjon. Problemet er at de nye opplysningene nettopp utfordrer to sentrale deler av den: om alt materialet virkelig var offentlig tilgjengelig, og om produktene faktisk skader markedet for originalverkene. TechCrunch opplyste 17. september at verken Microsoft eller OpenAI hadde svart på deres forespørsler om de nye opplysningene.
Fair use avgjøres ikke av et slagord
Amerikansk fair use bygger på en samlet vurdering av fire faktorer: formålet med bruken, typen verk, hvor mye som er brukt og virkningen på markedet for originalen. Det amerikanske opphavsrettskontoret understreker at ingen fast formel automatisk avgjør saken. Derfor er interne målinger av trafikkfall og formuleringer om erstatning særlig relevante, men de er ikke alene en dom.
OpenAI viser blant annet til tidligere amerikanske avgjørelser der modelltrening ble ansett som transformerende. Det betyr ikke at all innsamling, alle datasett og alle sluttprodukter automatisk er lovlige. Å hente offentlig tilgjengelig materiale, å omgå en betalingsmur og å gjengi eller erstatte et produkt er forskjellige faktiske situasjoner. Retten må vurdere det konkrete bevisbildet.
Jeg er heller ikke interessert i den lettvinte ideen om at all læring er tyveri. Mennesker leser, lærer, husker og skaper noe nytt. Jeg mener også at folk må få bruke bøker og annet materiale de lovlig har kjøpt som privat referanse eller RAG-materiale i en lokal AI på sin egen maskin. Det er noe helt annet enn å kopiere vernet materiale i industriell skala, bygge en kommersiell skytjeneste og la den konkurrere med dem som laget grunnlaget.
Den forskjellen er viktig. Hvis alt blandes sammen, ender debatten i to like dårlige grøfter: enten at enhver modelltrening er tyveri, eller at alt som kan lastes ned er fritt fram. Begge deler er for enkelt.
Dobbeltmoralen er vanskelig å komme utenom
Jeg skrev om søksmålet fra The New York Times mot Microsoft og OpenAI da det kom i desember 2023. Den gangen var kjernespørsmålet om AI-trening på avisens artikler brøt opphavsretten. De nye opplysningene endrer ikke at retten må avgjøre lovligheten, men de sier mye mer om hva folk inne i selskapene selv forsto.
Microsoft selger programvare, skytjenester og immaterielle rettigheter med svært tydelige lisensvilkår. OpenAI tar betalt for tilgang til modeller og tjenester. Ingen av dem driver etter prinsippet om at det er greit å kopiere alt bare fordi det er teknisk mulig. Når det gjelder verdiene deres egne produkter bygger på, blir språket om rettigheter plutselig langt mykere.
Så nei, jeg kjøper ikke at dette bare er gammel juss som ikke passer til ny teknologi. Teknologien er ny. Prinsippet er ikke det. Hvis du bygger en lønnsom tjeneste på andres arbeid, vet at tjenesten kan erstatte dem, måler at du sender langt mindre trafikk tilbake og i tillegg skal ha omgått betalingsmurer, kan du ikke gjemme hele diskusjonen bak ordet innovasjon.
Det betyr heller ikke at svaret er et nytt gigantisk offentlig kontrollapparat som bare de største selskapene har råd til å håndtere. Utgangspunktet bør være langt enklere: klare avtaler, reelle lisenser, sporbarhet rundt datakilder og muligheten til å si nei. Selskaper som vil selge AI bygget på profesjonelt innhold, må kunne fortelle hva de har brukt og på hvilket grunnlag.
Hva bør skapere, utgivere og AI-kunder gjøre?
Skapere og utgivere bør ikke nøye seg med høflige løfter om partnerskap. Be om konkrete svar: Ble materialet brukt til trening, søk eller RAG? Var det bak betalingsmur? Kan det fjernes? Hvordan måles trafikk og markedsvirkning? Og viktigst: Finnes det en avtale som faktisk betaler dem som har laget innholdet?
Bedrifter som kjøper AI-tjenester bør stille de samme spørsmålene i leverandørvurderingen. Uklar treningshistorikk er ikke bare en moralsk diskusjon på internett. Det kan bli en juridisk og kommersiell risiko, særlig hvis egne data blandes inn i systemer der leverandøren er vag om lagring, trening og rettigheter.
Vanlige brukere trenger ikke slutte å bruke AI. Det ville vært en temmelig hul konklusjon fra en som jobber med teknologien. Men vi bør slutte å late som om gode svar oppstår fra ingenting. Når svaret bygger på fersk journalistikk, forskning, bøker eller annet profesjonelt arbeid, er den opprinnelige kilden fortsatt verdt et besøk og ofte et abonnement.
Microsofts egne folk så problemet. OpenAIs egne folk så problemet. De beskrev faren for utgiverne, tapet av trafikk og risikoen for at innholdsgrunnlaget skulle tørke inn. Da holder det ikke å møte offentligheten med en blankpolert historie om at alt bare er transformasjon og framgang.
Dette er ikke et angrep på AI. Det er et krav om at selskapene bak AI følger de samme grunnleggende spillereglene de forventer at alle andre følger. Når de selv bruker ordet tyveri internt, holder det ikke med glatt fair use-retorikk. Skapere og utgivere bør kreve lisensiering, sporbarhet og en reell mulighet til å si nei – og AI-kunder bør behandle uklare rettigheter som leverandørrisiko.
Ofte stilte spørsmål
Har en domstol slått fast at Microsoft og OpenAI stjal innhold?
Nei. Opplysningene kommer fra saksøkernes prosesskriv i en pågående opphavsrettssak. De nye dokumentene gjengir interne meldinger, datasett og målinger, men retten har ikke endelig avgjort om bruken var ulovlig.
Hvor mye innhold skal ha blitt kopiert?
Saksøkerne viser blant annet til over 91 692 kopier av verk i OpenAIs mellomtreningsdata, over 2 millioner dokumenter fra nytimes.com i ett Common Crawl-basert datasett og minst 160 903 unike verk i Microsofts Project Mango.
Hva sier OpenAI til sitt forsvar?
OpenAI mener modelltrening på offentlig tilgjengelige data er transformerende fair use, og at teknologien støtter menneskelig skapende arbeid og journalistikk. De nye påstandene utfordrer særlig hva som var offentlig tilgjengelig, og om AI-produktene skader markedet for kildene.
Er privat bruk av en kjøpt bok i lokal AI det samme?
Nei, ikke etter min vurdering. Privat bruk av lovlig kjøpt materiale som lokalt referanse- eller RAG-grunnlag er noe helt annet enn industriell kopiering til en kommersiell skytjeneste som konkurrerer med opphavspersonen. Den juridiske vurderingen vil likevel avhenge av land og konkret bruk.