Innhold Vis
Qwen3.8-Omni-Flash kan lete målrettet etter svaret i lange lyd- og videofiler, resonnere over funnene og bruke verktøy underveis. Det er langt mer nyttig enn enda en modell som bare kan ta imot en video og skrive et sammendrag.
Alibaba beskriver modellen som sin første omnimodale Qwen-modell bygget rundt agentiske oppgaver. Den tar imot tekst, bilder, lyd og video, har et kontekstvindu på 1 million tokens og kan kalle funksjoner og nettsøk. Samtidig er den API-only ved lansering, gir bare tekst tilbake og kommer uten åpne modellvekter.
Den kombinasjonen gjør Qwen3.8-Omni-Flash spennende for møter, kursvideoer, intervjuer og store mediearkiver. Men tallene kommer foreløpig fra Qwen selv. Jeg ville derfor behandlet modellen som en lovende ny arbeidsmotor som må prøves på egne filer, ikke som en ferdig kåret vinner.
Hva er Qwen3.8-Omni-Flash?
Qwen3.8-Omni-Flash er en multimodal AI-modell som tar imot fire typer innhold – tekst, bilder, lyd og video – og svarer med tekst. QwenCloud oppgir 1 million tokens kontekst, maksimalt 991 000 input-tokens, 131 000 output-tokens og opptil 262 000 reasoning-tokens.
Modellen bygger på Qwen3.8-Flash-Next-arkitekturen. Det viktige skillet er at Omni-utgaven ikke bare har fått et vedleggssystem på toppen. Lyd- og videoforståelse, reasoning og tool use er samlet i modellen, slik at den kan forstå innholdet, planlegge oppgaven, hente mer informasjon og levere et resultat i samme kjede.
Dette er likevel ikke en modell som lager tale eller ferdig video som output. Den leverer tekst. Hvis oppgaven ender i videoredigering, dubbing eller produksjon av en rapport, er det verktøy rundt modellen som utfører disse stegene. Alibaba peker fortsatt på Qwen3.5-Omni for oppgaver som krever generert tale.
Qwen har allerede hatt millionkontekst i andre modeller. Jeg skrev tidligere om Qwen 3.6 med 1 million tokens på OpenRouter. Forskjellen her er at den lange konteksten kobles direkte til lyd, video og en agent som kan velge hva den faktisk trenger å undersøke.
Hvordan finner modellen det viktige i en lang video?
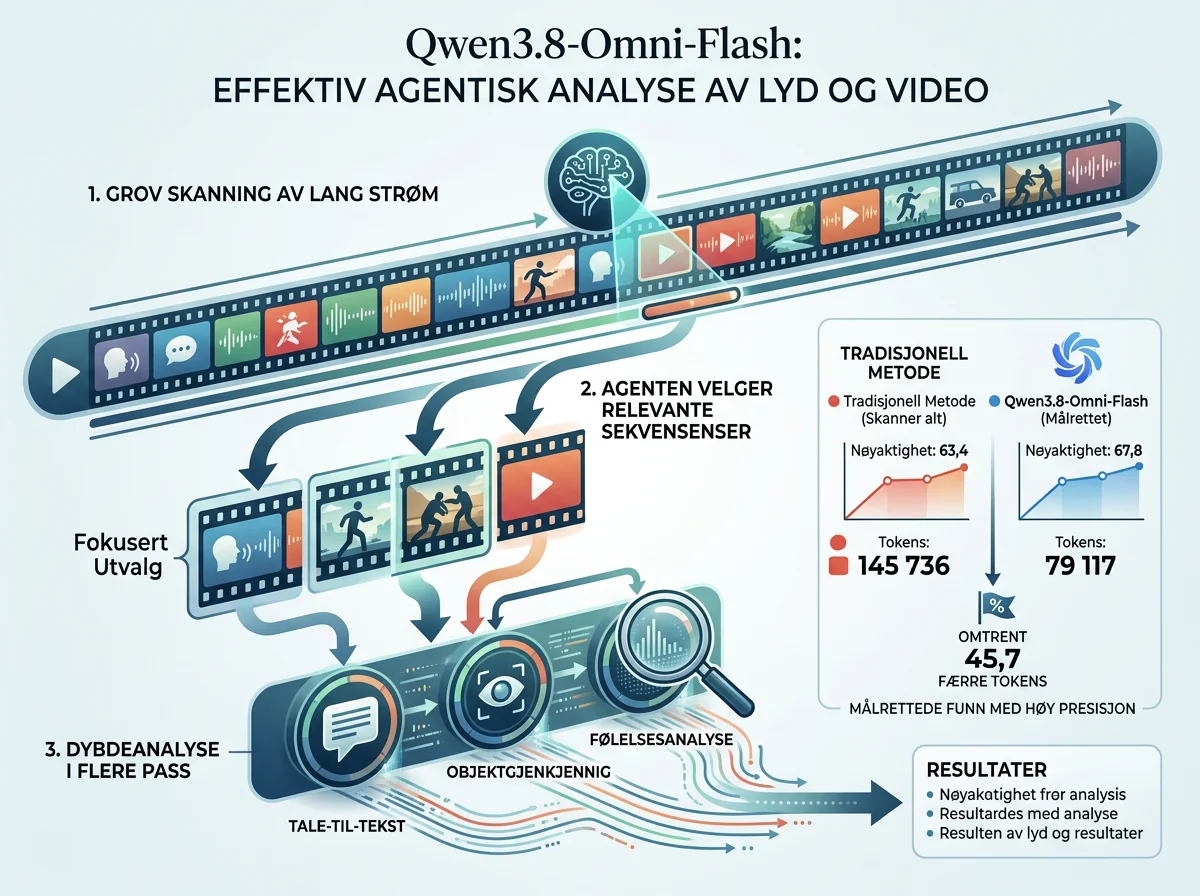
Qwen kaller metoden «agentic perception». Modellen starter med spørsmålet, vurderer hvilke deler av lyd- og videomaterialet som kan inneholde svaret, og samler bevis i flere runder fra grovt til detaljert nivå. Den skal altså slippe å bruke like mye oppmerksomhet på to timer med opptak når det avgjørende øyeblikket varer i tre minutter.
Det er en praktisk viktig idé. Tenk på et langt kundemøte der du vil finne alle løfter om leveringstid, et kursopptak der du trenger stegene i én bestemt demonstrasjon, eller et stort videobibliotek der du må finne hvem som sa hva og når. Et lineært sammendrag av hele filen blir fort både dyrt og upresist. En agent som kan undersøke relevante sekvenser på nytt, har en bedre arbeidsform.
I Qwens egne tall for OmniVideoBench økte nøyaktigheten fra 63,4 til 67,8, mens tokenbruken falt fra 145 736 til 79 117. Det er omtrent 45,7 prosent færre tokens. MarkTechPosts gjennomgang av lanseringen oppgir også forbedringer på 36,5 poeng i WildClawBench-MM og 22,3 poeng i AgenticVBench.
Fine tall. Men dette er leverandørens tester, og uavhengige resultater var ikke tilgjengelige da saken ble publisert 18. september 2026. En benchmark kan vise at metoden har potensial. Den kan ikke fortelle deg om modellen finner den ene utydelige beslutningen i et norsk møte med avbrytelser, dialekt og dårlig mikrofon.
Hva kan modellen gjøre som agent?
Qwen3.8-Omni-Flash støtter function calling, nettsøk, strukturerte svar, kontekst-caching og batch-kall. API-et kan brukes gjennom både DashScope-protokollen og en OpenAI-kompatibel protokoll, med støtte for Chat Completions og Responses API. Det senker terskelen for utviklere som allerede har en agent eller mediepipeline bygget rundt OpenAI SDK.
Tool use betyr at modellen kan gjøre mer enn å beskrive en video. Den kan for eksempel finne hendelser og tidsstempler, sende strukturerte funn til et redigeringsverktøy, hente bakgrunnsinformasjon fra nettet eller bygge et søkbart minne over et lengre opptak. Det er samme retning jeg beskrev i saken om MiniCPM5-1B og tool use: Modellen blir mer nyttig når reasoning ender i en kontrollert handling.
Thinking er slått på som standard med reasoning_effort satt til xhigh. Utviklere som ikke trenger den ekstra reasoning-runden, kan sette nivået til none. Det er verdt å teste begge deler. Maksimal tenking på alt kan bli en dyr vane, særlig når jobben bare er å hente enkle tidsstempler eller lage et grovt referat.
Her ligger også et viktig skille mellom agentisk og autonom. Modellen kan planlegge og kalle verktøy, men du bestemmer hvilke verktøy den får, hvilke data de kan lese og hvilke handlinger som krever godkjenning. En videomodell trenger ikke skrivetilgang til hele produksjonsmiljøet bare fordi den kan lage en god klippeliste.
Hvor lange lyd- og videofiler støttes?
Alibaba Cloud Model Studio dokumenterer videofiler på opptil 2 timer og lydfiler på opptil 3 timer for Qwen3.8-Omni-Flash. Modellen støtter lyd på 113 språk og dialekter, og Alibaba oppgir stabile resultater for video samplet med opptil 15 bilder per sekund.
Video via URL kan være opptil 2 GB. Modellen kan dessuten behandle vanlig stereo og firekanals FOA-romlyd når use_multichannel er aktivert. Det kan være nyttig i møteopptak og produksjoner der retning og separate lydkanaler faktisk bærer informasjon, men det er ikke en innstilling jeg ville slått på uten å måle kostnaden mot nytten.
Tjenesten er oppført i seks regioner: Beijing, Singapore, Hongkong, Tokyo, Frankfurt og Virginia. API-nøkkelen må høre til regionen du bruker. For norske bedrifter som arbeider med kundeopptak, interne møter eller annet følsomt materiale, er dataplacering og selskapets vilkår minst like viktige som hvor pent modellen scorer på en benchmark.
Det er også verdt å merke seg at millionkontekst ikke betyr at alle mediefiler automatisk passer. Varighet, filstørrelse, sampling, lydkanaler og tokenbruk setter hver sine grenser. «1M» er en kapasitet, ikke en tryllestav.
Hva koster Qwen3.8-Omni-Flash?
QwenCloud oppgir 0,15 dollar per million input-tokens og 0,47 dollar per million output-tokens. Med Norges Banks USD-kurs på 9,4286 kroner 17. september 2026 er det cirka 1,41 kroner for input og 4,43 kroner for output per million tokens. Treff i den implisitte cachen koster 0,016 dollar, omtrent 15 øre per million tokens.
De prisene ser svært lave ut for ren tekst. Med lyd og video er det likevel den faktiske tokeniseringen av filen, sampling og antallet analysepass som avgjør regningen. Qwen hevder at lydinput koster over 98 prosent mindre per time enn Qwen3.5-Omni-Plus, og at kombinert lyd- og videoinput koster over 93 prosent mindre. Det er leverandørens sammenligning, ikke et løfte om hva din ferdige arbeidsflyt vil koste.
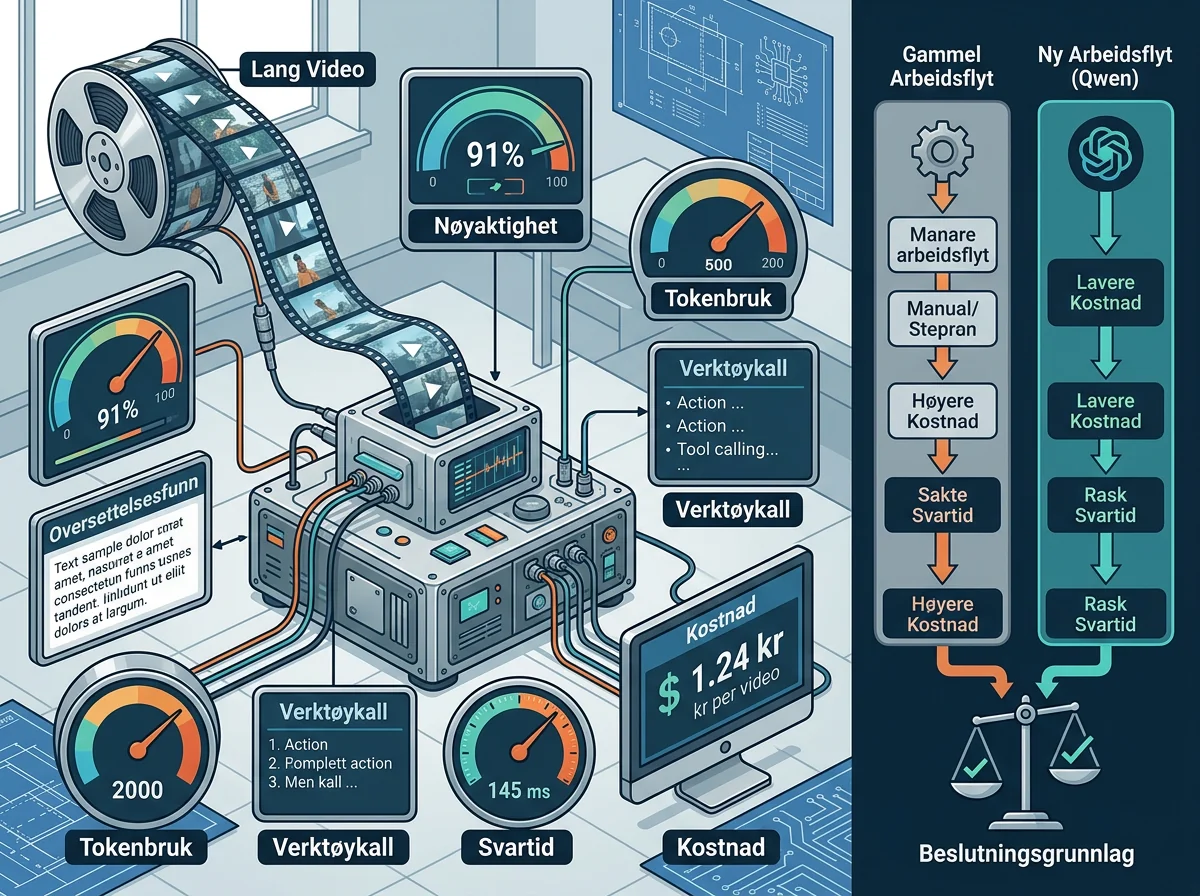
Den riktige testen er derfor enkel: Kjør et representativt opptak, logg input- og output-tokens, antall verktøykall, total tid og om svaret faktisk er riktig. Sammenlign så med modellen eller arbeidsflyten du allerede bruker. Billige tokens er fortsatt bortkastede penger hvis du må kontrollere hele videoen manuelt etterpå.
Kan du kjøre modellen lokalt?
Nei. Qwen3.8-Omni-Flash er tilgjengelig som hosted API gjennom QwenCloud og Alibaba Cloud Model Studio, og kan prøves i Qwen Studio. Alibaba annonserte ikke åpne vekter for denne Omni-modellen ved lansering. Du kan derfor ikke laste den ned, kjøre den på egen GPU eller kontrollere hele datakjeden lokalt.
Det er en reell begrensning, ikke en fotnote. Mange av de mest interessante bruksområdene handler om møter, råopptak, kundeintervjuer og annet materiale du kanskje ikke vil sende til en ekstern skytjeneste. API-only betyr også at pris, tilgjengelighet, regioner og modelloppførsel kan endres uten at du kontrollerer versjonen selv.
Basismodellen Qwen3.8-Flash-Next ble riktignok lansert med åpne vekter, men det gjør ikke Omni-Flash lokal. Navnene ligger tett nok til å skape forvirring. Kontroller alltid den konkrete modell-ID-en qwen3.8-omni-flash og vilkårene rundt den før du designer en arbeidsflyt som forutsetter lokal kjøring.
Hva er Qwen-MM-Plugins?
Qwen-MM-Plugins er et Apache 2.0-lisensiert verktøysett som kobler multimodale egenskaper til agentmiljøer. Installasjonsverktøyet støtter blant annet Codex, Claude Code, Qwen Code, Gemini CLI, Qoder og OpenClaw. Hver funksjon installeres som en Skill og kan også ha en valgfri MCP-server.
Tre eksempler viser hva Qwen vil bruke modellen til. omni-memory bygger et lyd- og videominne over lange opptak. omni-video2note gjør en opplæringsvideo om til en illustrert PDF. omni-chatcut dekker arbeidsflyter som musikkvideo, filmkommentar og videooversettelse med bevart taler.
Det finnes en viktig operativ begrensning: De fleste agentmiljøer kan foreløpig ikke sende lyd direkte til hovedmodellen. Qwen skriver derfor at lyd håndteres gjennom API-et. Bilder og videobilder kan leses mer direkte i miljøer som støtter det, men en lokal filreferanse betyr ikke nødvendigvis at all behandling skjer lokalt.
Dette er verdt å kontrollere før du installerer noe. Kartlegg hvilken komponent som åpner filen, hva som lastes opp, hvilken region som mottar dataene og om midlertidige filer blir slettet. Et fint agentgrensesnitt kan skjule overraskende mange nettverkskall.
Er Qwen3.8-Omni-Flash verdt å prøve?
Ja, hvis du faktisk arbeider med lange lyd- eller videokilder og kan bruke en ekstern API-tjeneste. Den mest lovende egenskapen er ikke millionkonteksten alene, men at modellen kan prioritere relevante sekvenser, undersøke dem i flere runder og koble funnene til verktøy.
Jeg ville startet med én oppgave der fasiten er kjent. Be modellen finne bestemte beslutninger, sitater og tidsstempler i et opptak, og kontroller både det den fant og det den overså. Mål tokenbruk, svartid og kostnad. Test deretter samme fil med dagens løsning. Da får du et svar som betyr mer enn 29 leverandørbenchmarks.
Qwen3.8-Omni-Flash peker mot en nyttig utvikling: AI som ikke bare «ser video», men som kan lete, resonnere og handle rundt innholdet. Det kan spare både tokens og arbeid. API-only, tekstoutput og manglende uavhengige tester gjør samtidig at jeg holder igjen champagnen. Lovende? Absolutt. Dokumentert best for dine opptak? Ikke før du har målt det selv.
Ofte stilte spørsmål
Har Qwen3.8-Omni-Flash åpne modellvekter?
Nei. Qwen3.8-Omni-Flash ble lansert som en hosted API-modell gjennom QwenCloud og Alibaba Cloud Model Studio. Alibaba annonserte ikke åpne vekter for Omni-utgaven, selv om basismodellen Qwen3.8-Flash-Next tidligere ble utgitt med åpne vekter.
Kan Qwen3.8-Omni-Flash lage tale eller video?
Nei, modellen gir tekst som output. Den kan forstå tekst, bilder, lyd og video og deretter bruke verktøy, men produksjon av tale, bilder eller ferdig video må utføres av andre modeller eller verktøy i arbeidsflyten.
Hvor mye video kan modellen analysere?
Alibaba Cloud oppgir opptil 2 timer video og 2 GB per videofil via URL. Lydfiler kan være opptil 3 timer. Den praktiske kapasiteten påvirkes også av sampling, filformat, innhold og hvor mange analysepass agenten bruker.
Fungerer Qwen3.8-Omni-Flash med OpenAI SDK?
Ja. Tjenesten tilbyr en OpenAI-kompatibel protokoll og støtter både Chat Completions og Responses API. Du må bruke riktig DashScope-endepunkt og API-nøkkel for regionen der modellen skal kjøres.