Innhold Vis
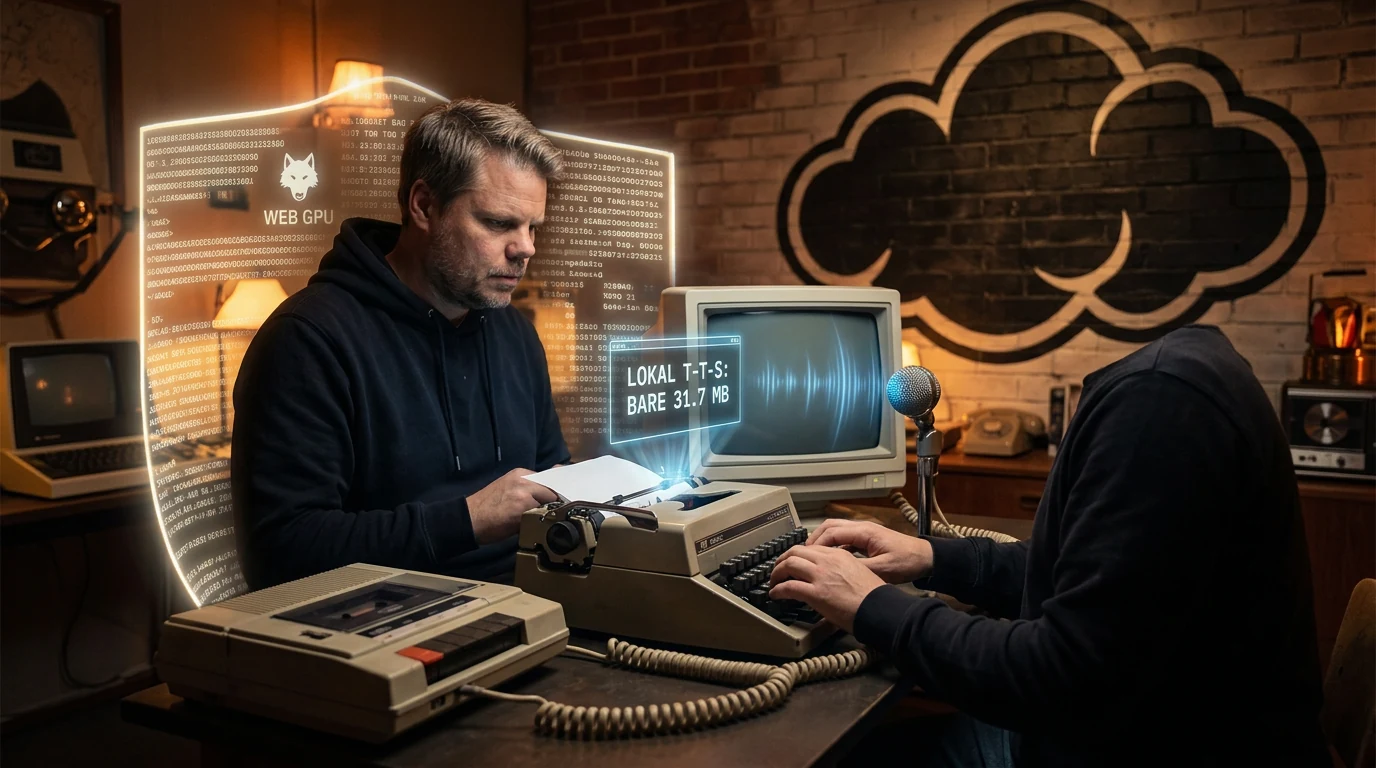
Woof er en tekst-til-tale-modell på bare 31,7 MB som kjører lokalt i nettleseren. Underdog har pakket den inn i et lite retrospill, men den virkelige nyheten er at talegenereringen skjer på din egen maskin i stedet for på en server langt borte.
Du skriver en setning på en virtuell skrivemaskin, trykker Enter og får teksten lest opp. Ifølge Underdog har modellen 30,7 millioner parametere, bruker WebGPU i nettleseren og kan fungere uten internett etter at den er lastet inn. Det er et herlig konkret eksempel på hvor liten lokal AI er i ferd med å bli.
Demoen inneholder også musikk, men her er det viktig å holde tungen rett i munnen: Woof er tekst-til-tale-modellen. Underdog sier at alle stemmene og sangene i opplevelsen er laget offline av lokale modeller, ikke at den samme 31,7 MB-modellen lager både tale og musikk.
Hva er Woof?
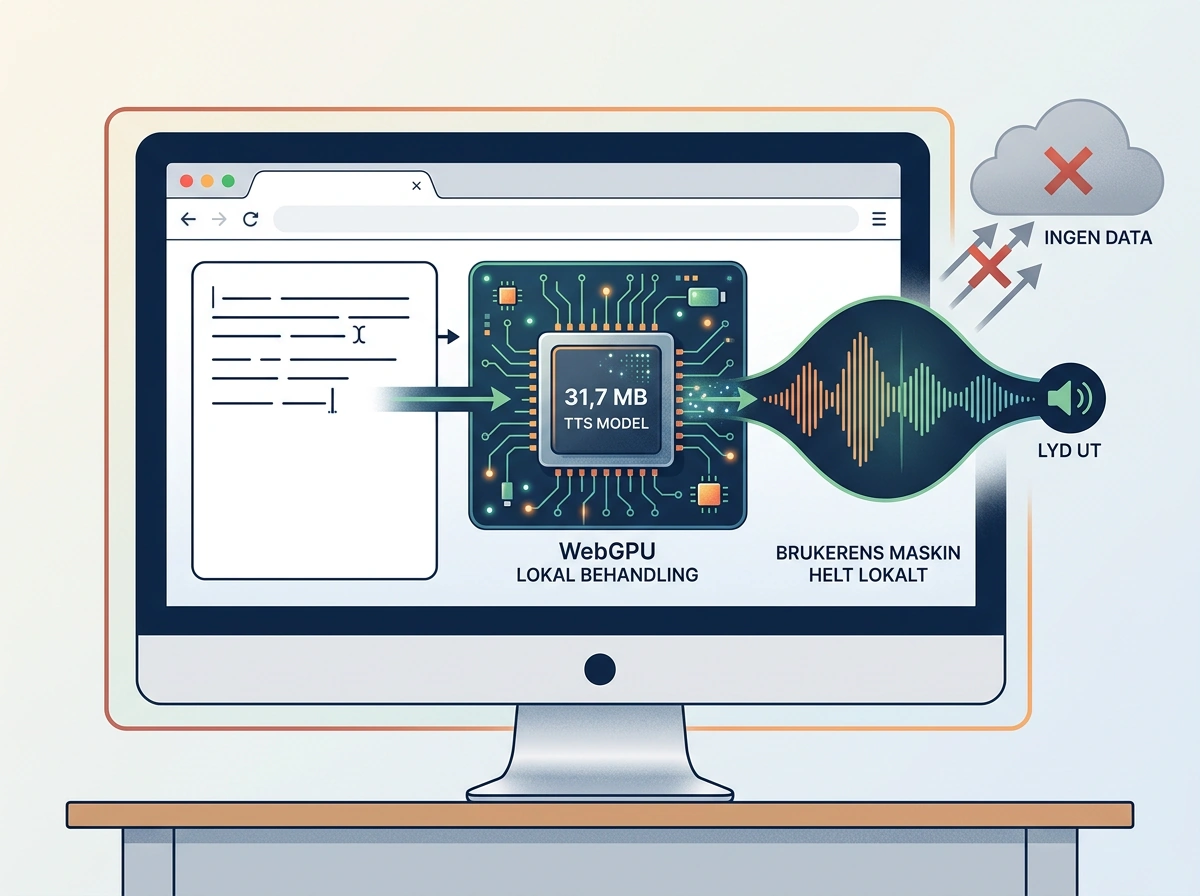
Woof er Underdogs kompakte modell for tekst-til-tale. Den har 30,7 millioner parametere og en oppgitt nedlastingsstørrelse på 31,7 MB. I Underdogs egen Escape-demo kjører modellen direkte i nettleseren ved hjelp av WebGPU og leser opp teksten brukeren skriver.
Tekst-til-tale betyr at modellen gjør skrevet tekst om til lyd. Det er det motsatte av tale-til-tekst, der en modell transkriberer det noen sier. Skillet høres banalt ut, men det blir fort rot når ord som «talemodell» brukes om begge retninger.
Underdog kaller Woof en «frontier»-modell. Det er selskapets egen merkelapp, ikke en uavhengig kvalitetsdom. Jeg har heller ikke sett en offentlig modellrapport med brede sammenligninger av naturlighet, uttale, språk og stemmer som gjør det mulig å slå fast at Woof matcher de beste skybaserte stemmetjenestene.
Det som kan slås fast, er mer jordnært og egentlig mer spennende: 31,7 MB er lite nok til at hele modellen kan leveres som en del av en nettleseropplevelse. Det flytter tekst-til-tale fra en fjern API-tjeneste til programvaren som allerede kjører på maskinen din.
Hva viser nettleserdemoen?
Escape er laget som et lite spill i et rom med skrivemaskin, CRT-skjerm, lampe og radio. TechCrunch beskriver hvordan du kan skrive på skrivemaskinen og få Woof til å lese teksten, mens en dreieknapp på radioen spiller ulike musikksnutter.
Underdog gjør samtidig et poeng av at stemmen kjører på brukerens egen GPU med WebGPU. Nettlesere uten WebGPU får beskjed om at Woof ikke kan snakke der. Det er altså ikke bare en video av en modell som kjører på utviklerens maskin; selve nettsiden er laget for å laste modellen og utføre talegenereringen lokalt.
Selskapet oppgir også at Woof kan kjøre 18 ganger raskere enn sanntid på én CPU-tråd i en bærbar PC. Det er en produsentpåstand uten publisert testoppsett i materialet jeg har sett, så tallet bør behandles som et lovende signal – ikke et ferdig, uavhengig benchmark.
Musikken er en egen del av demonstrasjonen. Underdog oppgir at sangeksemplene hovedsakelig ble generert lokalt på en M5 Max med 48 GB minne, mens ett eksempel er merket M5 med 48 GB. Genereringstidene ligger fra rundt 39 til 131 sekunder. De tallene beskriver musikksnuttene, ikke Woofs talefart. Er du mer interessert i lokale musikkmodeller, har jeg tidligere skrevet om ACE-Step 1.5 og hvordan en liten språkmodell kan styre selve musikkgenereringen.
Hvorfor betyr en modell på 31,7 MB noe?
En modell på 31,7 MB er liten nok til at nedlasting, oppstart og lokal lagring blir langt mindre krevende enn med tale-AI på flere hundre megabyte eller gigabyte. Det åpner for tale i apper, hjelpemidler, spill og lokale assistenter uten at hver setning må sendes til en skytjeneste.
Det kan gi lavere ventetid og mindre nettbruk. Enda viktigere er kontrollen over dataene. Hvis teksten behandles og talen genereres lokalt, trenger ikke et manus, et privat notat eller innholdet i en samtale forlate enheten bare for å bli lest høyt. Det er en reell fordel, ikke pynt i en spesifikasjonsliste.
Lokal kjøring betyr også at funksjonen kan fortsette når nettet er dårlig eller helt borte. Underdog har bygget hele historien rundt kampen mot den påtrengende «Darkcloud», og ja, budskapet er omtrent like subtilt som en murstein gjennom vinduet. Men selskapet har i det minste laget en demo der poenget kan prøves i praksis ved å slå av nettet.
En liten modell er likevel ikke automatisk en god modell. Nedlastingsstørrelsen sier lite om uttale, rytme, stemmekvalitet, språkdekning og stabilitet på lange tekster. Den sier heller ikke hvor mye arbeidsminne modellen og kjøremiljøet faktisk trenger. Woof viser at lokal tale kan pakkes svært kompakt. Den dokumenterer foreløpig ikke at alle større modeller er overflødige.
Er Woof åpen og klar for kommersiell bruk?
Underdog omtaler Woof som åpne vekter, men knytter dem til CC BY-NC 4.0. «NC» betyr ikke-kommersiell. Det er derfor misvisende å lese «åpen» som «fritt fram i et betalt produkt». Lisensen tillater deling og bearbeiding med kreditering, men ikke kommersiell bruk uten andre rettigheter.
For studenter, hobbyprosjekter, forskning og prototyper kan det fortsatt være nyttig. For en bedrift som vil bygge Woof inn i en kundetjeneste, en betalt app eller en annen kommersiell løsning, må lisensen gjennomgås før modellen tas i bruk. Det er ikke en fotnote. Det avgjør om en teknisk lovende modell faktisk passer prosjektet.
Det offentlige materialet gir heller ikke en komplett oppskrift for produksjonsbruk. Jeg finner ingen tydelig kompatibilitetsmatrise for nettlesere og maskinvare, ingen oppgitt pris for kommersielle rettigheter og ingen generell lanseringsdato for hele Underdog-appen. Demoen beviser at konseptet fungerer i det miljøet Underdog har bygget. Den er ikke det samme som en ferdig plattformavtale.
Dette er en viktig forskjell mellom en imponerende teknisk demonstrasjon og en komponent du kan legge rett inn i et produkt. Woof har fått den første delen på plass. Dokumentasjon, rettigheter, integrasjon og forutsigbar ytelse må følge etter før bedrifter kan behandle modellen som vanlig infrastruktur.
Hva vet vi om kvaliteten og norsk tale?
Det finnes foreløpig ikke dokumentasjon i kildematerialet som viser hvordan Woof håndterer norsk uttale, dialekter, navn eller setningsmelodi. Underdogs demo lar brukeren skrive tekst, men en demonstrasjon av engelsk tale er ikke en norsk kvalitetstest. Jeg har heller ikke lyttetestet modellen selv.
En språkoppføring ville uansett ikke vært nok. For å si noe fornuftig om norsk tale må riktig modell vurderes på norske setninger, tall, forkortelser, sammensatte ord og gjerne flere dialektnære uttaler. Helst bør dette gjøres med menneskelige lyttere, ikke bare en automatisk transkripsjon som sjekker om ordene kan gjenkjennes.
Det er derfor for tidlig å anbefale Woof som norsk stemmemotor. Den riktige dommen nå er at størrelsen og den lokale nettleserkjøringen er imponerende, mens språk- og stemmekvaliteten fortsatt er utilstrekkelig dokumentert. Manglende norsk test er ikke et negativt funn. Det er bare en grense for hva kildene faktisk lar meg påstå.
Den samme nøkternheten gjelder generell kvalitet. En stemme kan være forståelig i korte setninger og samtidig få problemer med lange avsnitt, pauser, følelser eller uvanlige navn. Før Woof får uavhengige lyttetester og en tydelig språkoversikt, bør demoen leses som et bevis på effektiv lokal kjøring – ikke som en seier i alle andre kategorier.
Hvordan passer Woof inn i Underdogs lokale AI-satsing?
Woof står ikke alene. Noen uker tidligere ga Underdog ut Bark 3.0, en tale-til-tekst-modell for lokal transkripsjon. Det offisielle modellkortet oppgir en nedlasting på 163 MB og beskriver modellen som en engelsk talegjenkjenner bygget for blant annet møter og diktering.
Sammen dekker Bark og Woof hver sin retning: Bark gjør lyd om til tekst, mens Woof gjør tekst om til lyd. Det er byggesteiner for en lokal taleassistent som både kan høre og svare uten at hele samtalen sendes til skyen. Nettopp den kombinasjonen er mer interessant enn et enkelt artig retrospill.
Underdog har også større språkmodeller og en ventelistet app. Grunnideen er den samme: mer AI skal kjøre på maskinene folk allerede eier. Det ligner retningen jeg beskrev i saken om audio.cpp og lokal lyd-AI uten Python. Når modell, kjøremiljø og grensesnitt kan pakkes sammen, blir lokal AI tilgjengelig for flere enn dem som liker å slåss med avhengigheter i terminalen.
Woof viser dessuten at nettleseren kan bli et leveringsmiljø for lokale modeller, ikke bare et vindu inn til en skytjeneste. WebGPU gjør det mulig å bruke GPU-en fra nettsiden, mens selve modellen kan lastes ned som en vanlig ressurs. Det kan gjøre distribusjon mye enklere, men utviklere må fortsatt håndtere nettleserstøtte, minne, nedlastingstid og lisens.
Min vurdering av Woof
Jeg liker dette. Ikke fordi en retrodemo med en ond sky er et ferdig produkt, men fordi Underdog har gjort modellens viktigste egenskap synlig: Woof er så liten at vanlig talegenerering kan flyttes inn i nettleseren og bli værende på brukerens maskin.
31,7 MB og 30,7 millioner parametere er de sterke tallene. Den oppgitte farten på 18 ganger sanntid er også lovende, men trenger en reproduserbar test. Samtidig trekker den ikke-kommersielle lisensen ned den umiddelbare nytten for bedrifter, og manglende dokumentasjon av språk og stemmekvalitet gjør at ingen bør lese demoen som en ferdig seier over større TTS-systemer.
Det er likevel lett å se hvor dette går. Lokal tale trenger ikke være en tung spesialløsning eller en API-regning som tikker for hver setning. Den kan bli en liten komponent som følger med programmet, fungerer uten nett og holder teksten på enheten. Woof er ikke hele svaret ennå. Men 31,7 MB er et ganske tydelig hint.
Ofte stilte spørsmål
Kan Woof kjøre uten internett?
Ja, ifølge Underdog kjører Woof lokalt i nettleseren og kan fortsette uten internett etter at nødvendige filer er lastet inn. Demoen bruker WebGPU på brukerens egen maskin. Nettleser- og maskinvarestøtten er likevel ikke dokumentert i en komplett kompatibilitetsliste.
Lager Woof både tale og musikk?
Nei, Woof er modellen for tekst-til-tale. Escape-demoen inneholder også lokalt generert musikk, men Underdog sier at stemmer og sanger ble laget av lokale modeller i flertall. Musikktallene skal derfor ikke brukes som mål på Woofs egenskaper eller fart.
Kan Woof brukes gratis i en kommersiell app?
Ikke ut fra den oppgitte CC BY-NC 4.0-lisensen. Den tillater ikke-kommersiell deling og bearbeiding med kreditering, men kommersiell bruk krever andre rettigheter eller en separat avtale. Bedrifter bør avklare lisensen før de bygger modellen inn i et produkt.
Fungerer Woof godt på norsk?
Det vet vi ikke ennå. Kildene dokumenterer verken norsk språkstøtte eller lyttetester av uttale, dialekter og setningsmelodi for denne modellen. Jeg har ikke testet Woof selv, så det ville vært feil å gi en positiv eller negativ norsk kvalitetsdom.