Innhold Vis
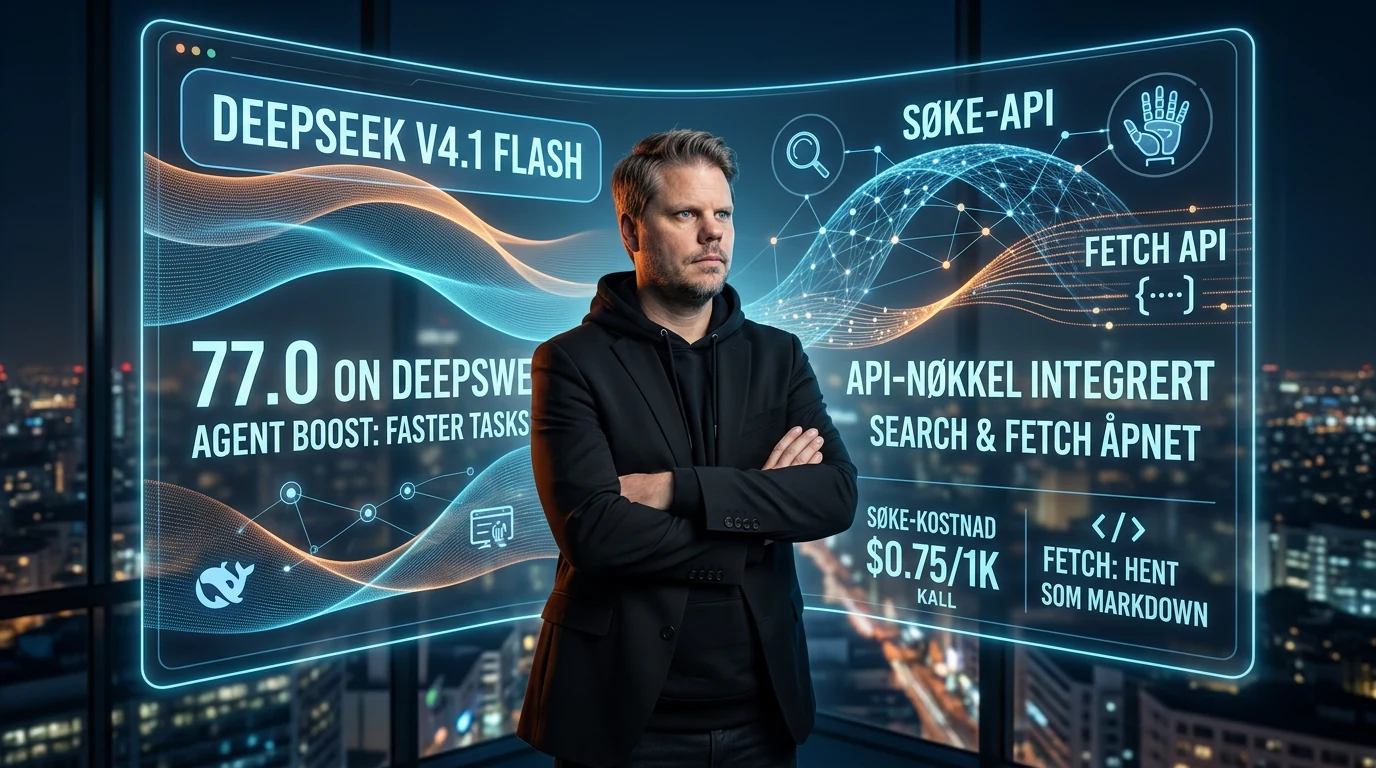
Hvis du bruker DeepSeek til kodeagenter, ble modellen bak deepseek-flash oppgradert 17. oktober uten at du trenger å endre API-koden. DeepSeek-V4.1-Flash-1017 beholder samme pris og skal fullføre oppgaver raskere med kortere svar enn septemberutgaven.
Samtidig åpner DeepSeek søkemotoren sin for utviklere. De nye Search- og Fetch-API-ene kan finne nettsider og hente innhold som Markdown, uavhengig av selve språkmodellen. For alle som bygger agenter eller RAG-løsninger, er dette minst like praktisk som enda en pen benchmark-tabell.
Jeg er skeptisk til å kåre en ny standardmodell på grunnlag av leverandørens egne tall. Men kombinasjonen er verdt å følge: et oppgitt løft i DeepSeeks testoppsett, én million tokens kontekst, uendret lav pris og en førsteparts web-løsning bak samme API-nøkkel.
Hva er nytt i DeepSeek V4.1 Flash 1017?
DeepSeek V4.1 Flash 1017 er et nytt checkpoint av modellen som ble lansert 10. september 2026. Den erstatter den forrige utgaven på nett, i appen og i API-et. Ifølge DeepSeeks endringslogg fra 17. oktober er kallmetoden og prisen uendret, og modellnavnet er fortsatt deepseek-flash. Det er et nytt kapittel etter agentoppgraderingen av DeepSeek V4 Flash i juli, ikke en ny omtale av den samme hendelsen.
Dette er altså en oppgradering du kan få uten å bytte modell-ID eller bygge om integrasjonen. DeepSeek sier at ny post-training med reinforcement learning og self-feedback har gjort modellen bedre til å gjennomføre hele prosjekter. Selskapet trekker fram oppgaver som koding, spillutvikling og 3D-modellering, og anbefaler DeepSeek Harness 0.2.1-rc.1 eller nyere.
Den underliggende V4.1 Flash-modellen har én million tokens kontekst og en oppgitt maksimal utdata på 384 000 tokens. Den støtter både tenkemodus og vanlig modus, bilder inn, verktøykall, Responses API og Anthropic-formatet. Jeg har tidligere skrevet om hva millionkonteksten og den komprimerte KV-cachen betyr i V4.1 Flash.

Hvor mye bedre er den nye modellen?
DeepSeek rapporterer forbedringer på alle de 11 benchmarkene selskapet har publisert for 1017-utgaven. DeepSWE v1.1 går fra 74,2 til 77,0, mens Terminal-Bench 4.0 går fra 31,2 til 42,3. Automation-Bench øker fra 54,8 til 60,5, og Apex Bench fra 64,6 til 72,1.
Det mest interessante er likevel påstanden om mindre arbeid per løst oppgave. DeepSeek sier at 1017 bruker kortere tid og produserer kortere svar enn forrige V4.1-utgave. Hvis modellen faktisk trenger færre tokens og færre agentrunder for å bli ferdig, kan den effektive kostnaden falle selv om prislisten står stille.
Men selskapet publiserer ikke konkrete tall for hvor mye kjøretiden eller svarlengden er redusert. Benchmarkene er dessuten kjørt i bestemte agentrammer: Terminal-Bench 4.0 med Claude Code og DeepSWE med Mini-SWE-V2. De viser hvordan modellen gjorde det i DeepSeeks oppsett, ikke automatisk hvordan den vil fungere i din kodebase.
MarkTechPost sammenligner 77,0 på DeepSWE med 74,0 for Claude Opus 5 i DeepSeeks tabell. Det høres voldsomt ut, men samme tabell viser også at Opus leder klart på blant annet Terminal-Bench 4.0, ProgramBench, NL2Repo og HLE. Det finnes ingen ærlig grunn til å gjøre én seier om til en generell kåring.
Hvorfor er kortere svar viktigere enn det høres ut?
Kortere svar kan gi lavere kostnad, raskere agentløp og mindre støy i konteksten. En coding agent som bruker 20 verktøyrunder på en oppgave, betaler ikke bare for sluttsvaret. Den betaler for planlegging, terminalutdata, nye vurderinger og tekst som sendes inn igjen i neste runde.
Derfor er pris per million tokens bare halve regnestykket. En billig modell som skriver seg bort, gjentar analysen og trenger flere forsøk, kan bli dyrere enn en modell med høyere listepris som løser jobben på første runde. DeepSeeks påstand om en bedre kombinasjon av ytelse og kostnad er plausibel, men den må måles på hele oppgaver.
Det er også her 1017 bør testes mot septemberutgaven. Bruk samme oppgave, samme systemprompt, samme verktøy og samme tidsgrense. Mål om testene passerer, hvor mange korrigeringer agenten trenger, samlet tokenbruk, kjøretid og pris. Benchmark-poeng kan peke ut kandidaten. De kan ikke gjøre den vurderingen for deg.
Hva gjør de nye Search- og Fetch-API-ene?
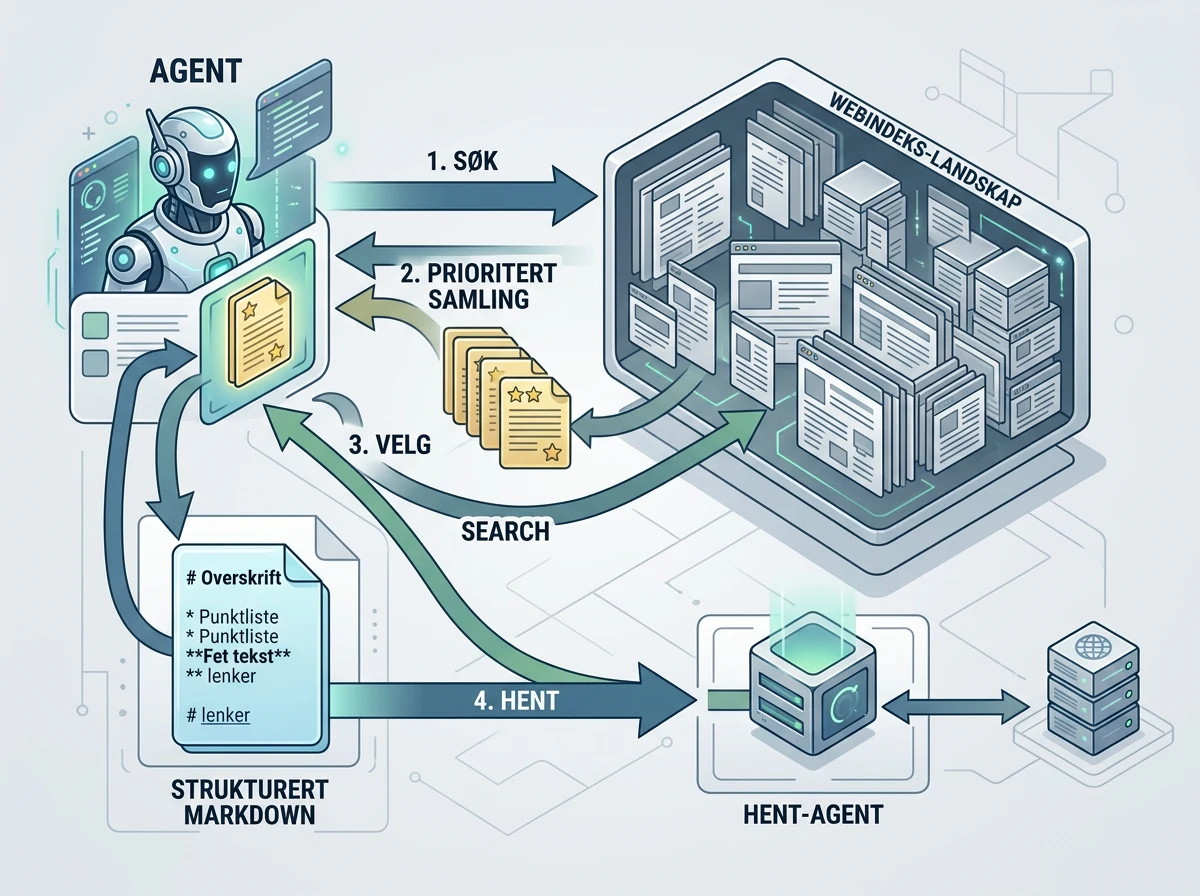
Search finner nettsider og returnerer strukturerte søkeresultater, mens Fetch henter én bestemt nettside og leverer innholdet som Markdown. De bruker samme bearer-autentisering som resten av DeepSeek API. Den offisielle Search og Fetch-guiden oppgir endepunktene POST /v1/tools/search og POST /v1/tools/fetch.
Search kan returnere mellom 1 og 50 treff. Du kan be om selve sideinnholdet sammen med resultatet og bruke operatorer som site:, lang:, after: og before:. Hvert treff får blant annet en relevansscore fra 0 til 3 og et autoritetsnivå fra 0 til 4. DeepSeek oppgir at søkemotoren indekserer hundrevis av milliarder nettsider og håndterer hundrevis av millioner søk daglig.
Fetch er enklere: Du sender inn en nettadresse og får tittel og Markdown tilbake. Det gjør API-et egnet når en agent først søker etter kilder og deretter henter de mest relevante sidene til analyse. Begge API-ene er skrivebeskyttet, men Fetch følger naturligvis nettstedets tilgjengelighet og tilgangsregler.
Dette er ikke automatisk det samme som at modellen har fersk og korrekt kunnskap. Agenten må fortsatt velge gode kilder, skille primærkilder fra omtale, håndtere motstridende opplysninger og sitere det den faktisk bygger på. Et søkeresultat med høy autoritetsscore er et signal fra DeepSeeks system, ikke en sannhetsgaranti.
Hva koster DeepSeek Search og Fetch?
Search og Fetch koster hver 0,75 dollar per 1 000 vellykkede forespørsler. Med Norges Banks siste publiserte dollarkurs på omtrent 9,44 kroner 16. oktober tilsvarer det cirka 7,10 kroner per 1 000 kall, eller rundt 0,7 øre per kall. En arbeidsflyt med ett søk og ett Fetch-kall per oppgave blir omtrent 14,20 kroner per 1 000 oppgaver før modellkostnaden.
DeepSeek fakturerer bare når Search returnerer minst ett treff, eller når Fetch faktisk returnerer sideinnhold. Feil, tidsavbrudd og tomme søkeresultater skal ikke belastes. Antallet resultater du ber Search om, endrer heller ikke prisen per forespørsel. Grensen er fem forespørsler per sekund for hvert av de to API-ene.
Serverbaserte Search- og Fetch-kall gjennom DeepSeek Harness, Claude Code og Codex er gratis fram til 1. november 2026. Etter det starter vanlig fakturering. Dette er en kort introduksjonsperiode, så en produksjonsløsning bør regne inn den ordinære prisen fra starten.
Prismodellen er enkel, men pass på agentløkkene. En agent som søker på nytt etter hver lille usikkerhet kan fort bruke mange kall på én oppgave. Sett grenser for antall søk og hentinger, logg hva verktøyet gjør, og bruk cache der det er naturlig.
Hva koster selve DeepSeek V4.1 Flash 1017?
DeepSeek V4.1 Flash 1017 beholder samme tokenpriser som septemberutgaven. I høylastperiodene koster én million input-tokens uten cache-treff 0,30 dollar, cirka 2,83 kroner, mens én million output-tokens koster 1,20 dollar, cirka 11,33 kroner. Utenfor høylastperiodene er begge prisene halvert.
Cache-treff er enda billigere: 0,003 dollar per million input-tokens utenfor høylast og 0,006 dollar i høylast. Det er omtrent 2,8 og 5,7 øre. DeepSeeks offisielle pristabell oppgir høylastperiodene som 01.00-04.00 og 06.00-10.00 UTC på hverdager, bortsett fra kinesiske helligdager.
Dette er svært lave listepriser for en modell med millionkontekst og agentfunksjoner. Men igjen: Den virkelige prisen er hva en ferdig oppgave koster. Bruker modellen ti ganger så mange tokens eller må rette sitt eget arbeid flere ganger, hjelper det lite at hvert token var billig.
Jeg skrev tidligere om prisene og agentfunksjonene i DeepSeek V4 Pro. Flash er fortsatt det naturlige valget når volum og kostnad betyr mest, mens Pro er den dyrere modellen for de tyngre oppgavene. 1017-oppgraderingen gjør den forskjellen enda mer interessant.
Er modellvektene til 1017-utgaven åpne?
Det er ikke tydelig dokumentert at de nye 1017-vektene er publisert. De offisielle modellfilene som ligger ute på Hugging Face, gjelder DeepSeek V4.1 Flash-utgaven fra september og har MIT-lisens. DeepSeeks kunngjøring for 1017 beskriver oppgraderingen på nett, i app og i API-et, men lenker ikke til et eget sett med nye vekter.
Det betyr at du ikke bør omtale 1017 som en ny åpen lokalmodell før DeepSeek faktisk publiserer og identifiserer checkpointet. API-modellen og septembervektene er nært beslektet, men det er ikke det samme som at du kan laste ned nøyaktig den versjonen som nå serveres som deepseek-flash.
Dette skillet betyr mye for reproduksjon. En lokal test av septembervektene kan si noe om arkitekturen og den forrige modellen, men den dokumenterer ikke forbedringene DeepSeek hevder for 1017. Foreløpig er den sikreste beskrivelsen at det nye checkpointet er tilgjengelig gjennom DeepSeeks egne tjenester.
Bør du bytte coding agent til DeepSeek nå?
Hvis du allerede bruker deepseek-flash, er byttet i praksis gjort for deg. Det viktige er å kontrollere om oppgavene dine oppfører seg annerledes etter oppgraderingen. Et checkpoint kan bli bedre totalt og samtidig endre stil, verktøybruk eller beslutninger på måter som påvirker en etablert arbeidsflyt.
Hvis du vurderer DeepSeek for første gang, er prisen god nok til at en avgrenset sammenligning er fornuftig. Velg noen ekte oppgaver, fjern sensitive data og kjør samme oppsett mot modellen du bruker i dag. Ikke gi den full tilgang til kundekode eller produksjonsmiljø bare fordi 77,0 ser pent ut i en tabell.
For sensitivt arbeid bør du vurdere datahåndtering, jurisdiksjon og leverandøravhengighet før modellen får tilgang til kundekode eller produksjonsdata. For ufølsomme arbeidslaster, åpne prosjekter og kontrollerte eksperimenter er det likevel vanskelig å avfeie hva DeepSeek tilbyr per krone.
1017 er ikke dokumentert som en revolusjon. Det er en målrettet oppgradering som kan gjøre en allerede billig agentmodell raskere og mer effektiv, uten at integrasjonen endres. Search og Fetch gjør samtidig DeepSeek mer til en komplett agentplattform enn bare enda en modellleverandør. Det er den kombinasjonen som gjør lanseringen interessant.
Ofte stilte spørsmål
Må eksisterende API-brukere endre modellnavnet?
Nei. Modellnavnet er fortsatt deepseek-flash, og DeepSeek opplyser at kallmetoden er uendret. Nettstedet, appen og API-et er oppgradert til DeepSeek-V4.1-Flash-1017 automatisk.
Er DeepSeek Search gratis i Codex?
Serverbaserte søk gjennom Codex, Claude Code og DeepSeek Harness er gratis fram til 1. november 2026. Deretter gjelder ordinær pris. DeepSeek oppgir 0,75 dollar, cirka 7,10 kroner, per 1 000 vellykkede Search-kall.
Kan Search API returnere hele nettsiden?
Search kan valgfritt returnere sideinnhold sammen med inntil 50 strukturerte treff. For å hente én bestemt side som Markdown finnes det separate Fetch API-et. Begge bruker samme DeepSeek API-nøkkel.
Beviser 77,0 på DeepSWE at modellen er best til koding?
Nei. Tallet kommer fra DeepSeeks eget testoppsett med Mini-SWE-V2. Modellen leder den oppgitte DeepSWE-tabellen, men ligger bak Claude Opus 5 på flere andre tester. Ekte oppgaver, samlet kostnad og nødvendig oppfølging avgjør hva som fungerer best.