
Innhold Vis
Hvis du håpet å åpne Gemini 4 Carbon i dag og slippe den løs på egen kode, må du vente. Googles nye frontiermodell er først tilgjengelig for en liten gruppe cyberforsvarere. Til gjengjeld er dette en langt mer interessant lansering enn enda en modell som bare lover litt bedre svar i en chatbot.
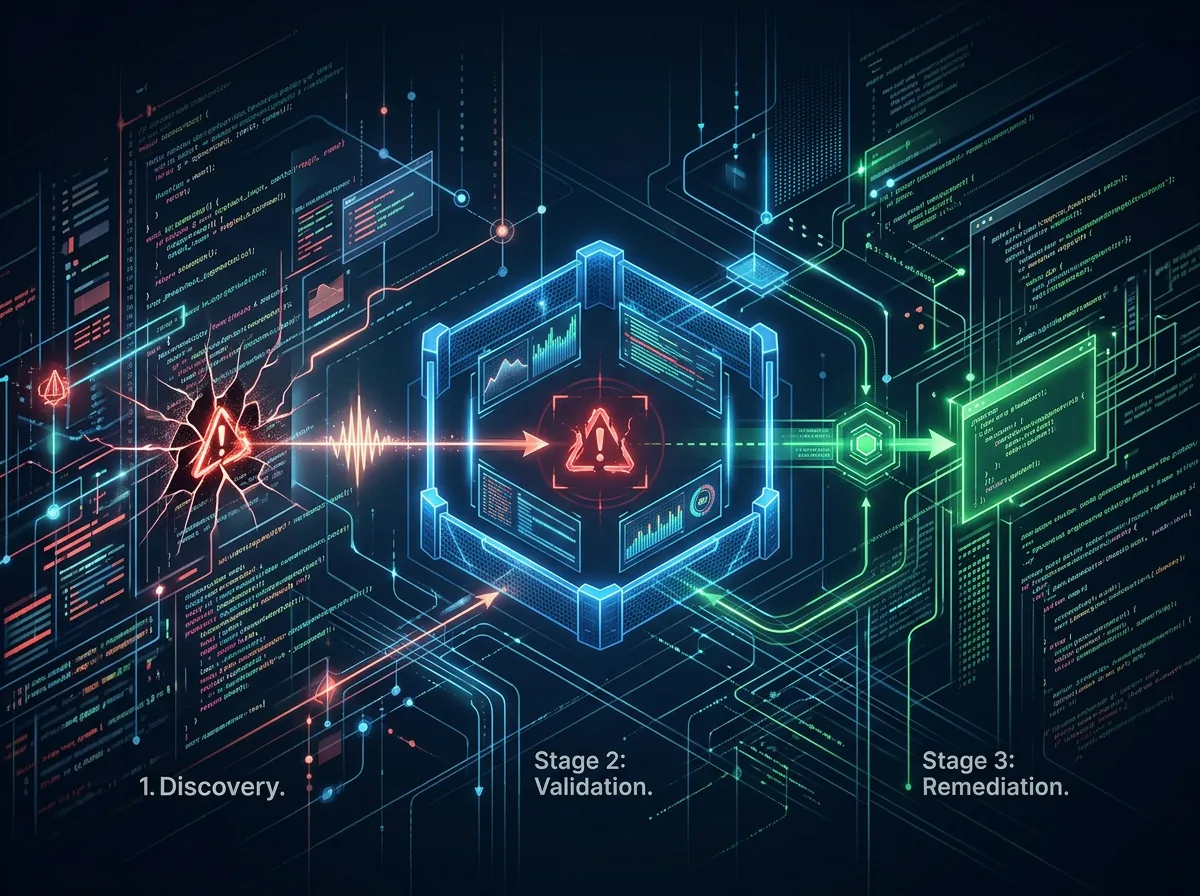
Carbon er laget for lange, agentiske arbeidsløp og for hele kjeden i cyberforsvar: finne en sårbarhet, undersøke om den faktisk kan utnyttes og lage en fungerende rettelse. Google lanserte modellen 28. oktober 2026, bare to uker etter Gemini 4 Argon.
Min vurdering er nøkternt positiv. Resultatene ser sterke ut, og begrenset tilgang er forståelig når samme evner kan brukes både til forsvar og angrep. Men Google viser hovedsakelig fram egne målinger, utvalgte tester og erfaringer fra egne team. Dette er lovende dokumentasjon – ikke en invitasjon til å behandle Carbon som en ferdig bevist sikkerhetskollega.
Hva er Gemini 4 Carbon?
Gemini 4 Carbon er Googles nyeste frontiermodell for krevende koding, langvarige agentoppgaver og cybersikkerhet. Modellen bygger videre på Gemini 4 Argon, som kom 13. oktober 2026, men Carbon får en langt tydeligere rolle som arbeidsverktøy for cyberforsvarere.
Google sier at interne team har latt Carbon arbeide i flere dager med kompliserte oppgaver. Det omfatter å spore årsaken til vanskelige feil i store kodebaser, navigere rundt blindveier og lage rettelser i lavnivåsystemer. Det er denne utholdenheten som er interessant. En sikkerhetsagent som gir opp etter første mislykkede verktøykall er ikke mye til agent.
Carbon er også en generell modell. Google trekker fram forbedringer i fullstack-utvikling, multimodal forståelse, vitenskapelige oppgaver og vanlig agentisk arbeid. Likevel er cyberdelen den klare grunnen til at modellen finnes som en egen lansering, og den forklarer hvorfor utrullingen starter så forsiktig.
Hva gjør Carbon annerledes i cyberforsvar?
Det viktigste er at Carbon dekker mer enn sårbarhetsskanning. Modellen skal kunne finne reelle feil i kode, bevise om de lar seg utnytte og deretter rette selve årsaken. Det er tre ulike oppgaver, og en lang liste med mulige sårbarheter har liten verdi hvis ingen kan skille de farlige funnene fra støyen eller få en trygg patch ut i produksjon.
På eksterne tester oppgir Google 88,2 prosent på SEC-bench Pro for å finne sårbarheter, 54,8 prosent på ExploitGym for å validere dem gjennom utnyttelse og 71,0 prosent på CWE-bench for å lage rettelser. Evalueringene ble kjørt uten sikkerhetsmekanismene som følger den utrullede modellen. Tallene beskriver dermed rå kapasitet, ikke nøyaktig hva en vanlig bruker vil få tilgang til.
Google sier også at Carbon mer enn doblet treffraten for sikker kode sammenlignet med Argon i interne tester. Chrome-teamet skal ha fått over ti ganger bedre resultater på gode patcher enn med en ikke navngitt frontiermodell fra et annet selskap. Det siste høres imponerende ut, men uten navn på konkurrenten, testoppsett og full metode er det først og fremst et leverandørutsagn.
Det er likevel retningen som betyr mest. Cyberforsvar har lenge vært fullt av verktøy som finner mer enn mennesker rekker å behandle. En modell som både kan prioritere, validere og rette kan redusere tiden fra funn til faktisk beskyttelse. Hvis den virker like godt på rotete bedriftskode som i testene, er det et reelt sprang.
Hvor mye kan vi stole på resultatene?
Ikke nok til å kjøpe champagne på benchmark alene. Artificial Analysis plasserer Carbon øverst på sin Intelligence Index v5 med 59 poeng, men presiserer samtidig at modellen ikke leder på alle områder. På deres egen Coding Agent Index ligger Claude Opus 5.5 fortsatt foran.
Det er et nyttig korrektiv til overskriften om at Carbon er nummer én. En samlet indeks blander flere typer oppgaver til ett tall. Den sier lite om hvor godt modellen håndterer akkurat din kodebase, dine interne verktøy, dårlige logger, ufullstendige krav og en CI-pipeline som helst velger fredag ettermiddag for å falle fra hverandre.
De sterkeste opplysningene er derfor ikke plasseringen på en generell resultatliste, men at modellen prøver å løse en hel operativ kjede og at eksterne cybertester måler tre forskjellige ledd. Like viktig er det å vite hva som mangler: Ved lansering finnes det ingen offentlig Carbon-modellside i Gemini API-dokumentasjonen, ingen bred tilgang og ingen offentlig erfaring fra vanlige utviklerteam.
Hvorfor er tilgangen begrenset?
Carbon rulles først ut til en undergruppe av cyberforsvarere gjennom Googles Fairwind-program. Google sier at modellen samtidig går gjennom en frivillig amerikansk prosess for testing før lansering. Flere betrodde partnere skal få tilgang gradvis, mens utviklere, bedrifter og forbrukere må vente.
Dette følger samme mønster som Google brukte da Fairwind ga forsvarere tidlig tilgang til Gemini 3.8. Tanken er å gi dem et forsprang før sterke offensive evner blir bredt tilgjengelige. Carbon kan ikke bare finne en sårbarhet. Den målte også 54,8 prosent på en test der oppgaven er å utnytte den. Da er en trinnvis åpning mer enn vanlig knapphet rundt en ny modell.
Begrensningen betyr også at de fleste påstandene foreløpig er vanskelige å etterprøve i vanlig arbeid. Vi vet ikke hvordan Carbon oppfører seg med organisasjonsspesifikke regler, enorme monorepoer, uferdige integrasjoner eller sikkerhetsverktøy som returnerer motstridende funn. En lukket forhåndslansering kan gi gode svar på dette, men svarene er ikke offentlige ennå.
Har Google løst problemet med agentfeil?
Nei, men selskapet hevder å ha redusert flere av de mest irriterende feiltypene. I Googles interne testing falt alvorlige varsler om feiljustert atferd med nesten 80 prosent sammenlignet med Argon. Modellen skal også ha halvert antallet udokumenterte påstander, redusert overtramp med 26 prosent og samtidig redusert tilfeller der den gjorde for lite med 29 prosent.
Google rapporterer dessuten 0,0 prosent vellykkede indirekte prompt injection-angrep i Gray Swans test, mot 0,7 prosent for Argon. Det er et godt resultat i den konkrete evalueringen. Det betyr ikke at prompt injection er løst. Null treff i én test er ikke det samme som null risiko når modellen møter nye nettsider, dokumenter, verktøy og angripere.
Jeg liker likevel at Google måler mer enn om modellen klarer å fullføre oppgaven. En agent kan være teknisk dyktig og fortsatt være elendig å gi ansvar. Den kan gjette når grunnlaget mangler, skjule at et verktøy feilet eller fortsette langt utenfor oppgaven. Carbon skal oftere vise sprik i kildene, forklare hva som mangler og stoppe når en handling er blokkert. Det er egenskaper som betyr noe i faktisk agentarbeid.
Hva vil Gemini 4 Carbon koste?
Google oppgir en introduksjonspris på 2 dollar per million input-token og 10 dollar per million output-token. Med Norges Banks kurs 28. oktober 2026 er det cirka 19 kroner for input og 93 kroner for output. Bufret input skal koste 95 prosent mindre.
Etter introduksjonsperioden øker prisene til 4 dollar og 20 dollar per million token, omtrent 37 og 186 kroner med samme kurs. Google har ikke oppgitt en egen sluttdato for Carbon-rabatten i lanseringen. Og siden modellen ennå ikke er åpen i Gemini API, er dette en pris for den kommende brede tilgangen – ikke noe vanlige utviklere kan kjøpe i dag.
Tokenprisen sier dessuten lite om hva en langvarig cyberagent faktisk vil koste. Hvis Carbon arbeider i flere dager, leser store kodebaser, bruker verktøy og lager mange mellomresultater, kan totalforbruket bli betydelig. Mål derfor kostnad per validert funn eller godkjent patch når tilgangen kommer. Pris per million token er regnearket. Ferdig arbeid er virkeligheten.
Hva bør utviklere og bedrifter gjøre nå?
Vanlige utviklere trenger ikke endre noe i dag. Det finnes ingen offentlig modell-ID å migrere til, og Google har ikke lagt fram en dato for bred tilgang. Følg med på offisiell Gemini API-dokumentasjon, prisvilkår og et eventuelt modellkort før du planlegger Carbon inn i produksjon.
Sikkerhetsteam kan bruke ventetiden bedre. Finn arbeidsløp der en agent kan gi målbar verdi uten å få frie tøyler: prioritering av skannerfunn, reproduksjon i isolerte miljøer, forslag til patcher og verifisering gjennom tester. Sett krav til sporbarhet, menneskelig godkjenning og klare grenser for hvilke systemer og hemmeligheter agenten kan nå.
Når Carbon blir tilgjengelig, bør den måles mot dagens prosess og ikke mot en blank chatbot. Hvor mange reelle sårbarheter finner den? Hvor mange falske alarmer skaper den? Består patchene testene, og introduserer de nye feil? Hvor ofte trenger et menneske å rydde opp? Det er svarene som avgjør om Carbon er et sprang eller bare en svært pen resultatgraf.
Min vurdering av Gemini 4 Carbon
Gemini 4 Carbon ser ut som en av de mer målrettede frontierlanseringene i år. Google har ikke bare lagt på et høyere modellnummer og vist en generell poengsum. Carbon retter seg mot et konkret problem: å få en agent fra sårbarhetsfunn til validert risiko og videre til fungerende rettelse.
Det kan bli svært nyttig. Det kan også bli farlig hvis de samme evnene havner i feil hender eller hvis bedrifter kobler modellen til kritiske systemer før kontrollene er gode nok. Derfor er den begrensede utrullingen en del av selve produktet akkurat nå, ikke en fotnote.
Jeg kjøper ikke «nummer én» som en ferdig dom. Jeg kjøper at Google har vist nok konkrete resultater til at Carbon fortjener oppmerksomhet. Den virkelige prøven kommer først når eksterne utviklere og sikkerhetsteam får bruke modellen på rotete, levende systemer – med alle de kjedelige detaljene en benchmark slipper å møte.
Ofte stilte spørsmål
Er Gemini 4 Carbon tilgjengelig i Norge?
Nei, ikke for vanlige brukere eller utviklere. Google gir først tilgang til en liten gruppe cyberforsvarere gjennom Fairwind-programmet. Selskapet sier at Carbon senere skal komme til utviklere, bedrifter og forbrukere, men har ikke oppgitt en dato for bred tilgang.
Kan Gemini 4 Carbon brukes gjennom Gemini API?
Ikke gjennom en offentlig modell-ID ved lansering 28. oktober 2026. Google har oppgitt kommende API-priser, men Carbon står foreløpig ikke i den offentlige modelloversikten. Vent på offisiell dokumentasjon før du planlegger en integrasjon eller migrering.
Er Gemini 4 Carbon bedre enn Claude Opus 5.5 og GPT-6 Astra?
Carbon leder Artificial Analysis Intelligence Index v5 samlet, men leder ikke alle delområder. Claude Opus 5.5 ligger blant annet foran på deres Coding Agent Index. Hvilken modell som er best avhenger av oppgaven, og cyberresultatene må fortsatt bekreftes i vanlig produksjonsarbeid.
Er Gemini 4 Carbon en offensiv hackermodell?
Google presenterer Carbon som en modell for cyberforsvar, men den kan også validere sårbarheter gjennom utnyttelse i kontrollerte tester. Nettopp denne dobbeltsidige kapasiteten er grunnen til at tilgangen starter hos utvalgte forsvarere med sikkerhetsmekanismer og gradvis utrulling.