Innhold Vis
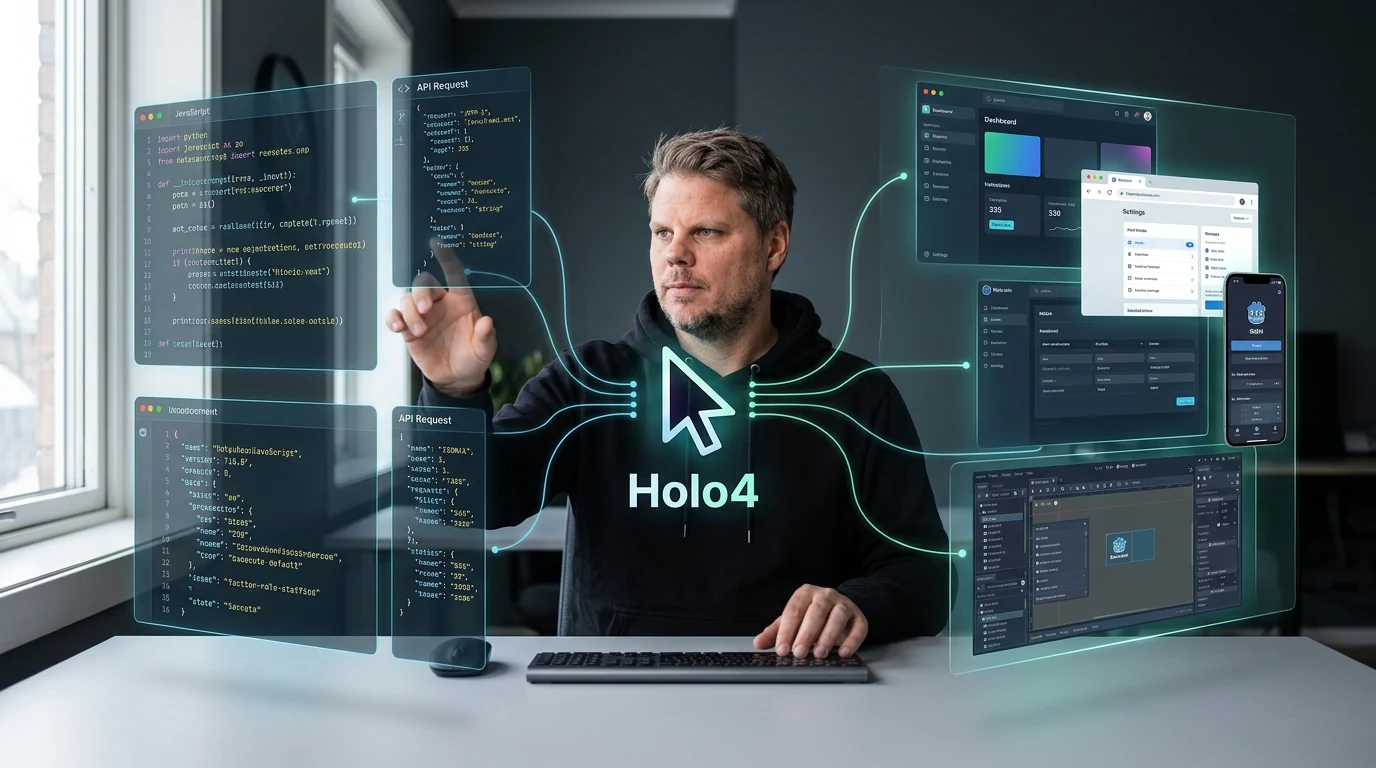
Holo4 er en modellfamilie for AI-agenter som må bruke skjerm, kode, MCP og API-er i samme arbeidsflyt. Det er den viktige nyheten. H Company prøver ikke bare å lage en modell som finner riktig knapp i et skjermbilde, men en generalist som kan velge grensesnitt etter oppgaven og holde det gående gjennom hundrevis av steg.
Det treffer et helt reelt problem. En ren GUI-agent blir hjelpeløs når informasjonen må hentes fra et API. En modell som foretrekker verktøykall, stopper når programmet ikke har et brukbart API. Virkelig arbeid er som regel en blanding: Les noe på skjermen, hent data gjennom et verktøy, kjør litt kode og gå tilbake til programmet for å kontrollere resultatet.
Holo4 ser derfor langt mer nyttig ut enn enda en imponerende musepeker. Men jeg kjøper ikke «selvstendig medarbeider» bare fordi en leverandør viser gode benchmark-tall. H Company har publisert både modellvekter og kjørelogger, og det er bra. Det er nettopp de faktiske handlingsforløpene, feilene og behovet for hjelp som avgjør om dette er en agent du kan stole på.
Hva er Holo4?
Holo4 er en familie med multimodale modeller for computer use. H Company lanserte familien 28. september 2026 med to hovedmodeller: en tett modell på 27 milliarder parametere og en Mixture of Experts-modell på 35 milliarder parametere, hvor omtrent 3 milliarder er aktive per kjøring.
Begge modellene tar inn skjermbilder og verktøyresultater, vurderer neste steg og ber et eget agentoppsett utføre klikk, tastetrykk, kode eller verktøykall. Modellen styrer altså ikke datamaskinen alene. Den inngår i en løkke der oppsettet utfører handlingen, sender resultatet tilbake og lar modellen planlegge videre.
Den samme modellen skal kunne arbeide på web, desktop, Android, i en kode-sandbox og mot forretnings-API-er. Du skal ikke måtte bytte modell fordi oppgaven går fra en nettside til et regneark eller fra et visuelt program til en MCP-server. Det er dette «generalist» betyr her: Flere grensesnitt og miljøer i én handlingsmodell, ikke at den automatisk er best på alt.
Holo4-27B bygger på Qwen3.8 med en tett arkitektur. Holo4-35B-A3B bygger på Qwen3.5 MoE. Begge modellkortene oppgir en maksimal kontekstlengde på 262 144 tokens, noe som er relevant når agenten må holde orden på lange kjøringer med mange skjermbilder, verktøysvar og tidligere beslutninger.
Hvorfor er kombinasjonen av GUI og verktøy viktig?
Den praktiske gevinsten er at agenten kan bruke den korteste veien til målet. Et API er ofte raskere og mer presist enn å klikke seg gjennom fem menyer. Samtidig finnes det fortsatt mengder av programvare, interne systemer og særbygde arbeidsflyter der skjermen er det eneste realistiske grensesnittet.
Holo4 kan etter planen veksle mellom disse. Den kan lese tilstanden i et program, skrive og kjøre kode, kalle et MCP-verktøy og kontrollere sluttresultatet visuelt. H Company viser blant annet oppgaver i FreeCAD og Godot, ikke bare korte nettoppgaver med en tydelig knapp og et fasitsvar.
I Pac-Man-eksemplet fikk Holo4-27B i oppgave å bygge et selvspillende spill i Godot. Selskapet oppgir at agenten brukte 68 verktøykall, 2,4 millioner tokens og skrev 268 linjer. Basismodellen Qwen3.8 27B brukte til sammenligning 197 kall og 11,4 millioner tokens i samme oppsett. Det er et interessant signal om arbeidsflyt og effektivitet, men fortsatt en leverandørdemonstrasjon – ikke en garanti for hvordan modellen løser din oppgave.

Dette er også en mer fornuftig retning enn å tvinge alle oppgaver gjennom skjermen. GUI-automatisering er tregt, dyrt og sårbart for små endringer i layouten. Når agenten kan bruke kode eller et strukturert verktøy der det finnes, og bare ty til skjermen når den må, kan den spare både tid og feil.
Hva viser testene – og hva viser de ikke?
På OSWorld 2.0 oppgir H Company en gjennomsnittlig delscore på 61,7 prosent for Holo4-27B. I selskapets sammenligning ligger den bak Claude Opus 5.5, mens Holo4-35B-A3B gjør det klart svakere. Det er godt nok til at 27B-modellen er verdt å undersøke, men ikke et bevis på pålitelig autonomi.
Her må vi være litt våkne. Modellkortet til Holo4-27B sier uttrykkelig at lanseringer, agentoppsett, oppgavesett og målemetoder varierer mellom modellene i kostnadsdiagrammet. AutomationBench-tallene blander dessuten selskapets egne kjøringer på det offentlige oppgavesettet med andre modellers resultater på et privat sett. Dette er ikke en ren tabell der alle stilte til start under like forhold.
Det mest troverdige grepet i lanseringen er derfor ikke selve topplinjen, men at H Company publiserer kjøreloggene bak de offentlige benchmark-resultatene. Trajectory-datasettet på Hugging Face gjør det mulig å se handlingene steg for steg, laste dem ned og undersøke hvor agenten brukte unødvendige omveier eller fikk hjelp av oppsettet.
Det er sånn slike agentpåstander bør kontrolleres. En sluttscore forteller at noe ble oppnådd. Handlingsforløpet forteller om agenten arbeidet fornuftig, gjorde farlige antakelser, brukte ti ganger flere steg enn nødvendig eller traff målet mer ved flaks enn ved kontroll.
Jeg har allerede vært tydelig på at sterke modellnavn og agentiske superkrefter ikke er det samme som stabilt, selvstendig arbeid. Det samme spørsmålet gjelder når de største modellene får nye agentfunksjoner: Kan de fullføre kjedelige, lange arbeidsløp pålitelig, også når noe uventet skjer? Holo4 må vurderes etter samme målestokk.
Hvordan ble Holo4 trent for lange arbeidsflyter?
H Company sier modellen er finjustert med veiledet trening på 127 milliarder tokens, etterfulgt av to spesialiserte reinforcement learning-løp som ble slått sammen til én modell. Treningsmaterialet omfatter webapplikasjoner, desktop-programmer, MCP-servere, kode og hybride miljøer der samme tilstand kan nås både gjennom GUI og verktøy.
Selskapets Agentic Task Factory har så langt produsert omtrent 10 000 oppgaver. Systemet bygger interaktive miljøer og oppgaver som kan kontrolleres automatisk, blant annet fra dokumentasjon, skjermbilder av virkelige nettsteder og open source-programvare. Det er en smart måte å skaffe mer variert agenttrening på uten at mennesker må skrive og kontrollere hvert eneste steg.
Men syntetiske oppgaver arver også svakhetene i generatoren og kontrollreglene. Hvis verifikatoren bare sjekker at en fil finnes, kan agenten belønnes selv om innholdet er dårlig. Hvis treningsmiljøet er ryddigere enn en virkelig bedrifts-PC med gamle dialogbokser, tre innlogginger og et Excel-ark fra 2014, kan resultatene se penere ut enn hverdagen.
Agentoppsettet er minst like interessant som modelltreningen. H Company sier det ble bygget om etter analyser av feil på OSWorld 2.0. To sentrale endringer var et mer pålitelig minne for hundrevis av steg og tilgang til et shell på selve desktop-maskinen. Det sier noe viktig: Agentkvalitet sitter ikke bare i vektene. Minne, verktøy, kontekststyring, feilhåndtering og selve handlingsløkken kan være forskjellen på en demo og et brukbart system.
Kan Holo4 kjøres lokalt?
Ja. Modellene ligger på Hugging Face i BF16, FP8, NVFP4 og 4-bit GGUF, og begge hovedvariantene kan brukes gjennom H Models API. Modellkortene viser også oppsett med blant annet Transformers, vLLM, SGLang og Docker Model Runner.
«Kan kjøres lokalt» betyr likevel ikke «kjører lett på en vanlig PC». Holo4-27B har 27 milliarder parametere. Med 4-bit kvantisering er den teoretiske råvekten omtrent 13,5 GB, før KV-cache, bildebehandling, agentoppsett og annen overhead. Den lange konteksten på opptil 262 144 tokens kan dessuten bruke mye minne hvis du faktisk prøver å fylle den.
MoE-modellen Holo4-35B-A3B aktiverer langt færre parametere per token enn totalstørrelsen tilsier, men alle ekspertene må fortsatt lagres. Det kan gi raskere inferens enn en tett 35B-modell uten at lagrings- og minnebehovet forsvinner. De kvantiserte variantene gjør lokal testing mer realistisk, men maskinvarekravene må måles i ditt faktiske oppsett.
Lisensene er også forskjellige. Holo4-35B-A3B er publisert med Apache 2.0, mens modellfamilien og formatene er dokumentert i 35B-modellkortet. Holo4-27B står med CC BY-NC 4.0, som begrenser kommersiell bruk. Det er en vesentlig detalj for bedrifter: Åpne vekter betyr ikke automatisk at alle variantene er frie å bygge et kommersielt produkt på.

Hva må være på plass før en agent får styre maskinen?
Start smalt. Gi agenten én avgrenset oppgave i et miljø du kan gjenopprette. La den arbeide med kopier av data, egne testkontoer og tilgangsopplysninger som bare virker mot ressursene oppgaven krever. Ikke gi en ny modell tilgang til e-post, kunderegister, skylagring og produksjonsserver i samme første test. Det burde være åpenbart, men agentfeil blir fort dyrere når alt er koblet sammen.
Computer use gjør også gammel sikkerhetspraksis aktuell på nytt. En agent som ser skjermen, kan møte prompt injection i en nettside, et dokument eller en melding. En agent som har API-nøkler, kan lekke dem. Historien om 1,5 millioner stjålne API-nøkler fra AI-agenter er en ganske brutal påminnelse om at nyttige verktøy og farlige tilganger ofte er to sider av samme sak.
Jeg ville krevd minst fire ting før mer ansvar: full logging av handlingene, tekniske grenser for nettverk og filer, menneskelig godkjenning før irreversible steg og en enkel måte å stanse kjøringen på. I tillegg må du teste hva agenten gjør når et program fryser, en innlogging utløper, et felt flytter seg eller verktøyet svarer med feil data.
Det er nettopp her Holo4 blir spennende. Kombinasjonen av GUI, kode og strukturerte verktøy ligner mer på hvordan virkelige oppgaver faktisk ser ut. De åpne kjøreloggene gjør det også mulig å kontrollere mer enn leverandørens ferdige prosenttall.
Men dommen min er foreløpig enkel: Holo4 er en lovende byggestein for generalistiske computer-use-agenter, ikke dokumentasjon på at du kan overlate jobben og gå hjem. Kjør den lokalt eller i en avgrenset sandbox, les kjøreloggene og la den bevise stabilitet på dine egne oppgaver. Ansvar kommer etter pålitelighet, ikke før.
Ofte stilte spørsmål
Hva kan en Holo4-agent gjøre på en datamaskin?
Holo4 kan tolke skjermbilder og be et agentoppsett klikke, skrive, kjøre kode eller bruke MCP- og API-verktøy. Den er laget for arbeidsflyter på web, desktop, Android og i kode-sandkasser, men trenger et oppsett som utfører handlingene.
Er Holo4 gratis å bruke kommersielt?
Det avhenger av modellen. Holo4-35B-A3B er oppført med Apache 2.0, mens Holo4-27B bruker CC BY-NC 4.0 og dermed har en begrensning mot kommersiell bruk. Kontroller alltid den konkrete modellens lisens før den bygges inn i et produkt.
Hvor mye minne trenger Holo4 lokalt?
Behovet avhenger av kvantisering, kontekst og agentoppsett. Med 4-bit kvantisering er den teoretiske råvekten til Holo4-27B omtrent 13,5 GB. Bildebehandling, KV-cache og agentmiljø kommer i tillegg, så en lang kjøring kan kreve betydelig mer minne.
Er Holo4 bedre enn Claude og GPT til computer use?
Ikke generelt dokumentert. H Company viser sterke resultater, men sammenligningene bruker ulike agentoppsett, oppgavesett og målemetoder. Holo4-27B ligger bak Opus 5.5 på OSWorld 2.0 i selskapets oppsett. Egne tester og åpne kjørelogger er viktigere enn én rangering.