Innhold Vis
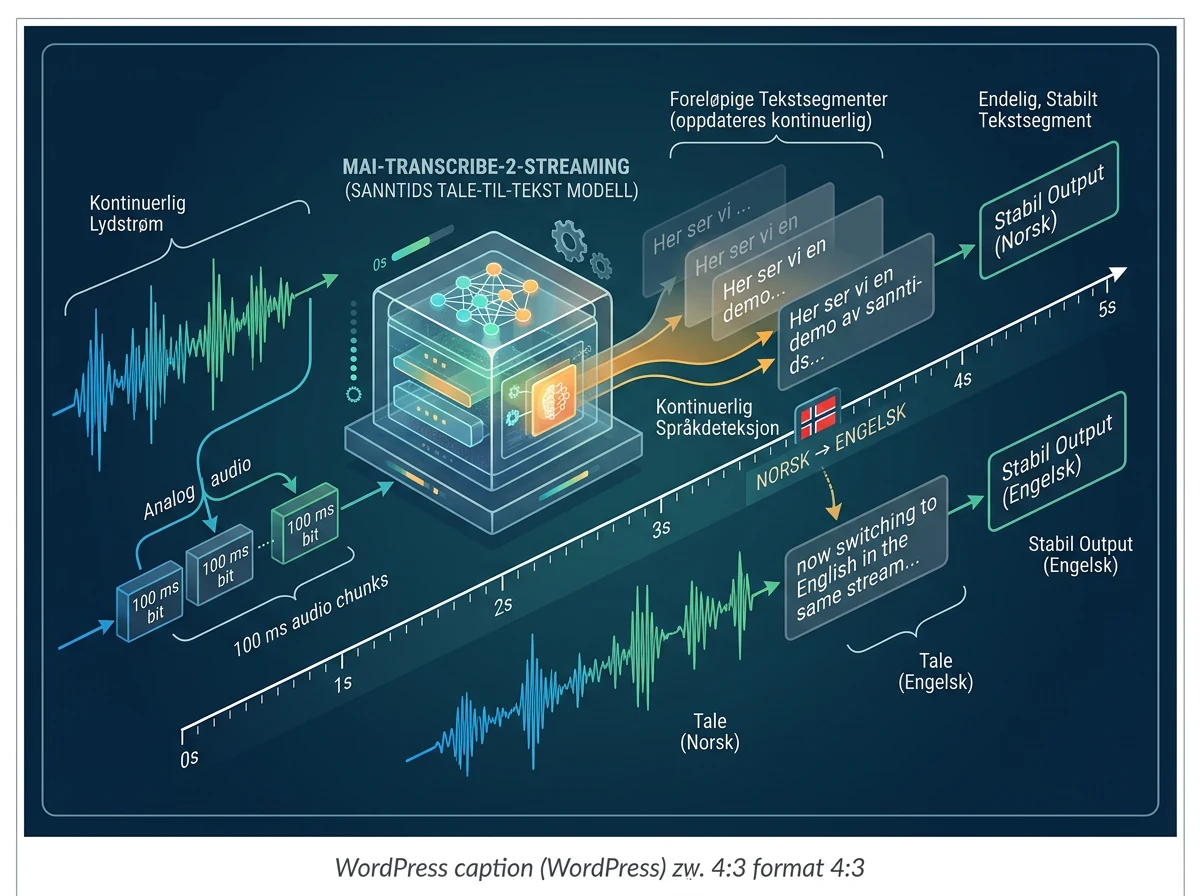
Hvis du bygger en stemmeagent, direkteteksting eller diktering, er ventetiden mellom tale og tekst helt avgjørende. Microsofts nye MAI-Transcribe-2-Streaming sender foreløpig tekst mens brukeren fortsatt snakker, før den bekrefter stabile segmenter.
Modellen støtter 60 språk, blant dem norsk bokmål, og oppdager språk fortløpende mens samtalen pågår. Målet er enkelt: å gi stemmeagenten mer tid til å forstå, bruke verktøy og svare uten den kleine pausen som får en samtale til å føles som en treg telefonsvarer.
Dette er ikke en åpen modell du kan kjøre på egen maskin, og den er foreløpig bare i public preview uten SLA. Likevel er kombinasjonen av nøyaktighet, fart og en konkret pris interessant for alle som prøver å få en taleassistent til å føles mindre som en treg telefonsvarer.
Hva er MAI-Transcribe-2-Streaming?
MAI-Transcribe-2-Streaming er Microsoft AI sin første modell laget spesielt for løpende tale-til-tekst. Den tar imot lyd kontinuerlig og sender tilbake foreløpig tekst mens personen fortsatt snakker, før den bekrefter et stabilt transkript for hvert segment. Modellen ble lansert 1. oktober 2026 og er tilgjengelig gjennom Microsoft Foundry.
Forskjellen fra vanlig batch-transkripsjon er viktig. En batchmodell får hele lydfilen og behandler den etterpå. En strømmemodell må forstå talen bit for bit, rette sine egne foreløpige hypoteser når ny sammenheng kommer til og levere resultatet raskt nok til at resten av systemet kan reagere.
Det gjør strømmemodellen aktuell for mer enn å skrive ned et møte. Direkteteksting må holde følge med taleren, diktering må vise ordene uten irriterende pauser, og en stemmeagent trenger teksten tidlig nok til å rekke både resonnering og verktøykall. Til en ferdig lydfil der svaret kan komme senere, kan en rimeligere batchmodell fortsatt være et bedre valg.
Microsoft oppgir 60 språk med automatisk og kontinuerlig språkdeteksjon. Det betyr at modellen kan følge en samtale der språket skifter underveis. Den offisielle språklisten inkluderer norsk bokmål med språkkoden nb.
Hvor god er modellen i sanntid?
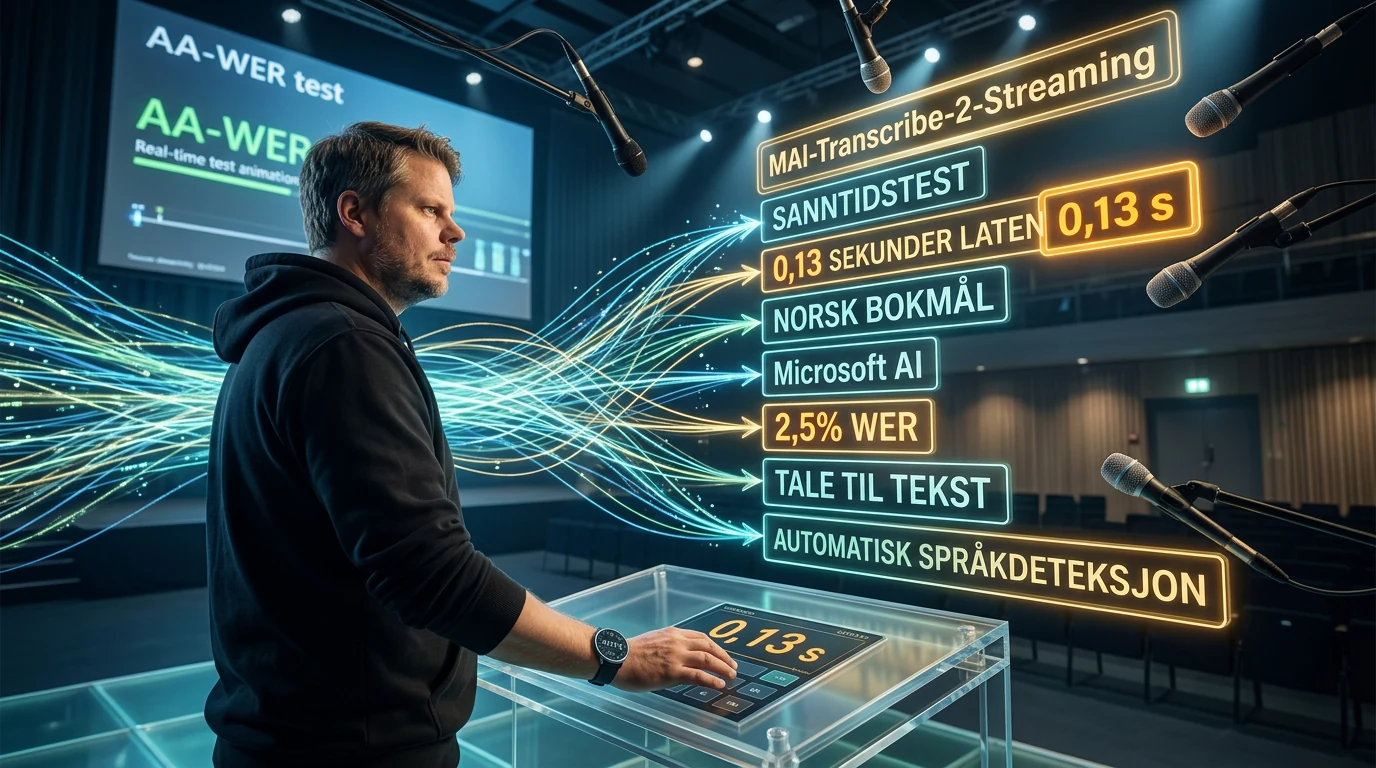
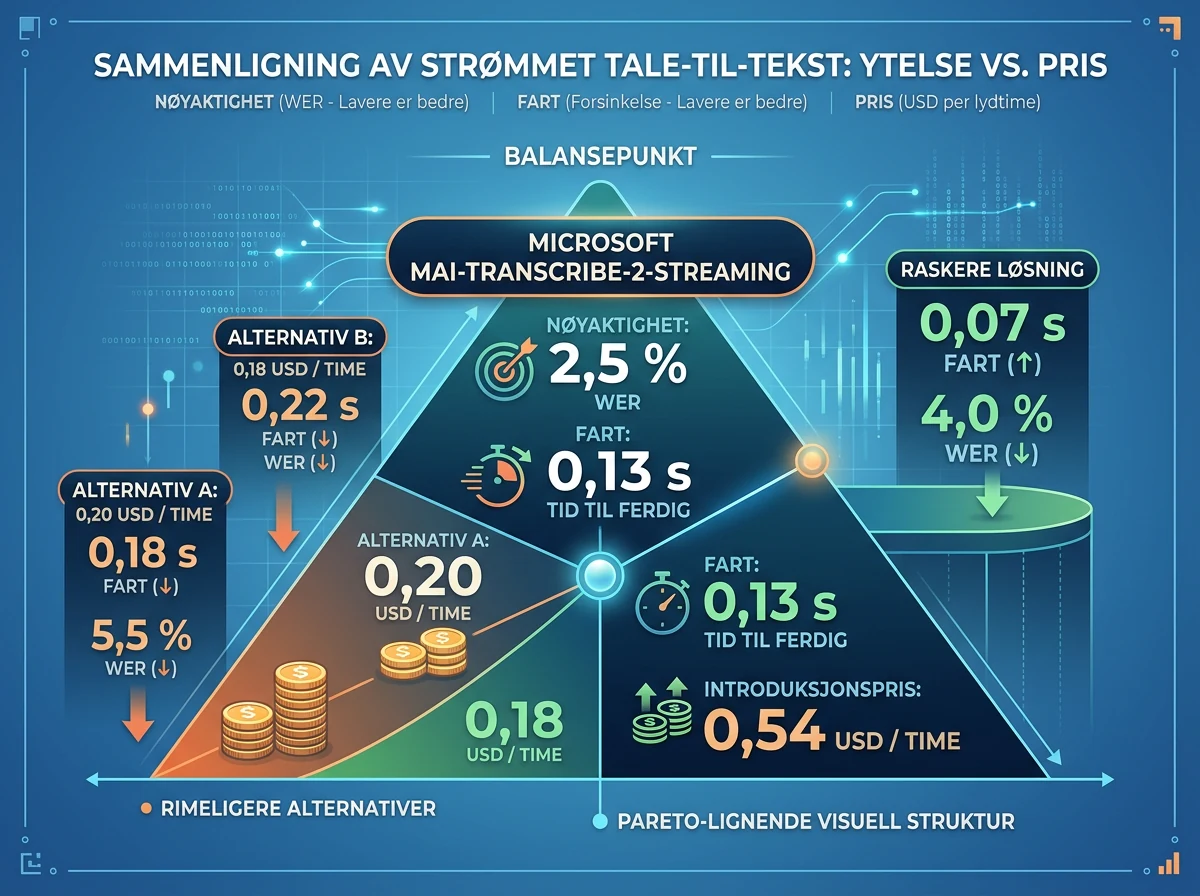
MAI-Transcribe-2-Streaming oppnår 2,5 prosent WER ved både første foreløpige og første ferdige transkript. Latensen etter registrert taleslutt er henholdsvis 0,12 og 0,13 sekunder. Det plasserer modellen øverst blant 38 testede modeller i resultatene som fulgte lanseringen.
WER står for Word Error Rate og måler innsettinger, utelatelser og feil ord i forhold til fasiten. 2,5 prosent WER betyr derfor ikke at 97,5 prosent av hele setninger blir perfekte. Det betyr omtrent 2,5 ordfeil per 100 referanseord i testmaterialet. Lavere er bedre.
AA-WER Streaming bruker rundt åtte timer med lyd. Halvparten kommer fra AA-AgentTalk, mens VoxPopuli og Earnings22 utgjør 25 prosent hver. Materialet dekker samtaler, ulike aksenter, faguttrykk og krevende lydforhold. Både WER og ventetid måles etter at SileroVAD har registrert at taleren er ferdig.
Den målemetoden forklarer også hvorfor 0,13 sekunder ikke er hele tiden fra et ord blir uttalt til det vises på skjermen. Tallet starter ved registrert taleslutt og måler hvor raskt det valgte transkriptet kommer etterpå. Microsofts opplysning om første hypoteser litt over 100 millisekunder etter innkommende lyd beskriver en annen del av strømmen. Begge tallene er nyttige, men de må ikke blandes sammen.
Microsoft ligger også på den såkalte Pareto-fronten for nøyaktighet og fart. Det betyr at ingen annen målt modell gir bedre nøyaktighet uten å ofre mer tid, eller lavere ventetid uten å ofre nøyaktighet. Modellen er ikke raskest for enhver pris: Cartesia Ink-2 leverte ferdig tekst på 0,07 sekunder i sammenligningen, men med 4,0 prosent WER. Microsofts styrke er balansen.
Hvorfor foreløpige transkripter betyr så mye
En stemmeagent trenger ikke alltid vente på punktum. Når de første ordene kommer tidlig nok, kan agenten begynne å hente data, planlegge et verktøykall eller forberede et svar mens brukeren fortsatt snakker. Microsoft sier at modellen produserer sine første hypoteser litt over 100 millisekunder etter at lyden kommer inn.
Det spesielle resultatet her er at første foreløpige transkript og ferdig transkript begge ender på 2,5 prosent WER i Artificial Analysis-testen. Vanligvis er tidlig tekst mer usikker fordi modellen har mindre sammenheng å arbeide med. En god delvis tekst kan gi en merkbart raskere agent uten at systemet må handle på mye dårligere input.
Men foreløpig betyr fortsatt foreløpig. Microsoft anbefaler at applikasjonen erstatter teksten som allerede står i feltet når en ny partial kommer, i stedet for å lime alle delresultatene etter hverandre. Først når et segment er merket som ferdig, bør det legges permanent til i transkriptet.
Hva koster MAI-Transcribe-2-Streaming?
Introduksjonsprisen er 0,54 dollar per time lyd ut 2026, omtrent 5,20 kroner med en dollarkurs rundt 9,60 kroner. Det tilsvarer 9 dollar, eller cirka 86 kroner, per 1 000 minutter. Microsoft har ikke oppgitt normalprisen som skal gjelde etter introduksjonsperioden.
Prisen er høyere enn for flere av de nærmeste konkurrentene i den samme sammenligningen. MarkTechPost oppgir 0,20 dollar per time for Grok Voice Transcribe 2.0 og 0,18 dollar for Muse Voice Transcribe. Microsofts egen batchmodell MAI-Transcribe-2 koster 0,10 dollar per time, men løser en annen jobb fordi hele lydmaterialet behandles samlet.
For én time er forskjellen liten. I et kundesenter eller en tjeneste med titusenvis av samtaletimer blir den fort et budsjettpunkt. Regnestykket bør derfor ta med mer enn rå minuttpris: En dyrere modell kan lønne seg hvis færre ordfeil gir færre misforståtte handlinger, mens en billigere modell kan være riktig når noen tidels sekunder eller prosentpoeng ikke spiller noen praktisk rolle.
Hvordan kan utviklere koble den til?
Microsoft dokumenterer to hovedveier inn: en OpenAI Realtime-kompatibel WebSocket og Azure Speech SDK. Realtime-grensesnittet passer når applikasjonen allerede bruker en hendelsesbasert WebSocket-flyt. Speech SDK håndterer mer av tilkoblingen, lydoverføringen og gjenopprettingen ved nettverksfeil.
For Speech SDK kreves versjon 1.52.0, et Microsoft Foundry- eller Speech-abonnement og en ressurs i en støttet region. Microsofts tekniske dokumentasjon viser for øyeblikket Sverige, Central US og Southeast Asia som tilgjengelige regioner, mens East US 2 er varslet.
Eksemplene bruker 16 kHz, 16-bit mono PCM og sender lyd i biter på 100 millisekunder. Mellomresultater kommer gjennom hendelsen for pågående gjenkjenning, mens bekreftede segmenter kommer som ferdige resultater. Når lydstrømmen er tom, skal klienten lukke strømmen og vente på siste resultat før gjenkjenningen stoppes. Stopper du umiddelbart etter siste lydblokk, kan de siste ordene forsvinne.
SDK-en håndterer allerede bekreftelser og gjenoppretting av forbindelsen. Et ekstra retry-lag som sender all lyd på nytt kan derfor lage doble mellomresultater. Dette er en liten implementasjonsdetalj med stort potensial for rare transkripter.
Hvilke begrensninger må du vite om?
Public preview er den største begrensningen. Microsoft sier uttrykkelig at forhåndsvisningen leveres uten tjenestenivåavtale og ikke anbefales til produksjonslast. Det er helt greit å prøve modellen i en prototype eller en kontrollert pilot, men en kritisk telefontjeneste trenger en reserveplan.
Speech SDK-resultatene mangler også språk-ID, confidence score og tidsstempel for hvert ord. Ferdige segmenter får offset og varighet, men mellomresultatene har ikke tidsstempler. Innstillinger for output-format og banning påvirker heller ikke teksten eller resultatstrukturen i denne modellen.
Det er verdt å merke seg språkdetaljen: Modellen kan oppdage språk fortløpende, men SDK-resultatet forteller ikke applikasjonen hvilket språk den fant. Det er godt nok for ren transkripsjon, men kan bli en begrensning hvis du skal vise språket i grensesnittet eller rute hvert språk til forskjellige arbeidsflyter.
Er dette et reelt sprang eller bare en førsteplass?
Dette ser ut som en reell og praktisk sterk debut for Microsofts første strømmemodell. Førsteplassen er nyttig som kontroll, men den viktigste egenskapen er at nøyaktigheten holder seg høy allerede i den første teksten agenten får se. Det er nettopp der en rask stemmeopplevelse enten flyter eller begynner å hakke.
Samtidig er åtte timer testlyd ikke det samme som dine kunder, mikrofoner, dialekter og faguttrykk. Norsk bokmål står på listen, men benchmarken dokumenterer ikke at modellen er best på norsk i et bråkete møterom i Haugesund. Det må måles på egne opptak og mot den modellen du allerede bruker.
En fornuftig pilot bør bruke det samme lydsettet mot begge modellene og dele resultatene etter situasjon. Skill mellom stille kontor, mobiltelefon, avbrudd, tall, navn, dialekt og språkbytte. Mål både endelig WER og tiden fram til brukbar partial, for en agent kan oppleves treg selv om sluttresultatet blir perfekt. Logg også hvor ofte en tidlig partial endres slik at meningen snur før segmentet bekreftes.
Deretter kommer kostnaden. Regn på faktisk lydtid, ikke bare antall brukere, og ta med konsekvensen av feil. Ett feilhørt navn i et møtereferat er irriterende. Ett feilhørt beløp eller en feil handling i en agent kan bli dyrt. Modellen som vinner et generelt leaderboard er først riktig valg når den også vinner på materialet og risikoen i din egen arbeidsflyt.
Min vurdering er derfor ganske enkel: MAI-Transcribe-2-Streaming fortjener en plass i en praktisk sammenligning hvis du bygger talegrensesnitt. Test WER, responstid og kostnad på den samme norske lyden, og se spesielt på hvor ofte foreløpig tekst endrer betydning før den blir ferdig. Bare ikke gjør en public preview uten SLA til eneste inngang for noe som må virke hver gang.
Ofte stilte spørsmål
Støtter MAI-Transcribe-2-Streaming norsk?
Ja. Microsofts offisielle språkliste inkluderer norsk bokmål med koden nb. Modellen støtter totalt 60 språk og automatisk, kontinuerlig språkdeteksjon. Speech SDK-resultatet oppgir likevel ikke hvilket språk modellen har oppdaget.
Kan MAI-Transcribe-2-Streaming brukes i produksjon nå?
Den er tilgjengelig i public preview, men Microsoft leverer forhåndsvisningen uten SLA og anbefaler den ikke til produksjonslast. Bruk den først i prototype eller pilot, og ha en reserve hvis transkripsjonen er kritisk for tjenesten.
Er MAI-Transcribe-2-Streaming raskere enn alle konkurrentene?
Nei. Den topper Artificial Analysis på nøyaktighet og ligger på Pareto-fronten for kombinasjonen av fart og feilrate. Cartesia Ink-2 leverte raskere ferdig tekst i sammenligningen, men hadde høyere WER. Microsofts fortrinn er balansen, ikke lavest mulig tid alene.
Hva koster 1 000 minutter med Microsofts strømmemodell?
Introduksjonsprisen tilsvarer 9 dollar per 1 000 minutter, omtrent 86 kroner med en dollarkurs rundt 9,60 kroner. Prisen på 0,54 dollar per time gjelder ut 2026. Microsoft har foreløpig ikke oppgitt prisen etter perioden.