Innhold Vis
Microsoft Maia 300 skal gi Azure langt mer egen kapasitet til AI-inferens fra 2027. Microsoft vil skalere hele Maia-familien til installasjoner i gigawatt-klassen og gjøre Maia til hovedsystemet for inferens i selskapets egne produkter og tjenester.
For deg som bruker Copilot, GitHub Copilot eller Microsoft Foundry betyr ikke dette at du får en ny chip på skrivebordet. Gevinsten kommer i skyen: Microsoft får større kontroll over kapasitet, strømbruk og hvilke AI-arbeidslaster infrastrukturen er optimalisert for. Det kan gi rom for flere samtidige AI-oppgaver, men Microsoft har verken lovet lavere kundepriser eller direkte Maia 300-tilgang.
Microsoft presenterte Maia 300 den 12. oktober. Den strategiske siden er minst like viktig som spesifikasjonene: Selskapet kjøper enorme mengder maskinvare fra Nvidia og andre leverandører, men vil eie en større del av motorrommet selv. Maia 300 er et seriøst alternativ for Microsofts egne inferensjobber, ikke en Nvidia-dødare.
Hva er Microsoft Maia 300?
Maia 300 er tredje generasjon av Microsofts egen akselerator for AI-inferens. Den skal settes i produksjon i 2027 og er laget for blant annet lange kontekster, resonnerende modeller, samtaler med lav forsinkelse og AI-agenter som utfører flere trinn over tid, ifølge Microsofts kunngjøring av Maia 300.
Inferens er delen som skjer når en ferdigtrent modell svarer på en prompt, skriver kode eller utfører en agentoppgave. Det er et annet behov enn å trene modellen fra bunnen av. I tjenester som kjører i stor skala kan selv små forbedringer i strømforbruk og gjennomstrømming gi store utslag i datasenteret.
Microsoft sier at Maia 200 allerede kjører produksjonsarbeid for Copilot og selskapets egne MAI-modeller. GitHub Copilot og Microsoft Foundry skal følge innen utgangen av 2026. Maia 300 bygger videre på den erfaringen, men med en ny chiplet-arkitektur der beregning, minnekontroll og inn- og utdata er fordelt på ulike brikker.
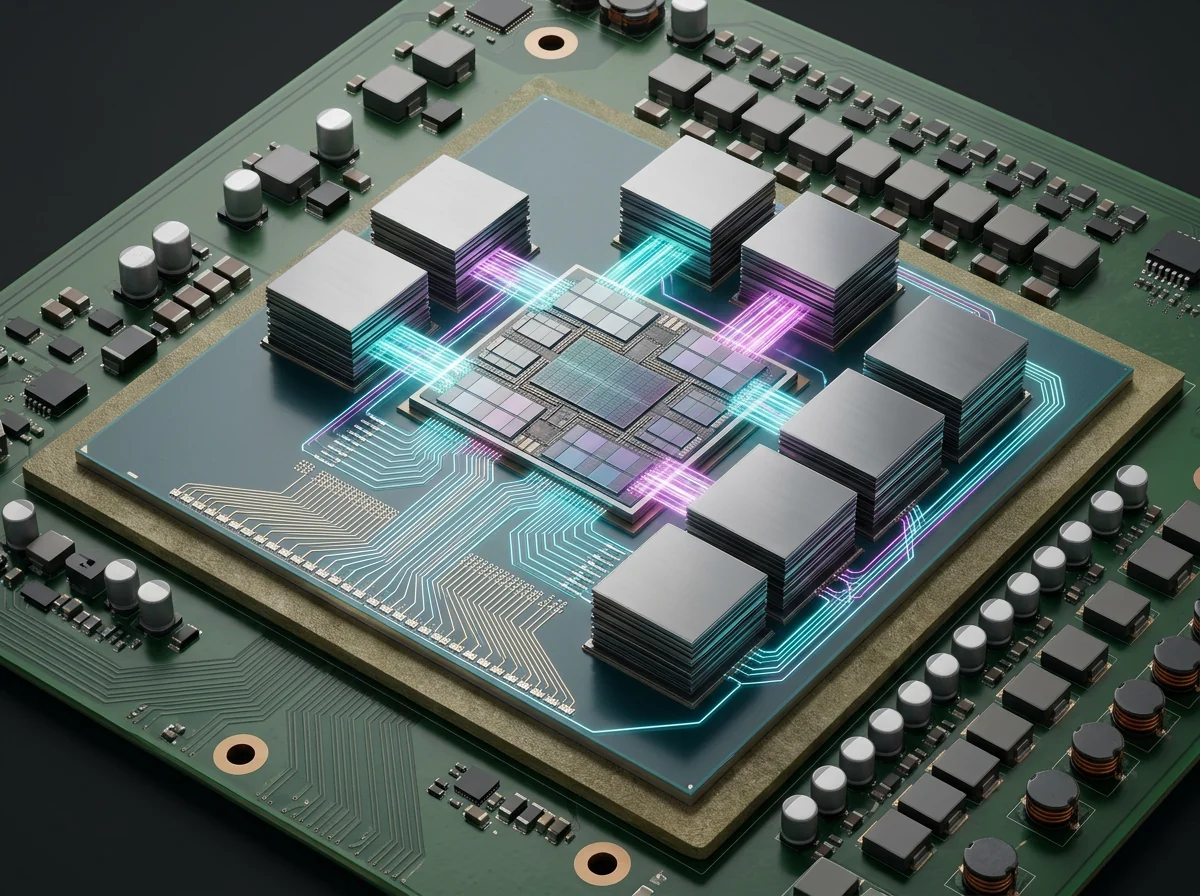
Selve beregningsdelen skal produseres med TSMCs N2P-prosess. Hver akselerator får åtte HBM4-minnestakker, 288 GB minne og opptil 18 TB/s minnebåndbredde. Det sier mye om hva Microsoft prøver å løse: Moderne AI-inferens begrenses ofte av hvor raskt data kan flyttes mellom minne, beregning og nettverk, ikke bare av hvor mange regneoperasjoner chipen kan skryte av.
Hvor mye raskere og mer effektiv er den?
Microsoft oppgir at et fullt rack med Maia 300 kan levere opptil sju ganger høyere token-gjennomstrømming enn Maia 200 og mer enn 2,5 ganger bedre ytelse per watt. Selskapet forventer også 40 prosent flere tokens per megawatt enn ledende GPU-baserte systemer. Dette er lovende tall, men de er leverandørens egne og ikke uavhengige tester.
Et Maia 300-rack inneholder 96 akseleratorer fordelt på 24 serverbrett og bruker opptil 167 kW. Til sammen har racket 27,6 TB HBM-minne og 1,7 PB/s samlet minnebåndbredde. I Microsofts tekniske gjennomgang beskrives også superpods med opptil 12 288 akseleratorer, koblet sammen over et egenutviklet transportlag basert på Ethernet.
Det er lett å gå seg vill i tallene, men det praktiske poenget er ganske enkelt: Microsoft vil servere flere AI-svar innenfor strømmen, kjølingen og gulvplassen selskapet allerede har. En chip alene løser ikke dette. Derfor er Maia 300 utviklet som et helt system der chip, minne, nettverk, programvare, strømforsyning og væskekjøling er planlagt sammen.
Microsoft trekker særlig fram mindre dataflytting. Data som allerede ligger nær riktig beregningsenhet, trenger mindre energi og tid på transport. Maia bruker en programvarestyrt dataflytarkitektur, og den nye generasjonen går fra ensartet minnetilgang til en NUMA-løsning på tvers av chiplets. Programvaren må dermed plassere data nær delen av chipen som faktisk skal arbeide med dem.
Lavere presisjon er en annen del av regnestykket. Maia 300 støtter blant annet en forbedret variant av MXFP4 og lagring med under tre biter. Smalere tallformat krever mindre minne og båndbredde, men kvaliteten avhenger av at modeller og kjerner er tilpasset dette. Det er nettopp her Microsofts kontroll over både modeller, skytjenester og maskinvare kan bli en fordel.
Betyr Maia 300 at Microsoft kutter ut Nvidia?
Nei. Maia 300 gjør Microsoft mindre avhengig av Nvidia for egen inferens, men Azure vil fortsatt være en plattform med flere typer maskinvare. Microsoft sier selv at modell- og silisiumvalg er en del av strategien. Det mest presise er derfor at Maia blir et stort internt alternativ, ikke at Nvidia forsvinner.
Microsofts egne planer viser hvor stort begge sporene kan være samtidig. Selskapet har allerede inngått avtaler om omfattende Nvidia-kapasitet, blant annet prosjektet med 30 000 Nvidia Rubin-GPUer til Narvik. Egen chip og store Nvidia-kjøp er ikke en selvmotsigelse når etterspørselen etter AI-regnekraft vokser raskere enn datasentrene kan bygges.
Det Microsoft får med Maia, er forhandlingsmakt og et ekstra forsyningsspor. Selskapet kan flytte egnede inferensjobber til egen maskinvare, reservere andre akseleratorer til oppgaver de passer bedre til og redusere risikoen ved å lene seg på én leverandør. Det er hele poenget med å bygge en egen grunnmur i stedet for å leie absolutt alt fra andre.
Nvidia konkurrerer dessuten ikke bare med en chip. CUDA, biblioteker, utviklerverktøy og et modent økosystem gjør det langt vanskeligere å erstatte Nvidia enn å tegne en rask akselerator. Microsoft omgår deler av dette problemet ved først å bruke Maia på arbeidslaster selskapet selv kontrollerer. Det er langt enklere å tilpasse Copilot og egne modeller til egen maskinvare enn å få hele markedet til å bytte plattform.
Hvorfor bygges Maia 300 for AI-agenter?
AI-agenter kan holde på lenger enn en vanlig chatforespørsel. De leser store kontekster, bruker verktøy, venter på resultater og fortsetter gjennom flere steg. Maia 300 er laget for denne blandingen av minnekrevende arbeid, langvarig dekoding og kommunikasjon mellom mange akseleratorer.
Det forklarer hvorfor Microsoft snakker så mye om minnebåndbredde og nettverk. En stor språkmodell må flytte enorme mengder modellvekter og mellomresultater for hvert token. Når flere akseleratorer samarbeider om samme jobb, kan nettverket mellom dem bli flaskehalsen. Maia 300 lar akseleratorer kommunisere direkte innenfor et superpod-oppsett, uten at all trafikk må ta omveien gjennom vertsmaskiner og separate nettverkskort.
Racket kan også fordele ulike deler av inferensen. Første fase, der modellen behandler hele prompten, kan kjøre på andre arbeidere enn den påfølgende token-produksjonen. Mellomtilstanden kan flyttes direkte over Maia-nettverket. Det gir Microsoft flere muligheter til å pakke arbeidslaster effektivt og unngå at dyr kapasitet står ubrukt.
Dette er relevant fordi agentiske tjenester fort kan bli dyrere enn en enkel chatbot. Én brukerforespørsel kan utløse mange modellkall, verktøykall og lange resonnementer. Hvis Copilot og GitHub Copilot skal gjøre mer på egen hånd uten at infrastrukturen eser ut i samme tempo, må kostnaden per nyttig token ned.
Hva kan dette bety for Azure-kunder?
På kort sikt er Maia 300 først og fremst en kapasitetsnyhet. Produksjonsutrullingen starter i 2027, og Microsoft har ikke publisert en egen Maia-instans som Azure-kunder kan bestille, noen prisliste eller en dato for bred ekstern tilgang. Ingen bør derfor planlegge et prosjekt rundt direkte Maia 300-tilgang ennå.
Den indirekte virkningen kan likevel bli merkbar. Mer effektiv inferens kan gjøre det enklere for Microsoft å øke kapasiteten i Copilot, Foundry og andre tjenester uten tilsvarende vekst i strømforbruk. Det kan gi bedre tilgjengelighet og lavere intern kostnad per forespørsel. Om Microsoft sender den besparelsen videre til kundene, er et forretningsvalg, ikke en egenskap ved chipen.
Microsoft sier at Maia 200 allerede kjører OpenAI-modeller, egne MAI-modeller og ledende open source-modeller. Det viser hva selskapet ønsker å få ut av samspillet mellom maskinvare og programvare, men sier ennå ikke hvilke Maia 300-tjenester eksterne Azure-kunder faktisk får tilgang til.
For bedrifter er derfor rå chipytelse bare én del av vurderingen. Pris, modellutvalg, dataplacering, tilgjengelighet, programvarestøtte og hvor lett det er å flytte løsningen senere, betyr minst like mye. Maia 300 kan forbedre Microsofts tilbud, men den gjør ikke disse spørsmålene mindre viktige.
Det viktigste tallet er ikke sju ganger
Sju ganger høyere gjennomstrømming enn Maia 200 er den mest fristende overskriften. Sammenligningen er likevel med Microsofts egen forrige generasjon, og det nye racket har dobbelt så mange akseleratorer. Mer enn 2,5 ganger bedre ytelse per watt er derfor et mer nyttig mål, men også dette er et internt tall uten en offentlig, detaljert sammenligning mot navngitte Nvidia- eller AMD-systemer.
The Verge omtaler Maia 300 som chipen som gjør Microsoft mindre avhengig av Nvidia. Det treffer retningen godt. Likevel er den virkelige testen ikke presentasjonen, men hvor mye produksjonsarbeid Microsoft faktisk flytter over, hvor stabilt systemet kjører og hva det koster per levert token i ekte tjenester.
Dette er heller ikke bare en kamp om hvem som har den raskeste brikken. Microsoft prøver å eie hele stakken fra modell og kompilator til nettverk, rack og datasenter. Konkurrenter gjør det samme, samtidig som enorme prosjekter fortsatt bygges rundt Nvidia. Avtalen der Thinking Machines Lab valgte Nvidia GB300-kapasitet hos Google Cloud, viser hvor sterk etterspørselen etter etablerte GPU-systemer fortsatt er.
Min foreløpige dom er derfor ganske jordnær: Maia 300 ser ut som et seriøst skritt mot større kontroll over Microsofts egen AI-infrastruktur, ikke en Nvidia-dødare. Hvis Microsoft lykkes med utrullingen i gigawatt-skala, får selskapet mer kapasitet, bedre forhandlingsposisjon og større frihet til å forme AI-tjenestene sine. Det er mer enn nok til å være viktig.
Ofte stilte spørsmål
Når kommer Microsoft Maia 300 i bruk?
Microsoft sier at produksjonsutrullingen av Maia 300 starter i 2027. Selskapet skal samtidig skalere Maia-familien til installasjoner i gigawatt-klassen. Det er foreløpig ikke oppgitt en dato for når eksterne Azure-kunder eventuelt kan bestille direkte tilgang til chipen.
Er Maia 300 en GPU?
Maia 300 er en spesialisert AI-akselerator for inferens, ikke en vanlig grafikkprosessor laget for et bredt marked. Den fyller mange av de samme oppgavene som datasenter-GPUer, men er utviklet som del av Microsofts eget system med tilpasset minne, nettverk og programvare.
Vil Microsoft slutte å kjøpe Nvidia-chiper?
Nei. Microsoft bygger fortsatt stor AI-kapasitet med Nvidia-maskinvare og beskriver Azure som en plattform med flere typer silisium. Maia 300 gir selskapet et eget alternativ for utvalgte inferensoppgaver og reduserer avhengigheten, men erstatter ikke hele Nvidia-økosystemet.
Blir Copilot billigere på grunn av Maia 300?
Det vet vi ikke. Microsoft forventer flere tokens per megawatt og lavere intern kostnad per AI-arbeidsmengde, men har ikke lovet lavere priser til kundene. Gevinsten kan like gjerne brukes til mer kapasitet, bedre marginer eller mer avanserte funksjoner i Copilot og Foundry.