Innhold Vis
NVIDIA Kumo Tabular kan bruke merkede rader som eksempler og gi prediksjoner for nye rader uten at du trener en egen modell for oppgaven. Du slipper en separat runde med hyperparameterjakt og modelltilpasning før du får en første klassifisering eller regresjon. For alle som har brukt timer på å bygge en baseline før det egentlige arbeidet kan begynne, er det et ganske fristende løfte.
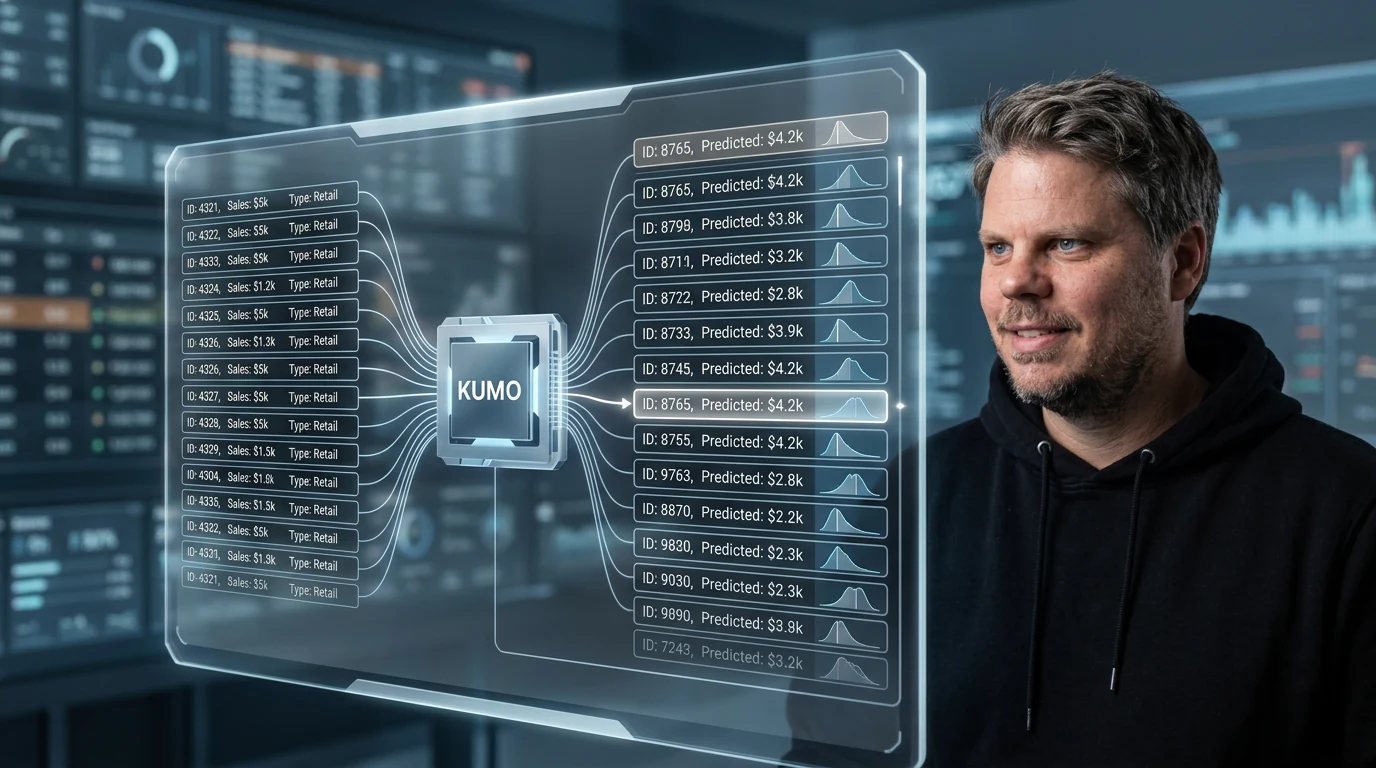
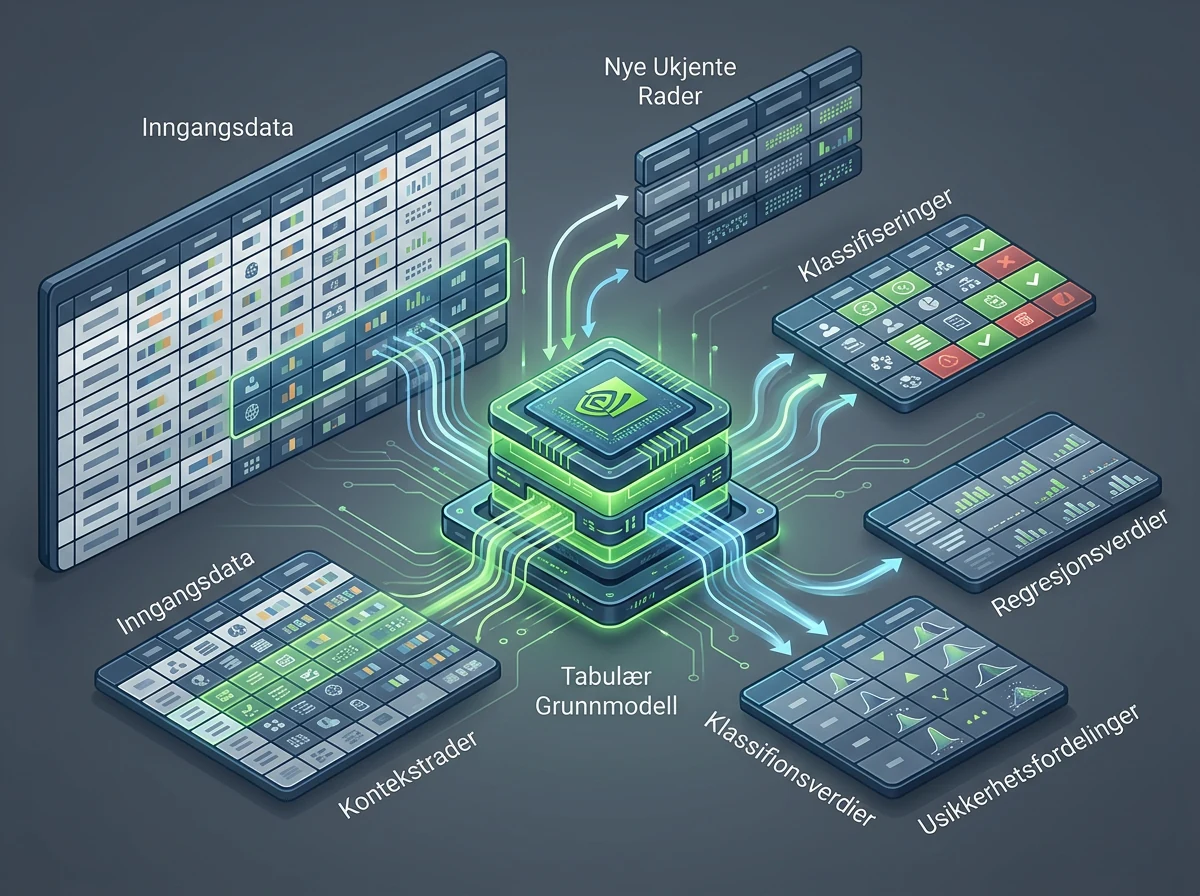
Tenk kundelister, transaksjoner, sensordata eller ordrelinjer. Du har noen rader der svaret er kjent, og vil anslå svaret for resten. Kumo Tabular leser de kjente radene som kontekst og predikerer etiketten eller tallet for nye rader i én forward pass. Det ligner måten en språkmodell lærer oppgaven fra eksempler i prompten, bare at innholdet er en tabell.
Det mest nyttige er derfor ikke enda en førsteplass på en resultatliste. Kumo Tabular kan gjøre veien fra et datasett til en brukbar første modell mye kortere. Men den er ikke en tryllestav. NVIDIA ber selv brukerne kontrollere både nøyaktighet og kalibrering på egne hold-out-data før modellen settes i produksjon.
Hva er NVIDIA Kumo Tabular?
NVIDIA Kumo Tabular er en familie med tre forhåndstrente tabulære grunnmodeller for klassifisering og regresjon. Ifølge NVIDIAs tekniske presentasjon har variantene fra 28 til 215 millioner parametere og er trent utelukkende på kunstig genererte tabeller.
I vanlig maskinlæring starter hvert nytt problem gjerne med en ny treningsrunde. Data må klargjøres, egenskaper velges eller konstrueres, flere algoritmer prøves og innstillinger justeres. Kumo Tabular er allerede trent på å forstå mønstre i tabeller. Når den får rader med kjente svar som kontekst, bruker den denne konteksten direkte til å løse den nye oppgaven.
Familien kommer i Small, Medium og Large. Klassifisering og regresjon bruker separate modeller, men arbeidsmåten er den samme: kjente rader inn som kontekst, ukjente rader inn som spørsmål og prediksjoner ut. Det gjør modellen særlig interessant når du trenger et raskt sammenligningsgrunnlag, har begrenset tid til modellutvikling eller vil undersøke om dataene inneholder et nyttig signal i det hele tatt.
NVIDIA kaller Kumo Tabular en åpen modell. Det er verdt å være presis: kildekoden til biblioteket er Apache 2.0, mens modellvektene har OpenMDW 1.1-lisens. Modellkortet på Hugging Face bekrefter lisensen for vektene, mens NVIDIAs tekniske presentasjon oppgir at den tillater kommersiell bruk. Det er altså en reelt tilgjengelig modellfamilie, men kode og vekter har ikke samme lisens.
Hva betyr én forward pass i praksis?
Én forward pass betyr at Kumo Tabular ikke oppdaterer modellvektene for hvert nytt datasett. Modellen leser kontekstradene, etikettene deres og radene som skal vurderes, og produserer svaret direkte. NVIDIA beskriver dette som in-context learning for tabeller, tilsvarende prinsippet der en språkmodell lærer formatet fra noen få eksempler uten finjustering.
For klassifisering gir modellen sannsynligheter for ulike klasser. For regresjon lager den 999 kvantiler, som igjen kan brukes til både et punktestimat og et mål på usikkerhet. Det siste er nyttig. En modell som bare spytter ut tallet 42 ser selvsikker ut uansett hvor tynt grunnlaget er. En prediktiv fordeling forteller mer om hvor mye tillit du bør ha til svaret.
Modellen behandler numeriske og kategoriske verdier direkte. Manglende verdier får egen behandling og trenger ikke nødvendigvis å fylles inn på forhånd. Tekst, bilder og tidsstempler ligger derimot utenfor kjerneformatet og må gjøres om til egnede features med preprocessing. Påstanden om «ingen feature engineering» gjelder altså den støttede tabulære arbeidsflyten, ikke absolutt alle rådata du klarer å legge i en CSV-fil.
En første prediksjon uten trening betyr heller ikke at hele jobben forsvinner. Du må fortsatt definere målet riktig, passe på datalekkasje, dele data på en fornuftig måte og måle resultatene mot et datasett modellen ikke fikk se som kontekst. Den kjedelige delen av god datapraksis er fortsatt kjedelig. Og fortsatt nødvendig.
Hvordan leser modellen en tabell?
Kumo Tabular kombinerer oppmerksomhet på tre nivåer: kolonner, rader og hele konteksten. Fire lærbare [CLS]-tokens komprimerer hver rad før den siste delen av modellen, slik at kostnaden der ikke lenger øker med antallet kolonner. Arkitekturen er beskrevet i detalj i NVIDIAs gjennomgang av modellen.
Kolonneoppmerksomheten ser nedover en kolonne og prøver å forstå hva en verdi betyr i akkurat den fordelingen. Tallet 42 kan være høyt i én kolonne og helt normalt i en annen. Radoppmerksomheten ser på hvordan verdiene i samme rad henger sammen. Til slutt sammenligner in-context-delen radene med kjente svar mot radene som skal predikeres.
Spørringsradene får bare se kontekstradene, ikke hverandre. Derfor skal en prediksjon for én rad ikke endre seg fordi du tilfeldigvis sendte med andre rader i samme batch. Oppsettet gjør også at modellen kan beregne og gjenbruke nøkkel- og verdicachen for konteksten når flere nye rader skal vurderes.
NVIDIA har i tillegg lagt inn en lengdeavhengig temperatur i attention-mekanismen. Vanlig softmax-attention kan bli for diffus når antallet rader vokser fra noen hundre til titusenvis. Kumo Tabular justerer temperaturen etter logaritmen til antallet nøkler, med en egen lært koeffisient per attention-hode. Målet er at relevante kontekstrader fortsatt skal skille seg ut i store tabeller.
Hvor mye data er modellen trent på?
Kumo Tabular er ikke trent på kunderegistre, lånesøknader eller andre virkelige bedriftsdata. Treningsgrunnlaget består av kunstige tabeller generert fra strukturelle kausalmodeller. NVIDIA oppgir at Small, Medium og Large så omtrent 35, 71 og 137 millioner syntetiske tabeller under treningen.
Generatoren varierer blant annet tabellstørrelse, oppgavetype, manglende verdier, kategorier, uteliggere og sammenhenger mellom skjulte variabler. Noen tabeller får dupliserte rader med ulike etiketter, skjevfordelte regresjonsmål og kolonner med mange kategorier. En enkel trebasert kontroll forkaster tabeller uten et signal det faktisk går an å lære.
Treningen foregår i tre trinn. Første trinn bruker tabeller med 1 024 rader og opptil 100 kolonner. Deretter varierer konteksten fra 400 til 10 240 rader, før siste trinn strekker seg til 60 000 rader og fortsatt opptil 100 kolonner. Det forklarer både hvorfor modellen kan håndtere relativt store kontekster og hvorfor NVIDIA advarer mot tabeller langt utenfor treningsområdet.
At treningsdataene er syntetiske er både elegant og litt vilt. NVIDIA kan lage enorme mengder varierte tabeller uten å samle inn personopplysninger fra virkelige mennesker. Samtidig kan en generator aldri garantere at den har fanget alle de rare mønstrene i ekte virksomhetsdata. Derfor er lokal validering viktigere enn hvor pen resultatlisten ser ut.
Hvor god er Kumo Tabular?
NVIDIA rapporterer at Kumo Tabular ligger øverst på TabArena og har toppresultater på BeyondArena, TALENT og ScoringBench. I et ensartet oppsett med én RTX 6000 Pro kjørte modellen 17 ganger raskere enn LimiX-2. Resultatene er lovende, men de kommer fra teamet som har laget modellen.
Jeg ville derfor ikke valgt Kumo Tabular bare fordi 1 950 er et stort tall. Benchmarken viser at modellen fortjener å bli testet. Den viser ikke at modellen automatisk er best på akkurat dine kunder, sensorer eller salgstall. For en bedrift er det lokale resultatet som teller: treffsikkerhet, kalibrering, kjøretid, maskinvarebehov og kostnaden ved feil.
Det riktige spørsmålet er om Kumo Tabular kan gi deg en sterk baseline raskere. Sammenlign den med minst én solid trebasert modell som CatBoost, LightGBM eller XGBoost under samme datasplitt. Hvis Kumo vinner eller gir omtrent samme kvalitet med langt mindre arbeid, har du funnet noe nyttig. Hvis den taper, har du fremdeles fått et godt sammenligningspunkt uten en uke med hyperparameterbingo.
Dette passer også inn i NVIDIAs bredere satsing på modeller, programvare og ferdige byggeklosser rundt GPU-ene. Jeg har tidligere skrevet om hvordan NVIDIA går fra brikkeleverandør til et full-stack AI-selskap. Kumo Tabular er et konkret eksempel: selskapet leverer ikke bare maskinvaren, men også modellen, biblioteket og arbeidsflyten som holder beregningen på GPU.
Hva kreves for å bruke modellen?
Kumo Tabular kjøres gjennom NVIDIAs GPU-baserte bibliotek structured-data-models. Det offisielle GitHub-repositoriet oppgir Python 3.11 eller nyere og PyTorch 2.7 eller nyere. NVIDIA anbefaler også cuDF for CUDA-jobber, slik at tabelloperasjoner kan bli på GPU-en og unødvendig flytting av data unngås.
Modellkortet viser en kort arbeidsflyt: gjør en pandas-DataFrame om til en TableTensor, angi hvilke kolonner som er numeriske og kategoriske, og send merkede kontekstrader og nye spørringsrader til modellen. Eksemplet bruker 300 merkede rader som kontekst og resten som spørring, med åtte estimatorer i ensemblet.
Det gjør terskelen lav for en utvikler som allerede bruker Python og pandas. Men «ingen trening» betyr ikke «ingen infrastruktur». Dette er fremdeles en GPU-native modellfamilie, og Hugging Face tilbyr foreløpig ikke Kumo Tabular gjennom en ferdig inference-leverandør. Du må kjøre modellen selv og ta ansvar for dataflyt, miljø, måling og drift.
NVIDIAs bibliotek støtter flere modeller for strukturerte data gjennom samme grensesnitt, blant annet TabICLv2 og Kumo Relational. Det er en fin detalj for videre testing. Kumo Tabular er ikke et isolert demo-checkpoint, men en del av et bibliotek der tabulære og relasjonelle modeller kan sammenlignes og etter hvert byttes uten at hele datalaget må skrives på nytt.
Hvem bør teste Kumo Tabular?
Kumo Tabular passer best for utviklere, analytikere og mindre team som har merkede tabelldata og trenger en rask, sterk baseline for klassifisering eller regresjon. Den kan være særlig nyttig i tidlig utforsking, når alternativet er å bygge og justere flere modeller før du vet om problemet er verdt innsatsen.
For små og mellomstore bedrifter er tidsgevinsten mer interessant enn modellenes parameterantall. Hvis du kan gå fra data til en troverdig første måling på én arbeidsøkt, blir det billigere å avvise svake ideer og enklere å prioritere de gode. Det er en mer jordnær gevinst enn å juble over enda en leaderboard.
Jeg ville vært mer forsiktig dersom dataene endrer seg raskt, tabellen er langt større enn treningsområdet, tekst og tid er sentrale signaler eller feil prediksjon har store konsekvenser. NVIDIA sier selv at kvaliteten kan falle når spørringsradene kommer fra en annen fordeling enn kontekstradene. Da trenger du overvåking, nye valideringssett og en plan for hva som skjer når modellen blir usikker.
Kumo Tabular gjør ikke dataarbeid unødvendig. Den flytter bare mer av modellarbeidet inn i en forhåndstrent modell. Det er likevel en viktig endring. Når klassifisering og regresjon kan starte med eksempler i konteksten i stedet for en ny treningspipeline, blir avansert tabulær AI tilgjengelig for flere enn team med tid og kompetanse til å finjustere alt fra bunnen av.
Mitt råd er enkelt: bruk Kumo Tabular som en rask og seriøs utfordrer, ikke som en fasit. Test på dine egne hold-out-data, sammenlign med en god trebasert baseline og mål kostnaden ved feil. Hvis modellen leverer der, har NVIDIA fjernet mye av friksjonen som vanligvis står mellom en tabell og en nyttig prediksjon.
Ofte stilte spørsmål
Må Kumo Tabular trenes på mitt eget datasett?
Nei. Du gir modellen merkede rader som kontekst og nye rader som skal predikeres. Den oppdaterer ikke vektene for den nye oppgaven. Du bør likevel bruke egne hold-out-data for å måle treffsikkerhet og kalibrering før praktisk bruk.
Kan Kumo Tabular brukes til både klassifisering og regresjon?
Ja. NVIDIA tilbyr separate modeller for klassifisering og regresjon. Klassifiseringsmodellen gir sannsynligheter for klasser, mens regresjonsmodellen produserer 999 kvantiler som kan brukes til et punktestimat og et anslag på usikkerheten.
Kan Kumo Tabular håndtere tekst og datoer direkte?
Ikke som kjerneformat. Modellen arbeider direkte med numeriske og kategoriske kolonner. Tekst, bilder og tidsstempler må først gjøres om til egnede features gjennom preprocessing. Manglende verdier i støttede kolonner behandles derimot særskilt av modellen.
Er NVIDIA Kumo Tabular gratis å bruke kommersielt?
Modellvektene er publisert med OpenMDW 1.1, som NVIDIA oppgir tillater kommersiell bruk, mens bibliotekets NVIDIA-kode bruker Apache 2.0. Les likevel begge lisensene og vilkårene for eventuelle tredjepartskomponenter før modellen bygges inn i et produkt.