Innhold Vis
Hvis du skal gjøre et langt møteopptak om til tekst, har Nvidia laget en modell som vil gjøre langt mer enn å skrive ned ordene. Nemotron 3.5 Transcribe kan arbeide med opptak på opptil én time, skille mellom talere, lage tidsstempler, oversette og svare på spørsmål om lyden.
Men den viktigste avgrensningen kommer med én gang: Dette er en offline-modell for ferdige opptak. Den kan ikke lytte til en direktesendt lydstrøm og svare fortløpende. Dermed er den aktuell for møter, mediearkiv, kundesamtaler og dokumentasjon – ikke som selve øret i en taleagent som må reagere mens du snakker.
Nvidia slapp modellen 28. oktober 2026 med åpne vekter og støtte for 40 språk. Det er en spennende pakke for utviklere som vil kontrollere transkripsjonen selv. Samtidig er «40 språk» et grovt tall som skjuler store kvalitetsforskjeller. For norske brukere er dokumentasjonen langt mindre overbevisende enn lanseringsoverskriften.
Hva er Nemotron 3.5 Transcribe?
Nemotron 3.5 Transcribe er en åpen tale- og lydmodell som kombinerer automatisk talegjenkjenning med en språkmodell. Nvidias modellkort oppgir 40 språk, opptak på opptil én time og en kontekst på 65 536 token. Modellen tar både lyd, tekstinstruksjoner og valgfri kontekst som input.
Navnet inneholder 30B-A4B, men hele pakken er større enn det kan se ut som. Hugging Face oppgir totalt rundt 34 milliarder parametere, mens omtrent 4,3 milliarder er aktive under kjøring. Det skyldes en mixture-of-experts-arkitektur der bare deler av modellen arbeider med hvert token. Lydkoderen er regnet med i de aktive parameterne.
Dette er heller ikke bare en ny variant av vanlig diktering. Du kan be om ordrett eller ryddet transkripsjon, ordtidsstempler, merking av talere, språkidentifikasjon og oversettelse. Modellen kan få en liste med faguttrykk eller navn som kontekst, noe som er praktisk når et møte handler om produkter, medisin eller tekniske begreper som vanlig talegjenkjenning ofte tygger i stykker.

Hva kan modellen gjøre med et opptak?
Den største verdien er at flere ledd kan samles i samme modell. Et møteopptak kan transkriberes med talermerking og tidsstempler, mens tekstinstruksjonen styrer om resultatet skal være ordrett eller ryddet. Nvidia beskriver også oppgaver som hendelsesmerking, identifisering av språk, skjerming av personopplysninger og spørsmål om innholdet i lyden.
TechCrunch rapporterer at modellen kan oversette 31 språk til og fra engelsk og skille mellom opptil åtte talere. Det gjør den relevant for møtereferater og intervjuer der en enkel tekstblokk ikke er nok. Talermerking betyr riktignok ikke at modellen vet hvem menneskene er. Den skiller stemmene som taler 0, taler 1 og så videre.
De publiserte resultatene ser sterke ut på flere engelske og flerspråklige tester. Nvidia oppgir 4,71 prosent gjennomsnittlig ordfeilrate på ni engelske datasett og 10,98 prosent på en langformtest. På flertalertester er gjennomsnittet 15,80 prosent cpWER, en måling som tar hensyn til både ordene og hvilken taler de ble knyttet til. Dette er nyttige tekniske signaler, men ikke en garanti for dine mikrofoner, dialekter eller faguttrykk.
Hvorfor fungerer den ikke til live tale?
Nemotron 3.5 Transcribe behandler et opptak som en ferdig lydinngang. Nvidia sier uttrykkelig at intern oppdeling av lyden ikke gjør modellen til en sanntidsbasert strømmetjeneste. Den kan være svært rask etter at lyden er levert, men høy behandlingsfart og ekte streaming er to forskjellige ting.
Forskjellen merkes når en bruker avbryter en taleagent. En streamingmodell må ta imot små lydbiter kontinuerlig, holde styr på konteksten og levere foreløpig tekst med lav forsinkelse. Nemotron 3.5 Transcribe er laget for å analysere opptaket, ikke for å drive den løpende samtalen. Det setter den i en annen kategori enn løsningene jeg omtalte da OpenAI forklarte hvordan lav forsinkelse bygges inn i taleagenter.
Det betyr ikke at offline er gammeldags eller dårlig. Et langt opptak gir modellen mer sammenheng, og mange arbeidsoppgaver trenger et gjennomarbeidet sluttresultat mer enn løpende tekst på skjermen. For møter, podkaster, kundesamtaler og arkiver kan nøyaktighet, talermerking og kontekst være viktigere enn at første setning dukker opp før den andre er sagt.
Hvor godt fungerer Nemotron på norsk?
Nvidia har norsk i listen over 40 språk, men dokumentasjonen gir ikke grunnlag for å si at modellen er god på norsk. I språkmatrisen står norsk på laveste kvalitetsnivå, «Supported», som Nvidia forklarer med at språket kan trenge finjustering. Samtidig er feltene for norsk ASR, oversettelse, flertalertranskripsjon og språkbytte ikke spesifisert.
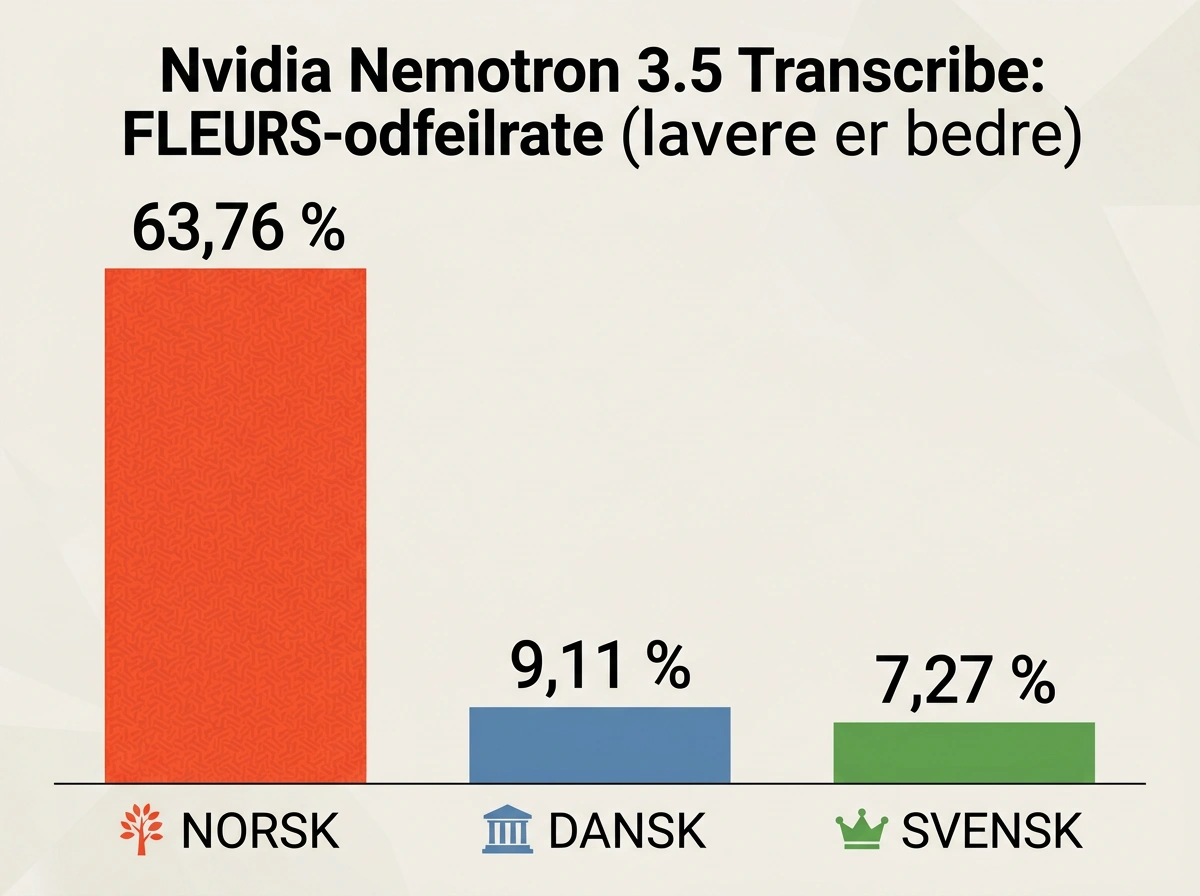
Det finnes ett konkret transkripsjonstall: Nvidias FLEURS-evaluering viser 63,76 prosent ordfeilrate for norsk. Lavere er bedre, og dette resultatet er dramatisk svakere enn for eksempel dansk med 9,11 prosent og svensk med 7,27 prosent i samme tabell. Nøyaktig hvorfor det norske resultatet er så dårlig, fremgår ikke av modellkortet.
Modellen har også norske resultater for taleoversettelse, men en oversettelsestest dokumenterer ikke god norsk transkripsjon. Den sier heller ingenting sikkert om norske dialekter, støyende møter eller overlappende tale. Jeg har ikke testet denne modellen selv, så den ærlige vurderingen er enkel: Norsk finnes i materialet, men Nvidias egne tall gjør at jeg ikke ville valgt den til norsk produksjon uten en ordentlig evaluering på virksomhetens egne opptak.
Kan du kjøre modellen lokalt?
Ja, vektene er tilgjengelige i BF16, FP8 og NVFP4, og modellen kan brukes kommersielt eller ikke-kommersielt under OpenMDW 1.1-lisensen. «Åpne vekter» betyr likevel ikke at alle maskiner er et fornuftig mål. Nvidias dokumenterte vLLM-oppsett bruker én H100 med 80 GB minne, og det er dette oppsettet utviklere kan regne med at hurtigstarten faktisk dekker.
Nvidia oppgir at en optimalisert NIM-utgave på ett RTX PRO 6000 Blackwell Server Edition-kort kan behandle opptil 2 238 sekunder lyd per sekund og returnere et 30-sekunders opptak på 0,13 sekunder. Det er voldsom gjennomstrømning. Men selskapet presiserer også at disse optimaliseringene ikke var med i open source-utgivelsen ved lansering, og at NeMo Speech-integrasjonen var ventet å være omtrent dobbelt så langsom.
Modellen kan serveres bak et OpenAI-kompatibelt endepunkt med vLLM eller kjøres direkte gjennom Hugging Face Transformers. Nvidia har lagt taleintegrasjonen i NeMo Speech, mens modellkortet viser de konkrete kommandoene og anbefaler temperatur 0 uten reasoning for transkripsjon. For en bedrift betyr lokal kjøring mer kontroll over lydfilene, men også ansvar for GPU-kapasitet, sikkerhet, logging og vedlikehold.
Hvem er modellen faktisk for?
Nemotron 3.5 Transcribe passer best når du har mange ferdige lydfiler og trenger mer struktur enn ren tekst. Møteplattformer kan bruke talermerking og tidsstempler. Mediebedrifter kan søke i lange opptak. Kundesentre kan analysere samtaler i etterkant, og fagmiljøer kan gi modellen en ordliste som hjelper den med navn og terminologi.
Den passer dårligere dersom hovedkravet er en responsiv taleagent. Da trenger du en streamingmodell og en hel kjede for avbrytelser, tur-taking og lav forsinkelse. Nvidias nye modell kan fortsatt brukes etter samtalen til bedre dokumentasjon eller analyse, men den erstatter ikke sanntidsdelen. Muse Voice Transcribe viser hvor tett talegjenkjenning og endpointing må arbeide når systemet skal vite når et menneske er ferdig med å snakke.
For norske organisasjoner kommer en ekstra beslutning før maskinvaren: Er kvaliteten god nok på den lyden dere faktisk har? Det publiserte norske FLEURS-resultatet sier nei til å anta det. En avgrenset evaluering bør måle ordfeil, navn, tall, faguttrykk og talerbytter på representative opptak. Først da er det mulig å sammenligne kostnad og kvalitet mot en mindre modell eller en ferdig API-tjeneste.
Min vurdering av Nemotron 3.5 Transcribe
Dette er en seriøs modell for offline lydarbeid. En times kontekst, tekststyrt transkripsjon, talermerking, tidsstempler og muligheten til å stille spørsmål til opptaket gir utviklere mye å bygge med. At vektene finnes i flere presisjoner og kan kjøres bak et kjent API-format, gjør modellen mer praktisk enn en forskningsdemo.
Men Nvidia slipper ikke en direkte ElevenLabs-konkurrent for levende samtaler. Ordet «voice» dekker etter hvert så mye at det lett blir grøt. Nemotron 3.5 Transcribe er først og fremst en svært kraftig dokumentleser for lydfiler. Det er nyttig. Det er bare noe annet enn en taleagent som hører deg her og nå.
For norsk er dommen enkel: dokumentasjonen er for svak. Språket står på listen, men en ordfeilrate på 63,76 prosent i Nvidias egen FLEURS-test er ikke en liten fotnote. Inntil bedre norsk dokumentasjon eller gode uavhengige tester finnes, bør modellen vurderes på styrken den faktisk har dokumentert: avansert behandling av lange opptak, særlig i språkene der Nvidia viser produksjonsklare resultater.
Ofte stilte spørsmål
Er Nemotron 3.5 Transcribe gratis å bruke?
Vektene kan lastes ned og brukes kommersielt eller ikke-kommersielt under OpenMDW 1.1-lisensen. Det betyr ikke at driften er gratis. Du må fortsatt betale for maskinvare, strøm, lagring og arbeidet med å sette opp og vedlikeholde løsningen.
Kan Nemotron 3.5 Transcribe brukes til møter?
Ja. Modellen er laget for ferdige opptak og kan levere transkripsjon, talermerking og ordtidsstempler. Nvidia støtter opptak på opptil én time. Kvaliteten må likevel måles med de aktuelle språkene, mikrofonene og møteforholdene før produksjonsbruk.
Støtter Nvidia Nemotron 3.5 Transcribe norsk?
Norsk er oppført blant de 40 språkene, men Nvidia plasserer det på nivået «Supported» og spesifiserer ikke vanlig ASR-støtte i språkmatrisen. En publisert FLEURS-test viser 63,76 prosent ordfeilrate, så dokumentasjonen støtter ikke en påstand om god norsk kvalitet.
Kan modellen brukes i en taleagent med lav forsinkelse?
Ikke som sanntidsmotor. Nemotron 3.5 Transcribe er en offline-modell som behandler opptak, og Nvidia sier uttrykkelig at intern oppdeling av lyd ikke gjør den til streaming-ASR. Den kan brukes til analyse etter samtalen, mens live tale krever en egen streamingmodell.