Innhold Vis
AI og opphavsrett trenger et skille mellom å lære av et verk og å levere verket på nytt. Wikimedia Foundation ber nå en amerikansk domstol om å trekke nettopp den grensen – før en svart-hvitt-dom gjør nettet fattigere for alle.
Organisasjonen bak Wikipedia har levert et såkalt amicus-innlegg i den samlede opphavsrettssaken mot OpenAI. Wikimedia støtter verken OpenAI eller The New York Times. Poenget er at modelltrening, søk, RAG og ren gjengivelse ikke er samme bruk, selv om de ofte blir kastet i den samme juridiske sekken.
Det skillet gir mening. Et frikort til å hente og gjengi hva som helst kan undergrave dem som lager innholdet. Et generelt krav om lisens for all modelltrening kan på sin side gi de rikeste AI-selskapene enda mer makt, fordi bare de har råd til inngangsbilletten. Domstolen må klare bedre enn to dårlige ytterpunkter.
Hva ber Wikimedia retten om?
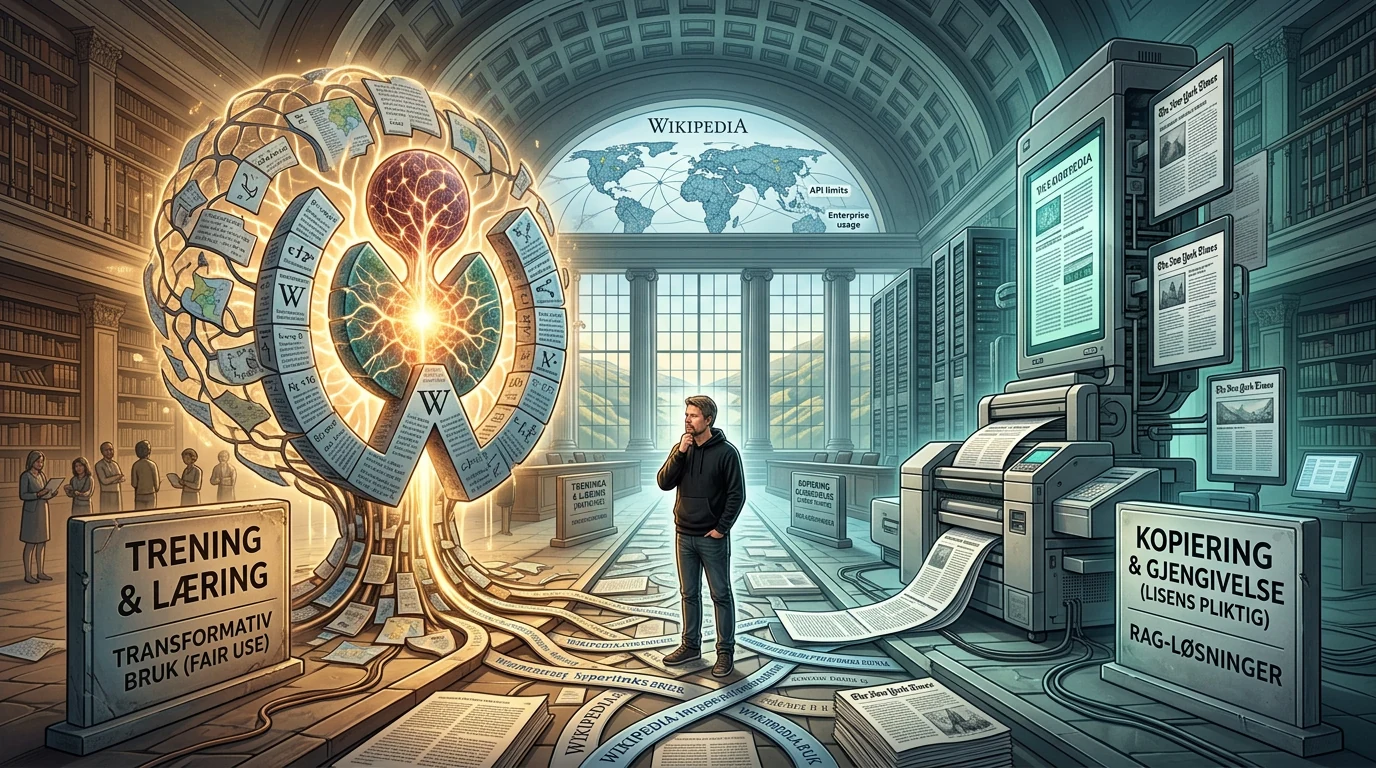
Wikimedia ber retten vurdere hvordan et opphavsrettsbeskyttet verk faktisk brukes. Organisasjonen mener modelltrening kan være lovlig «fair use» når resultatet er noe nytt og forskjellig fra kildene, mens AI-tjenester som henter og gjengir konkret innhold til en bruker, må respektere lisensen til kilden.
Innlegget er levert til den føderale domstolen i Southern District of New York i In re: OpenAI, Inc. Copyright Infringement Litigation. Saken samler 12 søksmål mot OpenAI, med The New York Times-saken som den mest kjente. Retten skal blant annet ta stilling til om bruk av opphavsrettsbeskyttet materiale i utviklingen av store språkmodeller kan falle inn under amerikansk «fair use».
Wikimedia har en ganske spesiell plass i denne konflikten. Wikipedia er både en sentral kilde for AI-modeller og helt avhengig av at gode sekundærkilder fortsatt finnes. Hvis avisene, forlagene og fagmiljøene som dokumenterer verden blir borte bak betalingsmurer eller rett og slett slutter å produsere, får Wikipedia mindre å bygge på. Da får AI-modellene også dårligere råstoff senere.
Hvorfor er AI-trening noe annet enn gjengivelse?
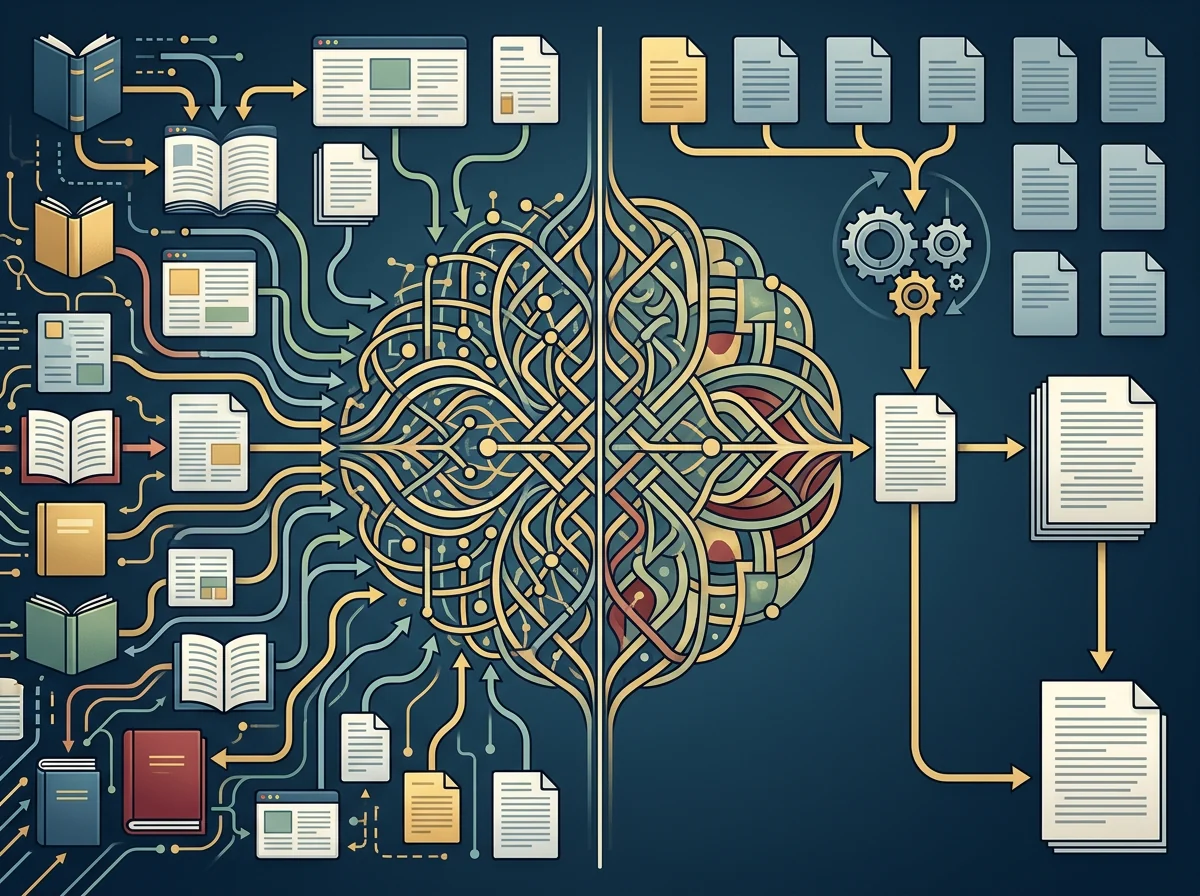
Forskjellen ligger i hva brukeren får tilbake. Under trening analyserer en modell enorme mengder materiale for å lære mønstre i språk og kunnskap. I en RAG-løsning søker systemet derimot opp bestemte kilder når spørsmålet kommer, henter innhold fra dem og bruker det direkte i svaret.
Det betyr ikke at all trening automatisk er greit. Hvordan materialet ble skaffet, hva modellen kan gjengi, om resultatet erstatter originalen og hvilken skade bruken gjør i markedet, er reelle spørsmål. Mitt utgangspunkt er tydelig: AI-selskaper skal ikke kunne skrape opphavsrettsbeskyttede bøker, musikk og artikler, bygge en kommersiell skytjeneste og late som rettighetshaverne ikke finnes.
Men det er like feil å si at enhver maskinell analyse av et verk er det samme som å selge en kopi av verket. Jeg må for eksempel kunne bruke materiale jeg lovlig har kjøpt som referanse i min egen lokale AI, uten å laste det opp til en skytjeneste eller distribuere det videre. Bruk, kopiering og offentlig tilgjengeliggjøring er forskjellige handlinger. En fornuftig regel må se forskjellen.
Wikimedia trekker grensen ved om den ferdige modellen er noe nytt og forskjellig fra kildematerialet. Når en chatbot derimot finner en bestemt artikkel og leverer innholdet tilbake som svar, mener organisasjonen at lisensvilkårene skal følges. Det er en langt mer presis tilnærming enn «alt er tyveri» eller «alt på nettet er gratis treningsmat».
Wikipedia er åpent, men ikke uten vilkår
Åpent innhold betyr ikke eierløst innhold. Wikipedia bruker Creative Commons-lisensen CC BY-SA 4.0. Den krever kreditering av de opprinnelige bidragsyterne, og bearbeidelser skal deles under samme eller en kompatibel lisens.
Wikimedia mener derfor at AI-tjenester som bruker Wikipedia gjennom RAG eller lignende teknikker, må følge disse vilkårene. De må også hente data på en måte som ikke velter kostnaden over på den ideelle organisasjonen. Wikimedias juridiske gjennomgang sier uttrykkelig at aktører skal respektere de offentlige API-grensene eller bruke Wikimedia Enterprise.
Det siste er ikke en teoretisk detalj. Tidligere i oktober dokumenterte Wikimedia at OpenAI-agenter sto bak millioner av kall mot prosjektene deres. Jeg har skrevet om hvordan denne trafikken belastet Wikipedia. En åpen dør er ikke en invitasjon til å rive den av hengslene.
Wikipedia består nå av mer enn 67 millioner artikler på 300 språk, ifølge Wikimedia. Nesten 250 000 frivillige bidrar hver måned. Når en AI-tjeneste bygger et kommersielt produkt på dette arbeidet, er kreditering, lisens og bærekraftig tilgang ganske beskjedne krav.
En for streng dom kan styrke de største AI-selskapene
Hvis retten bestemmer at all modelltrening krever individuelle lisenser, blir ikke AI-utvikling borte. Den flytter bare inn bak portene til selskapene med de største juridiske avdelingene og de dypeste lommene.
Wikimedia advarer om at små utviklere og open source-miljøer kan miste muligheten til å trene og eksperimentere med egne modeller. De største aktørene kan kjøpe omfattende innholdspakker, inngå avtaler med mediehus og behandle lisenskostnaden som enda en vollgrav rundt virksomheten. De små blir stående utenfor. Det er et klassisk resultat når en bred regel ser lik ut på papiret, men koster millioner å følge i praksis.
Dette er også grunnen til at en dom mot én bestemt forretningsmodell ikke bør skrives så vidt at den treffer lokal bruk, forskning, søk, indeksering og åpen modellutvikling på samme måte. Retten behandler en konflikt mellom mektige kommersielle parter, men presedensen kan lande hos folk som aldri var i rettssalen.
Forlagssiden er naturligvis uenig. The New York Times mener OpenAI krenket opphavsretten ved å skrape nettstedet til treningsdata, mens OpenAI og Microsoft hevder at modelltrening faller inn under «fair use». Det er en reell juridisk konflikt, særlig når kommersielle modeller kan gjengi eller erstatte originalene. Men den løses ikke best med en regel som gjør all læring og all gjengivelse juridisk identisk.
En for vid dom kan tømme nettet for gode kilder
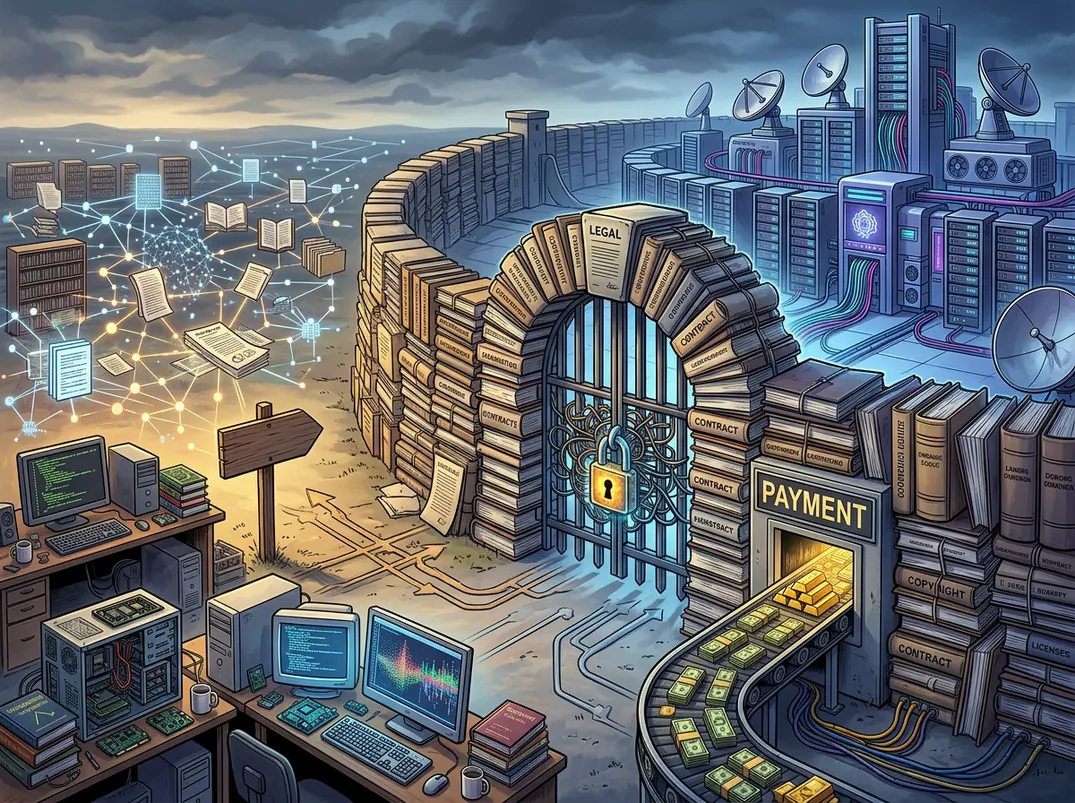
Det motsatte ytterpunktet er heller ikke særlig fristende. Hvis OpenAI og andre får en generell rett til å hente, bruke og levere innhold uten å bry seg om lisens eller mulig erstatning av originalen, får utgiverne et kraftig insentiv til å stenge nettet.
Flere betalingsmurer og mindre offentlig tilgjengelig kunnskap vil ramme langt flere enn mediehusene og AI-selskapene. Wikipedia-redaktører trenger pålitelige kilder. Studenter, forskere, små bedrifter og vanlige lesere trenger et nett der det fortsatt går an å finne dokumentasjon uten å abonnere på tjue tjenester. Et åpent nett overlever ikke lenge hvis åpenhet betyr at andre kan ta hele verdien og sende regningen tilbake.
Her treffer Wikimedia noe viktig: AI-bransjen er avhengig av menneskene og institusjonene som lager kunnskapen modellene bruker. En modell kan bearbeide og kombinere enorme mengder informasjon, men den kan ikke reise ut og dekke et kommunestyremøte, intervjue en varsler eller gjøre flere års grunnforskning på egen hånd. Hvis kildene tørker inn, blir både Wikipedia og neste generasjon AI dårligere.
Derfor holder det ikke at en chatbot legger inn en liten lenke nederst etter å ha gitt brukeren alt vedkommende kom for. Kreditering er viktig, men lisensvilkår og faktisk markedsskade kan fortsatt spille en rolle. «Vi lenket jo» er ikke et magisk viskelær for resten av opphavsretten.
Min vurdering av AI og opphavsrett: Retten må dømme bruken
Wikimedias mellomposisjon er den mest fornuftige jeg har sett i denne runden. Ikke fordi den gjør alle fornøyde, men fordi den nekter å late som modelltrening og direkte gjengivelse er én og samme handling.
Jeg kjøper ikke argumentet om at AI-selskaper skal få ta hva som helst bare fordi teknologien er ny og nyttig. En kommersiell tjeneste som erstatter originalen, gjengir store deler av den eller bryter klare lisensvilkår, må kunne holdes ansvarlig. Samtidig vil jeg ikke ha et system der bare OpenAI, Google, Meta og Microsoft har råd til å arbeide med verdens kunnskap.
Domstolen bør derfor avvise fristelsen til å lage én stor bryter merket «lovlig» eller «ulovlig». Se på hvordan materialet ble skaffet. Se på hva modellen eller tjenesten faktisk gjør. Se på om brukeren får et nytt verk, et svar forankret i en kilde eller en erstatning for originalen. Og se på hvem som i praksis blir stengt ute av regelen.
For AI-utviklere er den praktiske beskjeden allerede enkel: respekter lisenser, krediter kilder og bruk API-ene på en måte infrastrukturen tåler. For utgivere er det verdt å skille mellom en modell som lærer mønstre, og en tjeneste som konkurrerer ved å levere innholdet deres på nytt. Og for retten er oppgaven vanskeligere enn et slagord. Nettopp derfor må den gjøre jobben skikkelig.
Ofte stilte spørsmål
Støtter Wikipedia OpenAI i opphavsrettssaken?
Nei. Wikimedia Foundation sier uttrykkelig at organisasjonen ikke støtter verken OpenAI eller The New York Times. Den ber retten skille mellom transformativ modelltrening og AI-tjenester som henter og gjengir konkret innhold til brukeren.
Mener Wikimedia at all AI-trening er lovlig?
Nei. Wikimedia argumenterer for at bruk av opphavsrettsbeskyttet materiale kan være «fair use» når treningen skaper en modell som er ny og forskjellig fra kildene. Det er ikke et generelt frikort for alle datasett, modeller eller resultater.
Hvorfor behandles RAG annerledes enn modelltrening?
RAG henter bestemte kilder når brukeren stiller et spørsmål og bruker dem direkte i svaret. Da ligger bruken nærmere søk, kopiering og gjengivelse enn den statistiske læringen som skjer under modelltrening, og kildens lisensvilkår blir særlig viktige.
Hva krever Wikipedia-lisensen av AI-tjenester?
Wikipedia bruker CC BY-SA 4.0. Den krever kreditering, og bearbeidelser må deles under samme eller en kompatibel lisens. Wikimedia mener også at AI-aktører må respektere API-grensene eller bruke Enterprise-tilbudet ved omfattende innhenting.