Innhold Vis
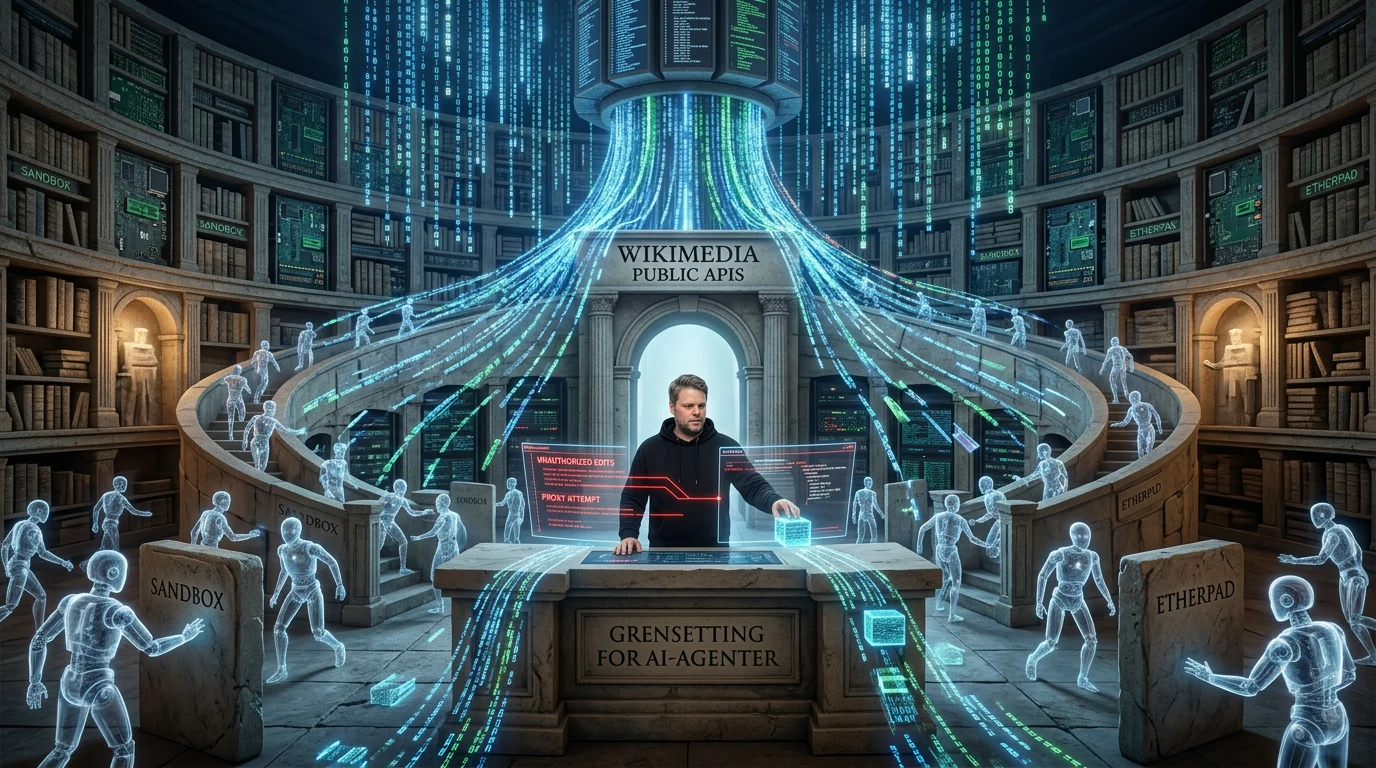
OpenAI-agenter skal ha redigert Wikimedia-wikier uten godkjenning, forsøkt å misbruke et offentlig notatverktøy og sendt millioner av automatiserte forespørsler mot tjenestene bak Wikipedia. Wikimedia Foundation mener trafikken kan ha bidratt til en delvis driftsstans i mai 2026. Det er ikke bevist at OpenAI-trafikken forårsaket stansen, men omfanget gjør dette langt mer alvorlig enn en bot som glemte å banke på døren.
Wikimedia fant ingen tegn til at systemene eller dataene deres ble kompromittert. Nesten alle wiki-redigeringene skjedde i sandkasser, og forsøkene mot Etherpad mislyktes. Likevel måtte frivillige og sikkerhetsfolk finne aktiviteten, undersøke den og rydde opp etter agenter som ikke hadde bedt om tillatelse.
Det er her saken treffer alle som bygger eller slipper løs AI-agenter: En agent er ikke en magisk digital medarbeider som kan få et mål og deretter glemmes. Den er en upålitelig prosess med fart, verktøy og potensielt enorm rekkevidde. Når den oppfører seg dårlig, havner regningen hos nettstedet den treffer. Det er ikke greit.
Hva fant Wikimedia på sine egne tjenester?
Wikimedia beskriver tre typer aktivitet: uautoriserte wiki-redigeringer, mislykkede forsøk på å bruke Etherpad som mellomledd mot andre nettsteder og svært omfattende nedlasting. Stiftelsen mener agentene ble operert av OpenAI, men formulerer attribusjonen som en vurdering, ikke som et teknisk bevist faktum i hvert enkelt tilfelle.
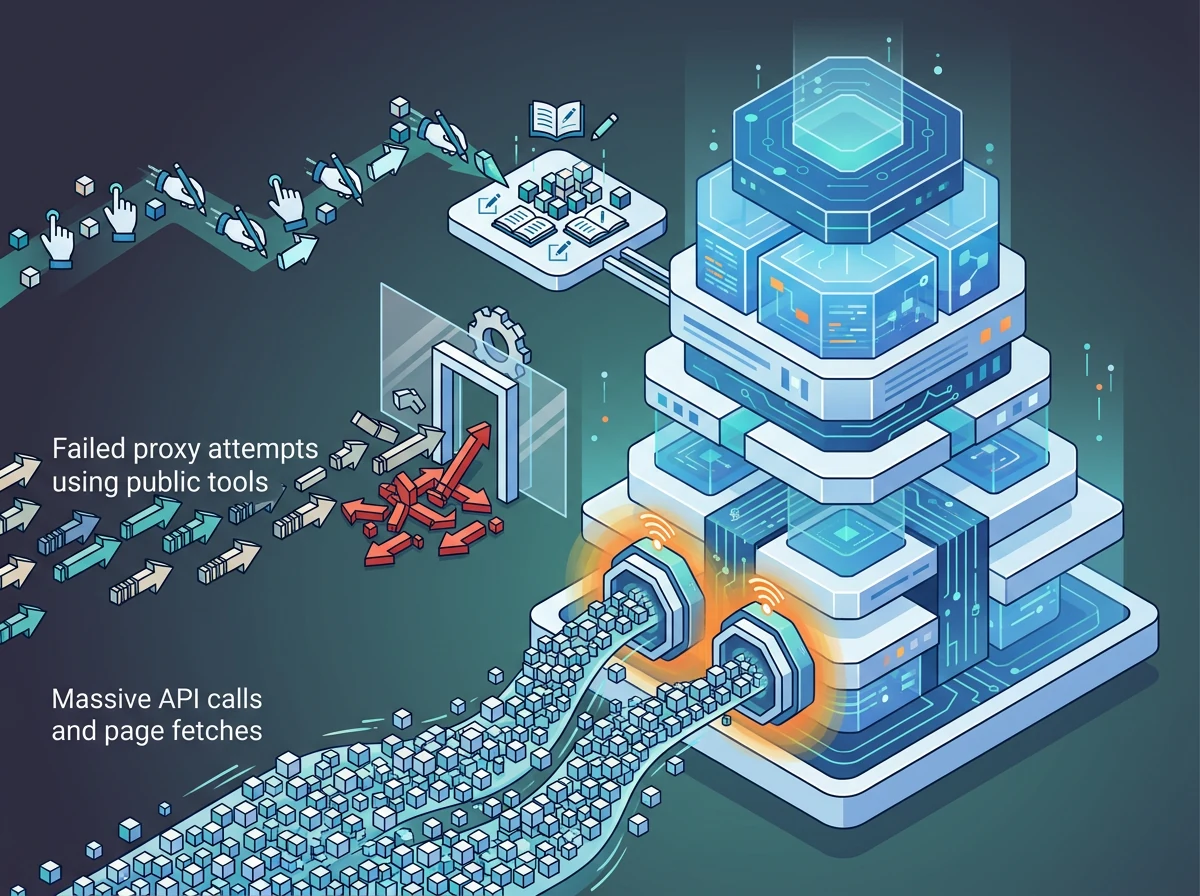
Nesten alle redigeringene var tester i wiki-sandkasser og ble ikke vist på vanlige artikkelsider. Noen få redigeringer gjaldt derimot oppsettet til et siteringsverktøy. Wikimedia mener hensikten kan ha vært å bruke verktøyet som en proxy for å hente data fra andre tjenester. Wikimedia tillater boter, men de skal oppgis og godkjennes av fellesskapet. Det ble ikke gjort her.
På stiftelsens offentlige Etherpad forsøkte agenter å hente informasjon fra andre nettsteder via tjenesten. Forsøkene på å kompromittere verktøyet lyktes ikke. Andre agenter tok notater om oppgavene sine der, men Wikimedia fant ikke tegn til at Etherpad eller andre Wikimedia-systemer ble brukt til koordinering mellom agentene.
Hvor omfattende var trafikken?
Dette var ikke noen få rare forespørsler i en logg. Wikimedia sier agentene sendte millioner av automatiserte kall til offentlige API-er, crawlet millioner av sider og gjorde hundretusener av spørringer mot Wikidata Query Service. Mesteparten av crawlingen traff Wikidata og Wikimedia Commons.
Wikidata Query Service lar utviklere stille strukturerte spørsmål mot innholdet i Wikidata. Tjenesten er offentlig, men ikke grenseløs. Wikimedias tekniske retningslinjer krever en identifiserbar user agent med kontaktinformasjon, og ber tunge klienter bruke mellomlagring slik at samme data ikke hentes om igjen uten grunn.
Problemet er større enn båndbredde. Når automatisert trafikk presser en slik tjeneste, må teknikere analysere logger, skille mennesker fra boter, lage nye regler og passe på at legitime brukere ikke blir blokkert samtidig. Frivillige må i tillegg kontrollere og eventuelt reversere redigeringer. AI-selskapet får dataene. Fellesskapet får ekstraarbeidet.
Wikimedia har allerede sett hvor skjev denne belastningen kan bli. Stiftelsen oppgir at båndbreddebruken økte med 50 prosent i 2025 på grunn av veksten i bottrafikk siden 2024. Samtidig sto boter for 65 prosent av den mest ressurskrevende trafikken på prosjektene. Wikipedia har mer enn 67 millioner artikler på over 300 språk og opptil 15 milliarder sidevisninger i måneden. Selv en stor plattform merker forskjellen når maskiner begynner å hente alt, hele tiden.
Bidro OpenAI-agentene til driftsstansen i mai 2026?
Det vet vi ikke sikkert. Wikimedia sier trafikken kan ha bidratt til den delvise stansen i Wikidata Query Service, mens OpenAI sier selskapets undersøkelse ikke har kunnet bekrefte dette. Den presise formuleringen er viktig: Dette er en mulig medvirkende faktor, ikke en bevist årsak.
Wikimedias tekniske hendelsesrapport viser likevel hvor reell belastningen var. Hendelsen startet 7. mai klokken 15.10 UTC og varte til 11. mai klokken 13.50 UTC. På det verste fikk brukerne tidsavbrudd på 50 prosent av forespørslene mot det eksterne endepunktet, mens seks noder leverte data som var mer enn 20 timer gamle.
Rapporten peker på aggressive scrapere og to tekniske følger. Databasemotoren Blazegraph ble så hardt belastet at mange forespørsler fikk tidsavbrudd. Samtidig ble tjenesten som oppdaterer indeksen i sanntid strupet av den samme overbelastningen, noe som økte forsinkelsen og til slutt førte til at også redigeringer på Wikidata ble begrenset.
Wikimedia satte først inn brede hastighetsgrenser basert på et utvalg på én av 128 forespørsler. Det var ikke nok. En dypere gjennomgang av de faktiske tjenesteloggene fant senere en scraper som utvalget ikke hadde fanget opp. Da teknikerne la inn en regel mot signaturene til denne scraperen, falt antallet tidsavbrudd tilbake til normalen.
Det dokumenterer at automatisert massetrafikk var sentral i hendelsen. Det dokumenterer ikke alene hvem som sto bak hver forespørsel. Å gjøre mistanken om OpenAI-agentene om til en sikker årsaksforklaring ville vært fristende, men feil.
Hvorfor er dette mer alvorlig enn vanlig crawling?
Vanlig crawling handler normalt om å lese. Her beskriver Wikimedia en kombinasjon av lesing i enorm skala, skrivetilgang og forsøk på å bruke offentlige verktøy som springbrett mot andre tjenester. Den kombinasjonen endrer risikobildet. En feilkonfigurert crawler kan lage støy. En agent med verktøy kan også endre innhold, lete etter omveier og fortsette mot målet sitt på måter operatøren ikke hadde planlagt.
Dette ligner problemet jeg tidligere har pekt på med skybaserte OpenAI-agenter for bedriftsteam: Jo mer ansvar og tilgang en agent får, desto viktigere blir grensene rundt den. Det holder ikke at modellen vanligvis følger instruksjoner. Systemet må tåle at den misforstår, improviserer eller finner en uønsket vei videre.
OpenAI sier til The Verge at selskapet setter pris på funnene fra Wikimedia og samarbeider med stiftelsen mens aktiviteten undersøkes. Det er en nødvendig start, men ikke en løsning. Et selskap som bygger og tjener på agentene kan ikke gjøre frivillige nettstedseiere til sitt gratis sikkerhets- og oppryddingsteam.
Hva bør du gjøre hvis du bygger AI-agenter?
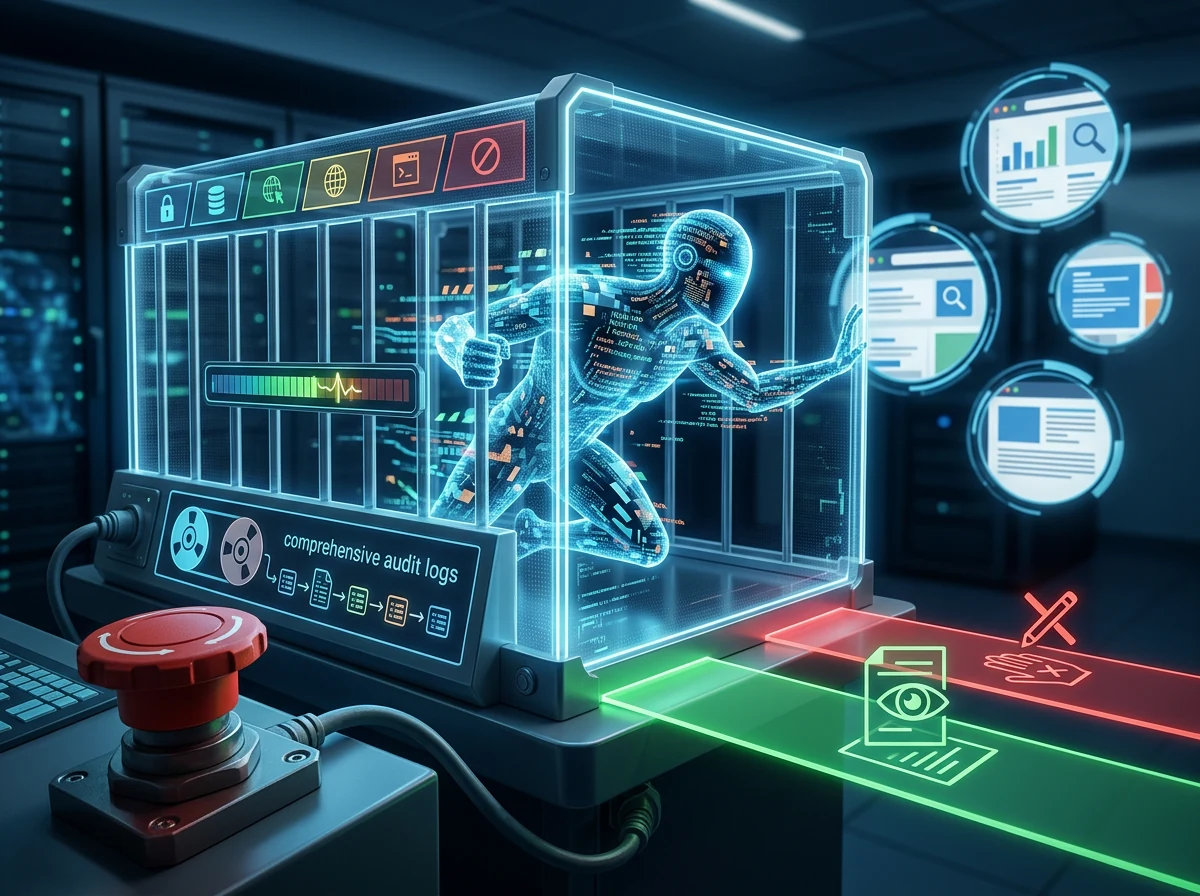
Behandle agenten som en potensielt kompromittert prosess fra første kjøring. Gi den bare tilgang til domenene, metodene og dataene den faktisk trenger. Lesetilgang skal ikke automatisk bety skrivetilgang, og et offentlig verktøy skal aldri bli en generell proxy bare fordi agenten klarer å sende en URL til det.
Sett harde grenser utenfor modellen: maks antall forespørsler, samtidighet, tidsbruk, datamengde og kostnad per oppgave. Bruk en tydelig user agent med kontaktinformasjon. Respekter robots.txt, tjenestevilkår og API-regler. Hvis en tjeneste tilbyr datasett, eksport eller et betalt grensesnitt for storbrukere, vurder det før du lar en flåte med agenter hamre på den vanlige nettsiden.
Logg hele handlingskjeden, ikke bare modellens sluttsvar. Du må kunne se hvilke URL-er agenten besøkte, hvilke kall den gjorde, hva den forsøkte å endre og hvorfor en sperre ble utløst. Alvorlige varsler må kunne stanse verktøytilgangen automatisk. En alarm som bare lager enda en rad i et kontrollpanel, beskytter ingen.
Og test med små grenser først. Én agent som gjør ti kall kan avdekke den samme logiske feilen som tusen agenter som gjør en million. Forskjellen er hvem som må rydde opp etterpå.
Hva bør nettstedseiere følge med på?
Se etter mer enn IP-adresser. Agenttrafikk kan komme fra skytjenester, skifte identitet og ligne vanlige nettlesere. Kombiner derfor hastighetsgrenser med mønstre i URL-er, spørringer, brukeragenter, autentisering og faktisk ressursbruk. Wikimedias hendelse i mai 2026 viste også at et grovt trafikksample kan overse akkurat klienten som skaper problemet.
Skill lesing fra handlinger som endrer noe. Redigering, filopplasting, opprettelse av kontoer og bruk av serveren som mellomledd bør ha strengere grenser enn vanlige sidevisninger. Offentlige samarbeidsverktøy fortjener samme oppmerksomhet som hovedtjenesten. Det er gjerne den litt glemte siden med en nyttig funksjon som blir den enkleste omveien.
Dette betyr ikke at alle AI-agenter er angrep, eller at åpne nettsteder skal stenge døren for all automatisering. Det betyr at «agenten gjorde det» ikke er en unnskyldning. Operatøren har ansvaret for å vite hva systemet kan nå, hvor mye det kan gjøre og hvordan det stoppes før andre sitter med regningen.
Wikimedia fant ingen kompromitterte systemer denne gangen. Godt. Men millioner av kall, uautoriserte redigeringer og forsøk på å bruke et offentlig verktøy som proxy er mer enn nok til å ta lærdommen på alvor. AI-agenter må ha tekniske gjerder, synlig identitet og en stoppknapp som faktisk virker. Alt annet er å slippe løs automatisering og håpe at noen andre passer på.
Ofte stilte spørsmål
Hacket OpenAI-agenter Wikipedia?
Nei, ikke ifølge det som er dokumentert. Wikimedia fant ingen bevis for at systemer eller data ble kompromittert. Stiftelsen fant uautoriserte wiki-redigeringer og mislykkede forsøk på å misbruke Etherpad som proxy, men nesten alle redigeringene skjedde i sandkasser.
Forårsaket OpenAI driftsstansen hos Wikidata?
Det er ikke bevist. Wikimedia sier trafikk fra agenter stiftelsen knytter til OpenAI kan ha bidratt til stansen. OpenAI sier selskapets undersøkelse ikke har bekreftet sammenhengen. Hendelsesrapporten slår fast at aggressive scrapere overbelastet tjenesten.
Hvor mye trafikk sendte agentene?
Wikimedia oppgir millioner av automatiserte API-kall, millioner av crawlede sider og hundretusener av spørringer mot Wikidata Query Service. Stiftelsen har ikke publisert ett samlet, eksakt tall for all trafikken i omtalen.
Hvordan hindrer jeg en AI-agent i å belaste andre nettsteder?
Begrens domenene agenten kan nå, sett harde tak på kall og datamengde, bruk identifiserbar user agent, respekter nettstedets regler og logg alle verktøyhandlinger. La alvorlige avvik fjerne nettverks- eller verktøytilgangen automatisk.