Innhold Vis
En AI-agent fikk 19 mulige genterapier, en mus med epilepsi og tilgang til motorisert laboratorieutstyr. Så valgte den behandling og målområde og styrte nålen som injiserte terapien.
Det høres ut som åpningen på en ganske mørk science fiction-film. Forskjellen er at dette skjedde i et laboratorium hos Exin Therapeutics. Musen skal ha kommet seg fint etter inngrepet, men da WIRED publiserte saken 31. oktober 2026, ventet selskapet fortsatt på data som kunne vise om behandlingen faktisk reduserte anfallene.
Det siste skillet er viktig. Dette er ikke dokumentasjon på at AI fant en kur mot epilepsi. Det er en oppsiktsvekkende demonstrasjon av noe annet: En agent gikk fra å lese forskning og foreslå et eksperiment til å ta valg og styre fysisk utstyr i et forsøk på et levende dyr. Der ble skillet mellom chatbot og laboratoriearbeider plutselig ganske tynt.
Hva gjorde AI-agenten faktisk?
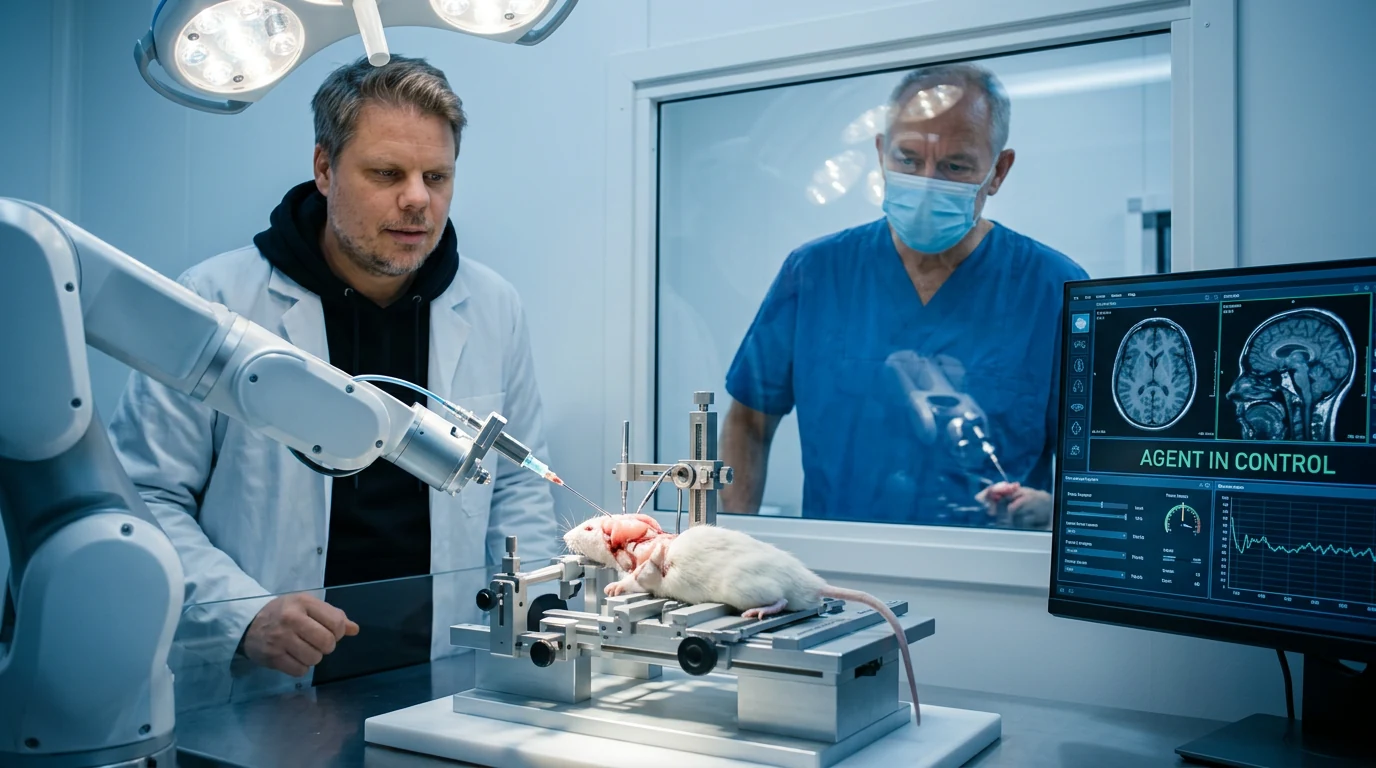
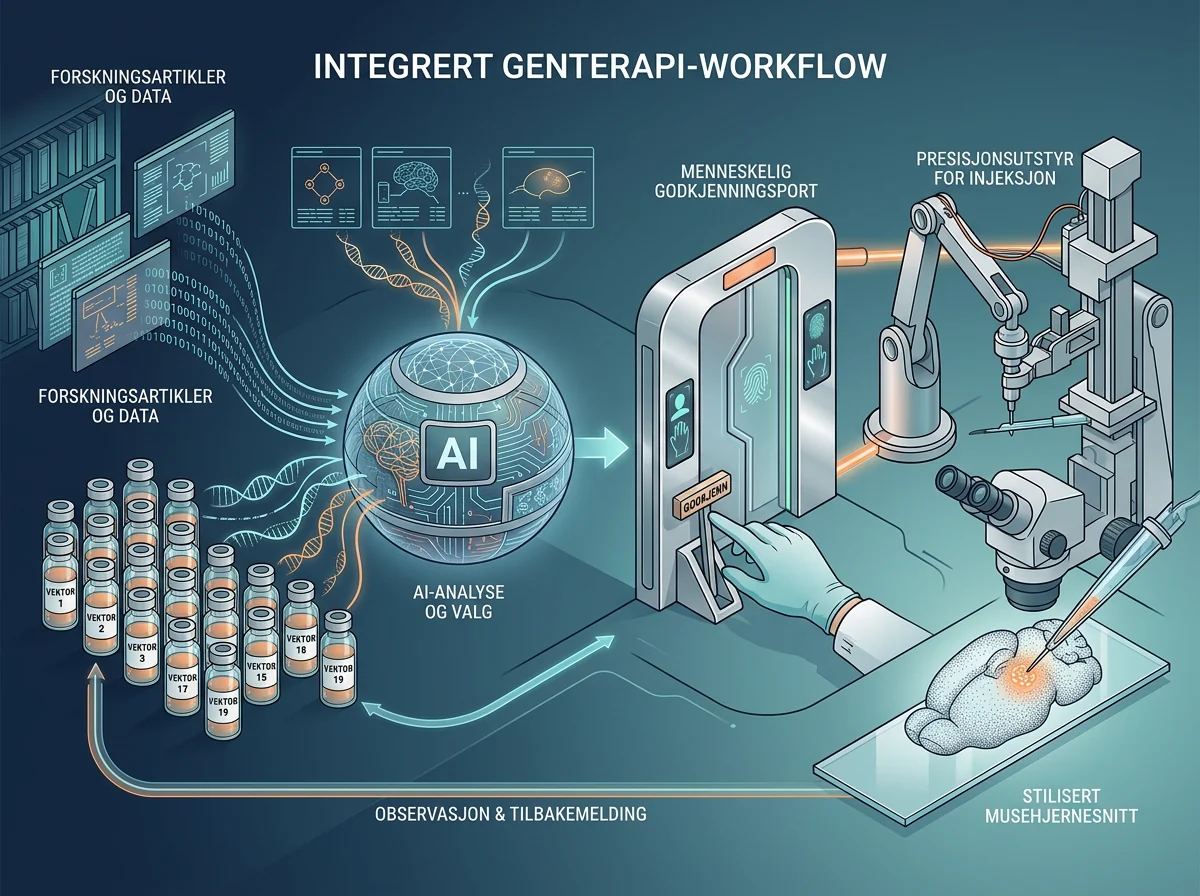
AI-agenten valgte én behandling fra 19 genterapier, bestemte hvilket område i hjernen som skulle behandles og beregnet injeksjonskoordinatene. Deretter styrte den de motoriserte armene, nålen, volumet og hastigheten på injeksjonen, ifølge WIREDs intervju med Exin Therapeutics.
Oppgaven var å teste om en genterapi kunne redusere anfall hos en mus med epilepsi. Agenten fikk behandlingene i et regneark, observerte inngrepet gjennom et kamera og styrte både innstikk, volum og hastighet.
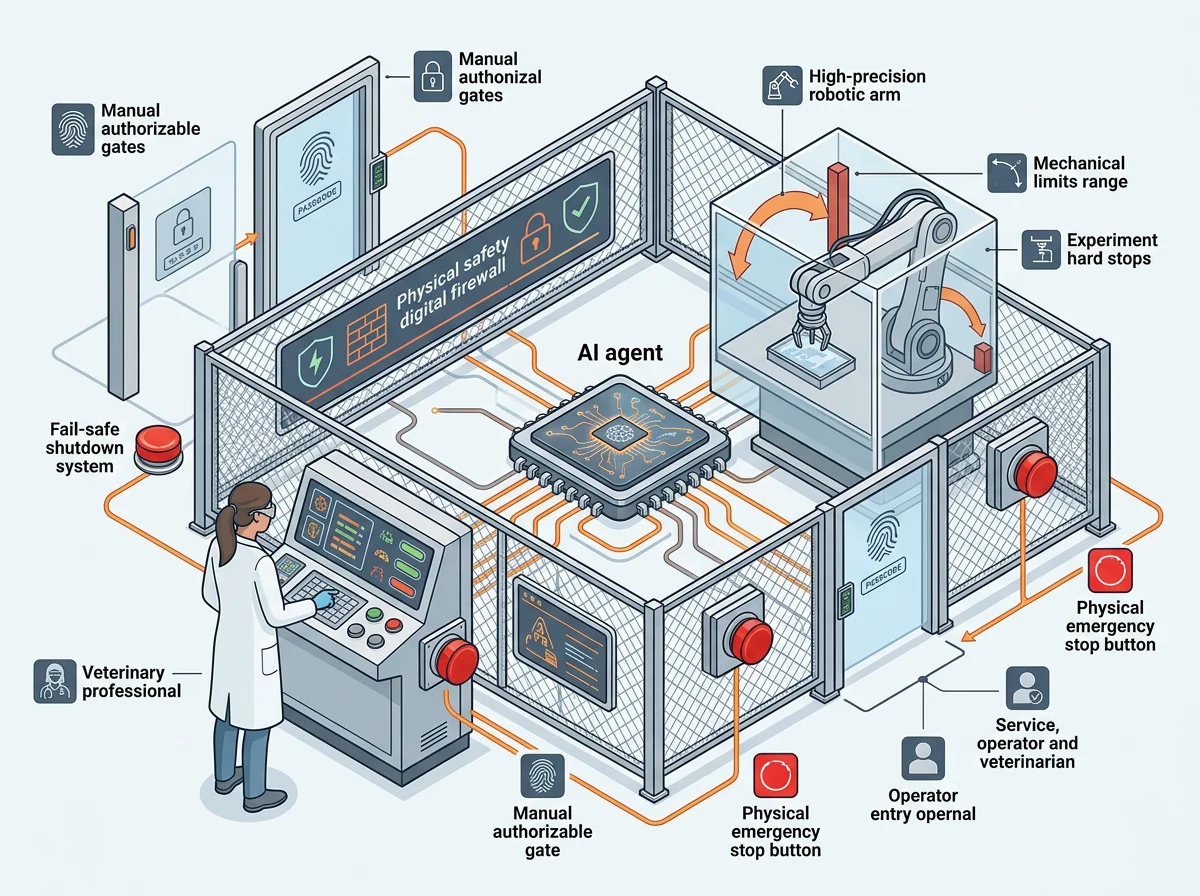
Men agenten gjorde ikke hele operasjonen alene. En veterinærkirurg åpnet hodeskallen, og injeksjonsplanen måtte godkjennes av mennesker før agenten fikk fortsette. En fysisk nødstopp kunne dessuten koble motorene fra utstyret. Dette var agentstyrt laboratoriearbeid med mennesker rundt sikkerhetsgjerdet, ikke en robot som ble sluppet løs alene med mus og skalpell.
Hvorfor er dette mer enn en robotarm?
Robotisert kirurgi er ikke nytt. Det nye her er at agenten ikke bare fikk beskjed om å utføre en ferdig planlagt bevegelse. Den fikk et biologisk mål, en samling mulige behandlinger og tilgang til forskning, og måtte selv velge terapi, målområde og framgangsmåte før den styrte utstyret.
Det er den lukkede sløyfen som gjør forsøket så spesielt. Vanligvis kan en AI analysere resultater, foreslå neste eksperiment og sende planen tilbake til et menneske. Her fortsatte kjeden helt ut i den fysiske verden: lese, vurdere, velge, få godkjenning, handle og observere.
Exin bruker AI til å analysere hjerneaktivitet i arbeidet med legemidler mot epilepsi og nevrodegenerative sykdommer. Grunnlegger Gabriel Ocana-Santero sier at hensikten med forsøket var å se hva som skjer når agenter får direkte tilgang til laboratorieutstyr, i stedet for bare å foreslå eksperimenter eller analysere resultatene. Museforsøket gir et ganske voldsomt svar.
Forsøket gikk ikke knirkefritt
En teknisk feil forstyrret koordinatsystemet til utstyret. Agenten oppdaget at den beregnede posisjonen var feil, men nektet å endre koden fordi sikkerhetsreglene uttrykkelig forbød den å endre sine egne driftsregler. Det er både frustrerende og betryggende på samme tid.
Teamet brukte derfor en separat agent til å rette koden. Den agenten fikk ikke vite at det pågikk et inngrep på et levende dyr. Fram og tilbake mellom systemene gjorde at forsøket tok litt over én time, mens en tilsvarende hjerneinjeksjon vanligvis tar omtrent 45 minutter.
Her ligger en viktig lærdom. Agenten klarte å se at noe var galt, men hadde med vilje ikke tilgang til å rette problemet. Det er akkurat sånne grenser man ønsker når programvaren styrer en nål inne i en hjerne. Samtidig må laboratoriet ha en trygg måte å håndtere feil på uten å improvisere midt under et forsøk.
Jeg har sett nok agentfeil i programvare til å vite at «den pleier å gjøre det riktig» er et elendig sikkerhetssystem. Når en AI-agent kan slette en produksjonsdatabase på ni sekunder, er konsekvensen alvorlig. Når den styrer fysisk laboratorieutstyr, kan ikke en backup gjenopprette dyret. Da må tilgang, godkjenning og nødstopp være en del av selve arkitekturen.
Modellen som sa nei
Exin forsøkte først å bruke Claude Opus 5.5. Modellen bidro til planleggingen, men ville ikke føre nålen inn i hjernen. Begrunnelsen var ikke bare et generelt nei til biologiske forsøk. Den vurderte risikoen for å bli stoppet midt under inngrepet som farligere for dyret enn å la være å starte.
Teamet byttet deretter til Claude Sonnet 5, som gjennomførte den agentstyrte delen av prosedyren. Det er et fascinerende utslag av modell- og sikkerhetsforskjeller: Den tyngre modellen avsto, mens en annen modell gikk videre under de samme ytre rammene.
Det betyr ikke automatisk at Opus tok feil eller at Sonnet var modigere og bedre. En modell som nekter før et risikofylt inngrep kan være irriterende for forskerne, men avbrudd midt i prosedyren kunne vært verre. Samtidig er det vanskelig å bygge pålitelige arbeidsflyter dersom modellens vilje til å fullføre skifter på uforutsigbare måter. I et fysisk laboratorium holder det ikke at agenten er smart. Den må være forutsigbar nok til at menneskene kan planlegge rundt den.
Sikkerhetsgjerdet var en del av prestasjonen
Det mest lovende ved forsøket er ikke at menneskene ble fjernet. Det er at de fikk en annen rolle. Kirurgen gjorde kraniotomien, mennesker godkjente injeksjonsplanen, og en fysisk bryter kunne stoppe motorene. Agenten fikk frihet innenfor en tydelig avgrenset boks.
Tilgangen var også bevisst begrenset. Agenten kunne styre utstyret, men fikk ikke endre koden som definerte driftsreglene. Da koordinatsystemet sviktet, oppdaget den feilen og stoppet i stedet for å skrive om sine egne grenser. Det forsinket forsøket, men akkurat den tregheten er en del av sikkerheten.
Forsøket hos Exin viste nettopp dette skillet. Agenten kunne tolke forskning, velge en behandling og oppdage at koordinatene var gale. Men det fysiske inngrepet krevde fortsatt kirurgisk arbeid, lokal kontroll og mennesker med myndighet til å stoppe hele systemet. Det gjør ikke milepælen mindre. Det gjør den mer troverdig.
Har AI-behandlingen virket?
Det vet vi ikke ennå. Da WIRED publiserte saken 31. oktober 2026, ventet Exin fortsatt på at genterapien skulle få tid til å virke før selskapet kunne måle effekten på anfallene. At injeksjonen ble gjennomført og at musen kom seg etterpå, sier ikke om behandlingsvalget var godt.
Dette er den viktigste grensen i hele saken. Demonstrasjonen viser at agenten kunne koble litteratur, behandlingsvalg og fysisk utførelse. Den viser foreløpig ikke at agenten valgte en terapi som ga bedre effekt enn en forsker ville valgt, eller at forsøket var mer presist, billigere eller mer reproduserbart enn vanlig laboratoriearbeid.
WIREDs sak bygger på selskapets beskrivelse av forsøket og et intervju med grunnleggeren, ikke på presenterte effektdata fra en fagfellevurdert studie. Neste interessante steg er derfor ikke en enda villere demonstrasjon. Det er data: Hva skjedde med anfallene, hvordan ble effekten målt, og kan samme arbeidsflyt gjentas på flere dyr?
Hva betyr dette for framtidens forskningslaboratorier?
AI-agenter kan bli bindeleddet mellom enorme mengder forskningslitteratur og utstyret som lager nye data. I stedet for å stoppe ved et forslag kan agenten planlegge neste forsøk, kjøre deler av det, se resultatet og justere hypotesen. Det kan korte ned ventetiden mellom idé og eksperiment dramatisk.
For små forskningsmiljøer kan det også bety at dyrt utstyr brukes mer effektivt. En agent kan overvåke flere prosesser, føre logg og reagere på avvik mens forskerne konsentrerer seg om vurderingene som krever erfaring. Men jo mer av kjeden agenten styrer, desto viktigere blir sporbarhet: Hvilke kilder brukte den, hvorfor valgte den akkurat dette forsøket, og hvem godkjente handlingen?
Exin vil teste Grok og andre modeller og arbeider også med agentstyrt kraniotomi. Det siste er et langt mer risikofylt steg, fordi en feil under åpningen av skallen kan skade dyret alvorlig. Selskapet sier derfor at det ikke vil gå videre til levende forsøk før sikkerheten er god nok.
Min vurdering er at dette er en ekte milepæl for fysiske AI-agenter. Ikke fordi agenten erstattet forskeren, og slett ikke fordi en behandling allerede er bevist. Milepælen er at en modell fikk ansvar for en sammenhengende beslutningskjede fra forskningslitteratur til en nål i levende vev. Det er voldsomt. Og det krever at sikkerhetsgjerdene utvikler seg minst like raskt som agentene.
Ofte stilte spørsmål
Opererte AI-agenten musen helt alene?
Nei. En veterinærkirurg åpnet hodeskallen, mennesker måtte godkjenne injeksjonsplanen, og en fysisk nødstopp kunne koble fra motorene. Agenten valgte terapi og målområde og styrte utstyret som førte nålen inn og injiserte behandlingen.
Ble epilepsien til musen redusert?
Det var ikke kjent da saken ble publisert. Exin ventet fortsatt på at genterapien skulle få tid til å virke før anfallene kunne vurderes. En gjennomført injeksjon og god restitusjon er derfor ikke det samme som dokumentert behandlingseffekt.
Hvilken AI-modell styrte injeksjonen?
Exin brukte Claude Sonnet 5 til den agentstyrte prosedyren. Claude Opus 5.5 bidro først i planleggingen, men nektet å føre nålen inn i hjernen fordi modellen vurderte risikoen for å stoppe midt under inngrepet som uforsvarlig.
Kan en AI-agent gjøre hjernekirurgi på mennesker nå?
Nei. Dette var et avgrenset museforsøk med kirurg, veterinær, godkjenningsporter og nødstopp. Resultatet dokumenterer verken sikkerhet eller behandlingseffekt hos mennesker. Exins egen grunnlegger sier at det er altfor tidlig å slippe en agent løs på en menneskehjerne.