Innhold Vis
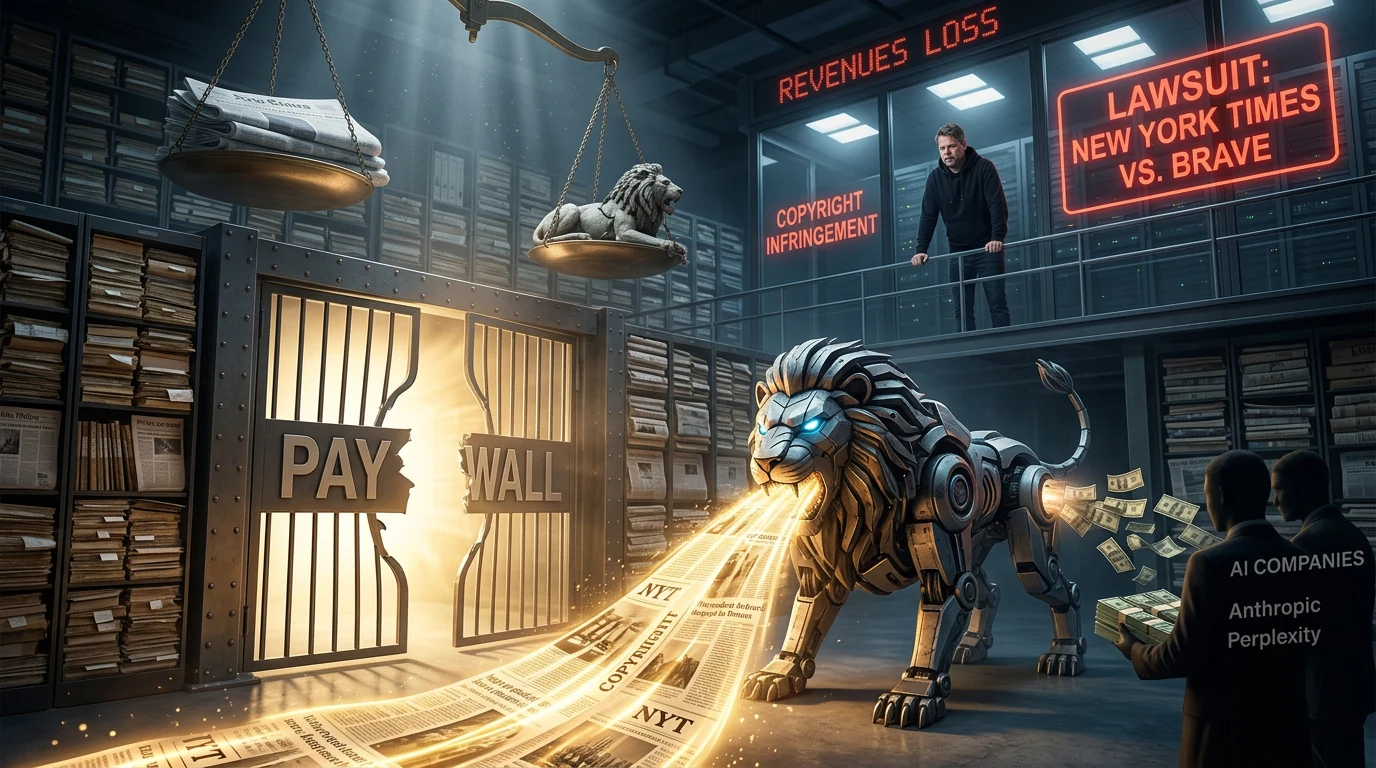
New York Times og tre andre amerikanske aviser saksøker Brave for påstått AI-skraping, distribusjon av journalistikk til AI-selskaper og omgåelse av betalingsmurer. Det er en fersk konflikt om hvem som kan hente innhold fra nettet, pakke det inn i AI-tjenester og tjene penger på det.
New York Times hevder at Brave har skrapt opphavsrettsbeskyttet innhold og distribuert det ulovlig til kunder som Anthropic, Perplexity, Mistral, xAI og Cohere. Daily News, Chicago Tribune og Orlando Sentinel leverte samme dag et separat søksmål med lignende anklager. Begge sakene ble levert i føderal domstol på Manhattan, ifølge TechCrunchs omtale 2. november.
Dette er påstander i sivile søksmål, ikke fastslåtte lovbrudd. Men hvis beskrivelsen stemmer, er min dom enkel: Det er ikke greit å hente opphavsrettsbeskyttet journalistikk, omgå sperrer og selge tilgangen videre som råstoff for kommersielle AI-tjenester. En løvelogo og et godt rykte for personvern gjør ikke den delen penere.
Hva anklages Brave for?
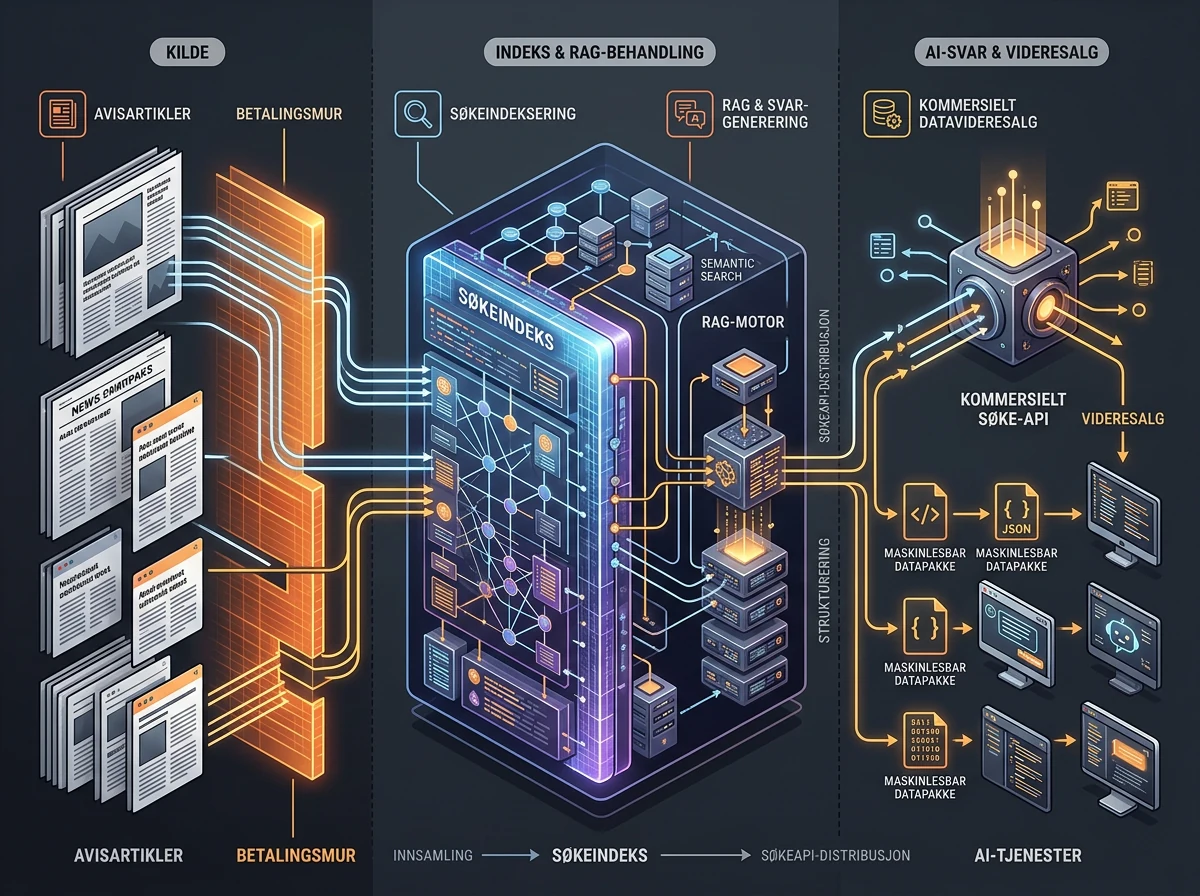
New York Times anklager Brave for å ha bygget en indeks med mer enn 30 milliarder nettsider ved hjelp av en crawler som avisene ikke kunne identifisere eller blokkere. Ifølge søksmålet ble innhold fra denne indeksen distribuert til flere store AI-selskaper. Det gjør konflikten større enn en vanlig krangel om korte tekstutdrag i et søkeresultat.
Søksmålet går også etter en funksjon i Brave-nettleseren som skal kunne omgå betalingsmurer. I tillegg anklages Brave for å blokkere utgivernes annonser samtidig som selskapet selger sine egne. Det er en ganske brutal kombinasjon dersom påstandene kan dokumenteres: Hent innholdet, fjern inntekten rundt det og ta betalt et annet sted.
New York Times ber om erstatning og en rettslig stans av den påståtte praksisen. Brave hadde ikke svart på TechCrunchs henvendelse da saken ble publisert 2. november. Det er derfor viktig å holde språk og tempus presist: Avisene hevder, Brave er saksøkt, og retten har ennå ikke avgjort om praksisen er ulovlig.
Hvorfor AI-selskaper trekkes inn i saken
Anthropic, Perplexity, Mistral, xAI og Cohere navngis som kunder som skal ha mottatt innhold fra Brave. De er ikke saksøkerne i disse to sakene, men navnene viser hvorfor konflikten er relevant for hele AI-bransjen: Mange AI-produkter trenger fersk informasjon fra nettet, og få selskaper ønsker å bygge en komplett søkeindeks selv.
Da oppstår en forsyningskjede for data. Én aktør crawler og indekserer nettet, en annen kjøper tilgang, og en AI-tjeneste lager svaret som brukeren ser. Det kan være effektivt, men ansvaret forsvinner ikke bare fordi dataene går gjennom flere ledd. En faktura fra en leverandør er ikke det samme som dokumentasjon på at alle rettigheter oppstrøms er avklart.
Det er også her søksmålet skiller seg fra den gamle forestillingen om en søkemotor som bare viser en tittel, en lenke og noen få ord. Avisene beskriver Brave som et kommersielt mellomledd som distribuerer innhold til AI-selskaper. Brave vil få anledning til å bestride både faktabeskrivelsen og den juridiske konklusjonen, men selve spørsmålet er svært konkret: Hvor kommer materialet fra, og hva har leverandøren faktisk lov til å gjøre med det?
For AI-kunder er det lett å tenke at leverandøren får ta den juridiske støyten. Så enkelt er det ikke alltid i praksis. Selv når en kunde ikke har styrt crawleren, kan et produkt bli avhengig av data som senere må fjernes, begrenses eller lisensieres på nytt. Da er dette også et spørsmål om drift, leverandørrisiko og hvor lett det er å bytte datakilde – ikke bare om hvem som til slutt vinner i retten.
To søksmål kom samme dag
New York Times leverte det ene søksmålet. Daily News, Chicago Tribune og Orlando Sentinel leverte det andre. At fire aviser går til retten samme dag med lignende anklager, gjør dette til en ny hendelse i opphavsrettsstriden rundt AI, ikke bare en ny omtale av de gamle sakene mot modellutviklere.
New York Times har allerede saksøkt OpenAI og Perplexity i andre konflikter om bruk av avisinnhold. Jeg har tidligere skrevet om da New York Times saksøkte Microsoft og OpenAI, og om OpenAIs svar på det søksmålet. Brave-saken er likevel et eget kapittel fordi den retter søkelyset mot aktøren som henter og distribuerer webinnholdet videre.
TechCrunch beskriver New York Times’ karakteristikk av Brave som en leverandør og distributør av stjålet opphavsrettsbeskyttet innhold til AI-selskaper. Det er avisens anklage, ikke en dom. Men formuleringen viser hvor hardt partene kommer til å stå mot hverandre når retten skal skille lovlig indeksering fra ulovlig kopiering og distribusjon.
Dette er ikke det samme som privat, lokal AI-bruk
Opphavsrettsdebatten blir fort grøt fordi helt forskjellige former for bruk legges i samme bolle. Jeg mener det er en klar forskjell mellom å bruke en bok eller artikkel du lovlig har kjøpt som privat referansemateriale i en lokal AI, og å skrape enorme mengder beskyttet innhold for å bygge en kommersiell skytjeneste.
Ved privat lokal bruk holder du materialet på din egen maskin og bruker det for å lære, søke eller finne tilbake til noe du allerede har betalt for. Du publiserer ikke kopien, laster den ikke opp til en fremmed sky og selger ikke tilgangen videre. Det ligner langt mer på å søke i egne notater enn på å etablere en konkurrerende innholdsleverandør.
Den grensen må ikke viskes ut av et slagord om at all AI-bruk er det samme. Hvem som kopierer, hvor mye som kopieres, om materialet holdes privat, hvordan resultatet brukes og om noen tjener penger på distribusjonen, er vesentlige forskjeller. Brave-søksmålene handler om påstått kommersiell innhenting og videre distribusjon, ikke om hva en privatperson gjør lokalt med materiale vedkommende har kjøpt lovlig.
Det betyr heller ikke at «lokalt» automatisk gjør enhver bruk lovlig. Poenget er at omfang, distribusjon og kommersielt formål betyr noe, og at de ikke bør blandes sammen til én enkel AI-debatt. Her er det nettopp den påståtte veien fra avisinnhold til betalte AI-kunder som er kjernen.
Hva bør utviklere og små bedrifter kontrollere?
Du bør ikke kjøpe tilgang til webdata og bare anta at leverandøren har ryddet alle rettigheter. Spør hvor innholdet kommer fra, hvilken crawler som brukes, hvordan utgivernes reservasjoner håndteres, og om tjenesten henter materiale bak innlogging eller betalingsmur. Be også om et tydelig svar på hva du har lov til å lagre, vise videre og bruke til trening.
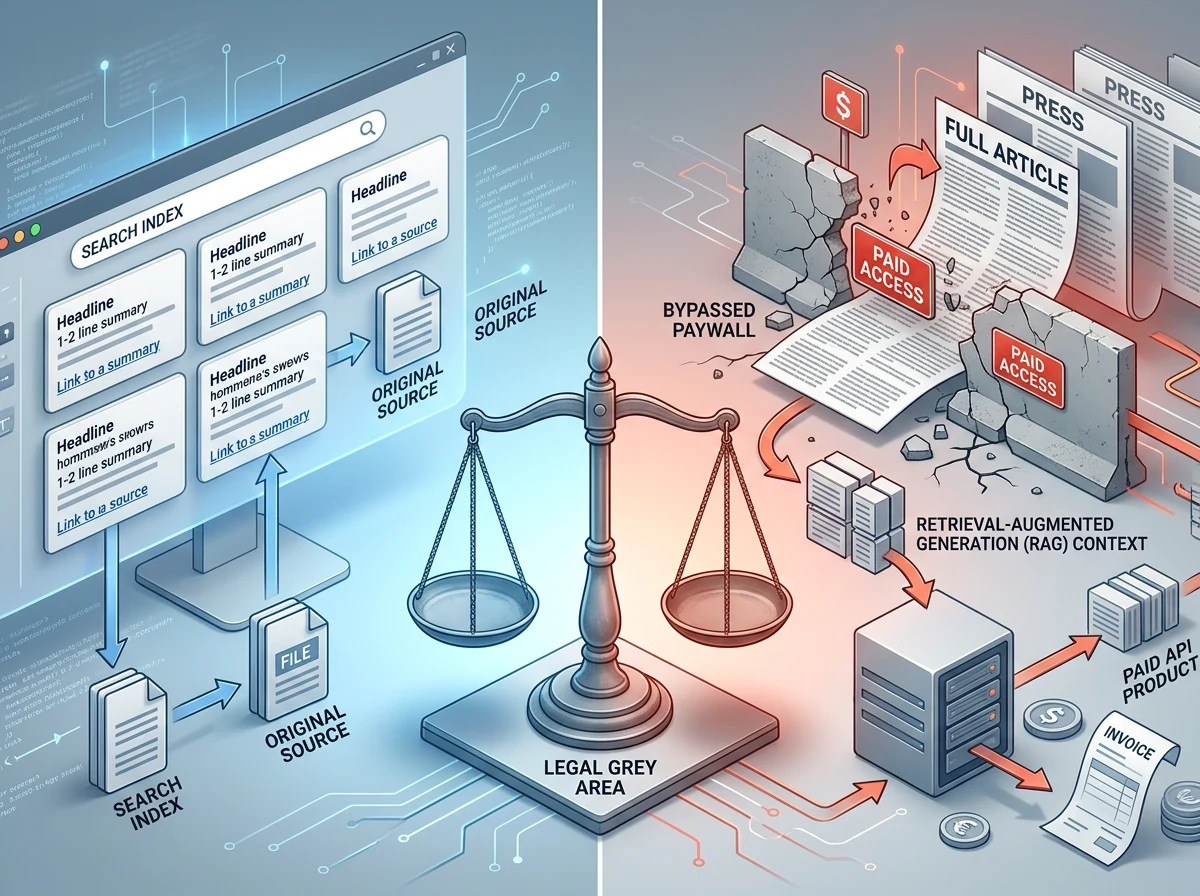
Skill mellom tre ting: et søkeresultat med tittel og lenke, et lengre tekstgrunnlag som brukes til å lage et AI-svar, og et datasett som lagres eller brukes til modelltrening. De har ulik funksjon og ulik risiko. En kontrakt som bare lover «web data» er lite betryggende dersom ingen kan forklare hvordan innholdet ble samlet inn.
Dette er ikke et råd om å slutte å bruke søke-API-er eller ferske webdata. Det er et råd om å gjøre den samme leverandørkontrollen her som du ville gjort med betalingsdata, kundedata eller andre kritiske innsatsfaktorer. Dokumenter kilden og rettighetene før du bygger produktet rundt dem. Det er langt billigere enn å finne ut av det når advokatene har meldt seg på.
Sørg også for at tjenesten kan bytte datakilde uten at hele produktet må bygges på nytt. Det er vanlig, sunn risikostyring.
Personvern gir ikke frikort på opphavsrett
Brave er kjent som en personvernfokusert nettleser, og det er en viktig del av selskapets profil. Men personvern for brukeren og respekt for rettighetene til dem som lager innhold, er to forskjellige prøver. Du kan bestå den ene og stryke på den andre.
Dersom anklagene blir dokumentert, har Brave krysset en tydelig grense. Journalistikk koster penger å lage. Å kopiere den, omgå betalingsmurer og distribuere materialet til kommersielle AI-selskaper blir ikke greit bare fordi sluttproduktet er praktisk eller fordi markedet trenger ferske data.
Samtidig skal dommen komme i retten, ikke i overskriften. Brave får anledning til å svare, og ingen av de to sakene var avgjort 3. november 2026. Men lærdommen for alle som bygger AI-produkter er allerede klar: Ha kontroll på kildene, tilgangsgrensene og rettighetene før du gjør en ekstern dataleverandør til en kritisk del av tjenesten din.
Ofte stilte spørsmål
Har New York Times vunnet saken mot Brave?
Nei. Søksmålet ble levert 2. november 2026, og påstandene var ikke avgjort 3. november. New York Times ber om erstatning og en rettslig stans, mens Brave får anledning til å bestride både faktabeskrivelsen og den juridiske tolkningen.
Hvilke aviser har saksøkt Brave?
New York Times har levert ett søksmål. Daily News, Chicago Tribune og Orlando Sentinel har levert et separat søksmål med lignende anklager. Begge sakene ble levert i føderal domstol på Manhattan 2. november 2026.
Hvilke AI-selskaper nevnes i søksmålet?
Anthropic, Perplexity, Mistral, xAI og Cohere nevnes som kunder som ifølge New York Times skal ha mottatt innhold fra Brave. Det er en påstand i søksmålet, ikke en rettslig avgjørelse om disse selskapenes ansvar.
Hva bør jeg sjekke før jeg kjøper webdata til en AI-tjeneste?
Sjekk hvor dataene kommer fra, hvilken crawler som brukes, om reservasjoner og betalingsmurer respekteres, og hvilke rettigheter du får til lagring, visning og trening. Be om klare avtalevilkår i stedet for å anta at leverandøren har ryddet alt.