Innhold Vis
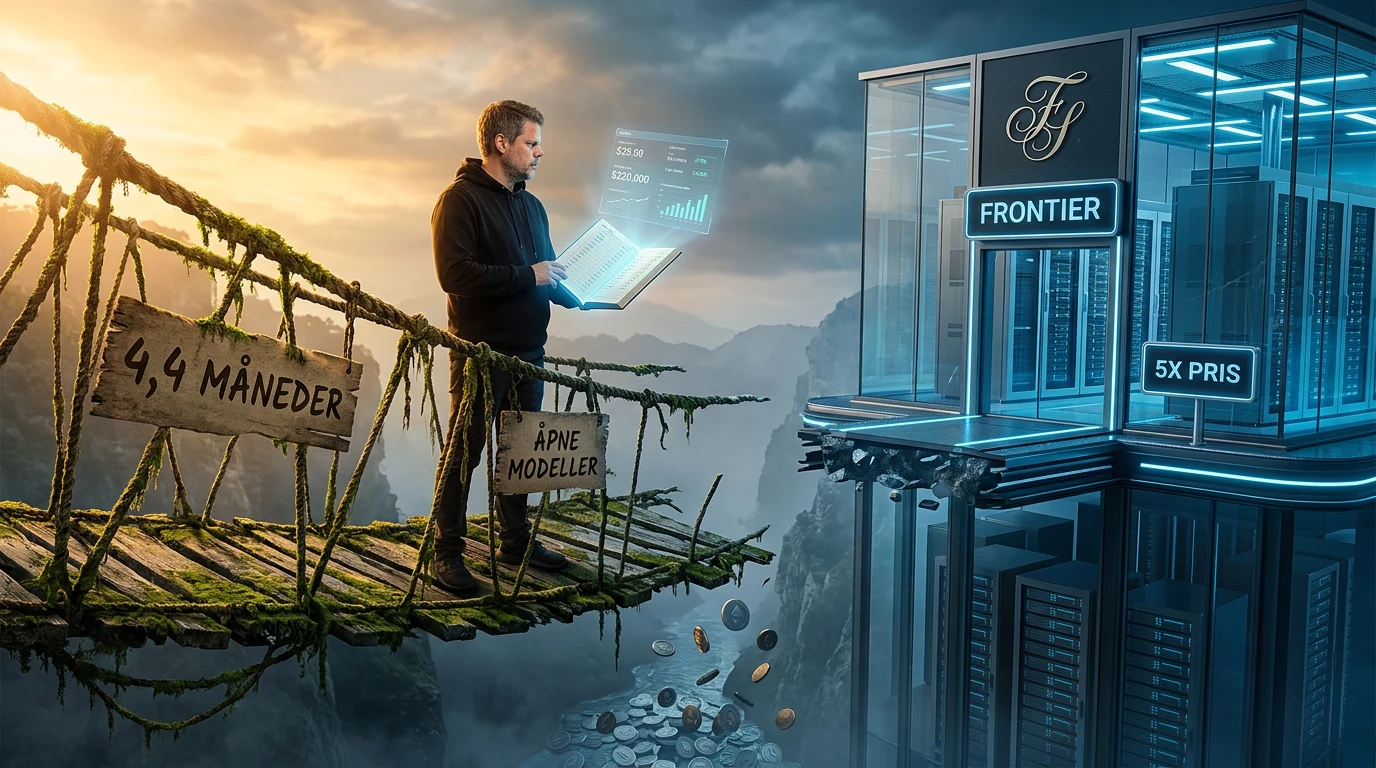
Åpne AI-modeller ligger bare 4,4 måneder bak de beste lukkede frontier-modellene. I en nøytral terminaltest kostet den åpne modellen rundt en femdel per fullførte oppgave. Det er et ganske brutalt regnestykke.
For de fleste bedrifter og utviklere bør derfor en rimelig åpen modell være utgangspunktet, ikke reservehjulet. Den dyreste modellen skal få jobben når den faktisk løser noe den åpne modellen ikke klarer – ikke bare fordi navnet øverst på prislisten føles tryggest.
Det betyr ikke at lukkede frontier-modeller er bortkastet. De har fremdeles et reelt forsprang på de vanskeligste oppgavene, og de kommer ofte med drift, support og kontrollmekanismer ferdig pakket. Men Mozillas nye sammenligning gjør det langt enklere å se nøyaktig hva premien kjøper. For mye vanlig arbeid kjøper den mest en dyr logo på fakturaen.
Hva betyr et forsprang på 4,4 måneder?
Forspranget betyr at den beste åpne modellen i gjennomsnitt når dagens lukkede toppnivå etter omtrent 4,4 måneder. Ars Technica gjengir Mozillas analyse, der det beste lukkede systemet kan håndtere oppgaver som er rundt 1,7 ganger lengre enn det beste åpne systemet klarer pålitelig.
Her må «lengre» forstås riktig. Målet bygger på hvor lang tid en menneskelig fagperson trenger for å gjøre oppgaven, ikke hvor lenge modellen sitter og tygger på den. Hvis en åpen modell pålitelig kan fullføre en oppgave som tar et menneske sju timer, kan frontier-modellen i dette eksempelet klare en tolvtimersoppgave. Fire måneder senere har den åpne modellen tatt igjen tolvtimersnivået, mens frontier-modellen har flyttet seg videre.
Det er altså ikke et løfte om at alle åpne modeller blir like gode som alle lukkede modeller på nøyaktig 4,4 måneder. Det er en målt avstand mellom to bevegelige fronter. Likevel er avstanden kort nok til å endre et innkjøpsvalg: Betaler du fem ganger mer for noe organisasjonen skal gjøre neste kvartal, kan du betale dyrt for et forsprang som er borte før prosjektet er ferdig.

Fem ganger pris gjelder et smalt område
Det brede modellbildet har også flyttet seg. Moonshot AIs Kimi K3 lå i Mozillas septemberrapport bare noen få poeng bak Anthropic Fable 5 på Artificial Analysis Intelligence Index, til 30 prosent av listeprisen. Det er viktig å skille dette fra femgangeren: Den kommer fra en egen terminaltest der alle modellene brukte det samme, uavhengige programvarelaget.
På Terminal-Bench 2.1 scoret kinesiske GLM-5.2 innenfor ett poeng av Claude Opus 4.7 og 4.8, samtidig som GLM kostet omtrent en femtedel per fullførte oppgave. Terminal-Bench tester agenter i kontrollerte terminalmiljøer med oppgaver inspirert av reelle arbeidsflyter.
Det mest oppsiktsvekkende er ikke at en billig modell kan vinne en tilfeldig benchmark. Det er at kostnaden er målt per fullførte oppgave. En modell som er billig per token, men må prøve ti ganger, kan fort bli dyr. Her sammenlignes resultatet som kjøperen faktisk trenger: en jobb som blir gjort.
Samtidig gjelder femgangeren spesielt området der lukkede modeller har et faktisk kapasitetsovertak – oppgaver som tar en fagperson omtrent 8-12 timer. Oppgaver under åtte timer kan de beste åpne modellene allerede håndtere, ifølge Mozilla. Oppgaver over tolv timer klarer ingen av gruppene generelt pålitelig. Det dyre vinduet er dermed reelt, men smalt.
Det er viktigere enn en generell påstand om at «åpent har tatt igjen lukket». Har du en krevende leveranse med frist på fredag, og frontier-modellen er den eneste som kan gjennomføre den nå, er premien lett å forsvare. Skal du klassifisere dokumenter, oppsummere interne tekster eller kjøre en stabil arbeidsflyt i mange måneder, blir samme premie langt vanskeligere å svelge.
Hvorfor må modellene bruke samme programvarelag?
En AI-modell jobber sjelden alene. Rundt den ligger et agentoppsett som gir tilgang til verktøy, minne, filer og regler for hvordan oppgaven skal løses. Dette laget kalles ofte en harness. Det kan påvirke resultatet så mye at en sammenligning av modellnavn alene blir misvisende.
De lukkede modellhusene bygger gjerne egne oppsett rundt sine modeller. De kjenner modellens styrker, kan finjustere instruksjonene og velger verktøyene som får den til å se best mulig ut. Det er ikke nødvendigvis juks, men det betyr at du fort sammenligner to komplette produkter i stedet for to modeller.
Vals AI brukte derfor et nøytralt oppsett for både åpne og lukkede modeller i sammenligningen Mozilla viser til. Det gjør ikke målingen perfekt, men det fjerner en åpenbar skjevhet. Skal en bedrift gjøre sin egen vurdering, bør den følge samme prinsipp: samme oppgaver, samme verktøy, samme antall forsøk og samme krav til godkjent resultat.
Mozillas State of Open Source AI-arbeid peker også på at programvarelaget rundt modellen kan bety mer enn et modellbytte. Det er verdt å ta inn over seg. En dyrere modell reparerer ikke et dårlig agentoppsett, rotete data eller uklare krav. Den gjør bare feilene med et større modellbudsjett.
Frontier-modellen er fortsatt verdt pengene noen ganger
De lukkede toppmodellene forsvarer premien på ekspertarbeid, krevende informasjonsinnhenting og svært lang kontekst. De leveres dessuten som regel med stabil API-drift, support, sikkerhetsfunksjoner og dokumentasjon som en bedrift kan kjøpe i én pakke. For en liten organisasjon uten folk til å drifte modeller kan det være billigere enn å bygge alt selv.
Det siste poenget forsvinner ofte i diskusjonen. Open weights betyr at modellvektene kan lastes ned og kjøres på egen eller leid infrastruktur. Det betyr ikke automatisk at treningsdata, treningskode og hele oppskriften er åpne. Og det betyr slett ikke at drift, overvåking, skalering og feilretting blir gratis.
Valget bør derfor være oppgavespesifikt. En virksomhet er ikke enten «Claude-bedrift» eller «open source-bedrift». Den kan sende rutinearbeid til en rimelig åpen modell, løfte de krevende sakene til en frontier-modell og beholde særlig følsomme oppgaver på egen infrastruktur. Det er langt sunnere enn å skrive én leverandør inn i hele organisasjonens ryggmarg.
Jeg ville heller ikke valgt en kinesisk modell ukritisk bare fordi prisen er lav. Lisens, databehandling, leverandør, hosting og jurisdiksjon må undersøkes. Men skepsis er ikke et argument for å betale fem ganger mer uten å måle resultatet. Det er et argument for å teste grundigere.
Tidsmålet er nyttig, men ikke en fasit
METR definerer en modells 50-prosents tidshorisont som lengden på oppgaver den kan fullføre selvstendig med 50 prosent sannsynlighet, målt mot tiden en menneskelig fagperson bruker. I tidligere analyser fant METR at denne horisonten doblet seg omtrent hver sjuende måned over tid, muligens så raskt som hver fjerde måned i 2024.
Det er et mye mer håndgripelig mål enn enda en poengsum uten sammenheng. En tolvtimersoppgave sier noe om hvor lenge agenten må holde styr på mål, deloppgaver og feil før den leverer. Men 50 prosent suksess er ikke «pålitelig» i vanlig bedriftsforstand. Hvis lønnskjøringen virker annenhver gang, har du ikke automatisert lønnskjøringen. Du har laget en myntkastmaskin med API-nøkkel.
METR understreker også at resultatene varierer mellom fagområder, og at flere av datagrunnlagene er støyete. Programvare- og resonneringsoppgaver passer bedre for tidshorisontmålet enn for eksempel videoanalyse. Tallene kan derfor ikke flyttes ukritisk fra terminaloppgaver til juss, kundeservice eller regnskap.
Den praktiske lærdommen står likevel støtt: Modellgapet bør måles på dine oppgaver. Ikke kjøp en gjennomsnittlig benchmarkseier hvis arbeidsflyten din ligger i den delen av markedet der en langt billigere modell allerede er god nok.
Åpne modeller har gått fra reserve til standardvalg
Utviklingen skjer allerede i faktisk bruk. Mozilla viser til at åtte av de ti mest brukte modellene på OpenRouter, målt i tokenvolum i august 2026, hadde åpne vekter. Det passer godt med den økonomiske logikken: Når modellene nærmer seg hverandre i kvalitet, flyttes trafikken mot alternativet som løser jobben billigst.
Det betyr ikke at inntektene har flyttet seg like raskt. Lukkede modeller tok ifølge materialet 96 prosent av modellinntektene i en tidligere måleperiode fra 2025. De åpne modellene sto bare for 4 prosent. Bruk og penger peker altså i hver sin retning – foreløpig.
Amerikanske og europeiske aktører bør merke seg hvor de åpne alternativene kommer fra. De beste open-weight-modellene er nå i stor grad kinesiske, mens de beste lukkede modellene kommer fra amerikanske selskaper. Konsentrasjon er konsentrasjon uansett hvilket flagg som står på serverrommet. Et større mangfold av åpne modeller vil være bedre enn å bytte én håndfull utleiere med en annen.
Meta viste tidlig med Llama hvor mye en åpen modellutgivelse kan flytte hele markedet. Nå investerer også Nvidia tungt i egne open-weight AI-modeller. Når kapital, utviklerbruk og kvalitet trekker samme vei, må de lukkede modellhusene bevise mer enn at deres nyeste modell ligger øverst på en tabell i noen uker.
Slik bør du velge modell til en arbeidsflyt
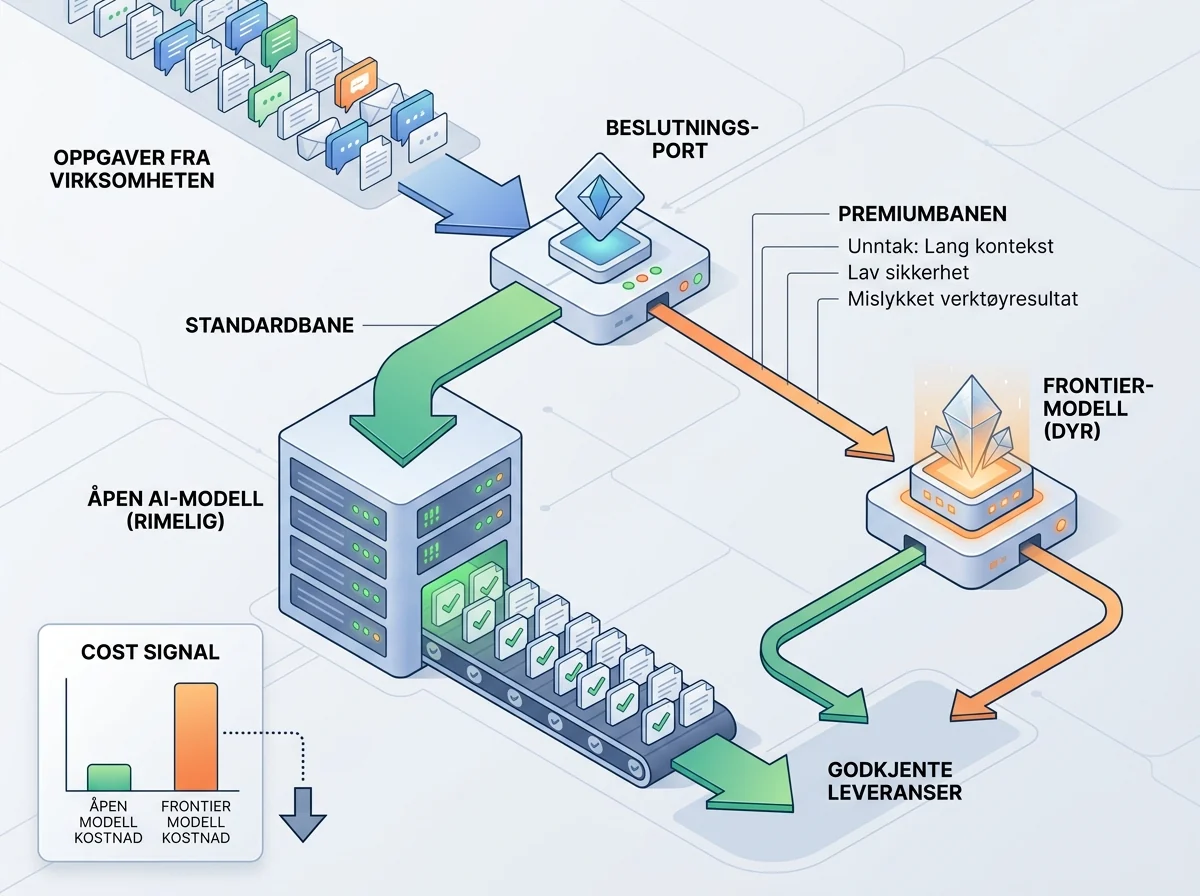
Start med en rimelig modell som kan kjøres gjennom en leverandør du stoler på. Lag et lite evalueringssett med ekte oppgaver, og definer hva et godkjent resultat er før testen begynner. Mål total kostnad per godkjente leveranse, ikke bare pris per million tokens.
Deretter tester du en frontier-modell på nøyaktig samme oppsett. Hvis den reduserer feil, kontrollarbeid eller behandlingstid nok til å forsvare prisforskjellen, bruker du den på akkurat den oppgaven. Hvis resultatene er omtrent like, velger du den rimelige modellen. Dette trenger ikke være mer mystisk.
Bygg modellruting inn i systemet fra starten. En enkel arbeidsflyt kan prøve standardmodellen først og sende saken videre når den møter bestemte kriterier: for lang kontekst, lav sikkerhet, manglende verktøyresultat eller en oppgaveklasse som tidligere har feilet. Da betaler du frontier-pris for unntakene, ikke for hver e-post og hver JSON-fil.
DeepSeek viste hvor fort kinesiske AI-modeller kunne presse pris og tilgjengelighet. Mozillas nye tall gjør konsekvensen tydeligere: Å betale mest er ikke lenger et forsvarlig standardvalg. Bruk den dyreste modellen når forspranget har en målbar verdi. Resten av trafikken bør gå dit jobben blir gjort godt nok og billigst.
Fire måneders forsprang kan være uvurderlig når fristen er i morgen. På rutinearbeid du fortsatt skal gjøre til jul, er fem ganger pris bare fem ganger pris.
Ofte stilte spørsmål
Er åpne AI-modeller like gode som Claude og GPT?
De beste åpne modellene er svært nær de lukkede toppmodellene på flere målinger, men ikke på alle oppgaver. Mozillas modellering anslår etterslepet til omtrent 4,4 måneder. Frontier-modeller har fortsatt et forsprang på særlig krevende ekspertarbeid, informasjonsinnhenting og lang kontekst.
Er open weights det samme som open source?
Nei. Open weights betyr vanligvis at selve modellvektene kan lastes ned og kjøres. Treningsdata, databehandling, treningskode og full dokumentasjon kan fortsatt være lukket. Derfor bør lisensen og det som faktisk følger med modellen kontrolleres før den tas i bruk.
Når lønner det seg å betale for en frontier-modell?
Det lønner seg når modellen fullfører en viktig oppgave en rimeligere modell ikke klarer, eller når lavere feilrate sparer mer enn prisforskjellen. Test på egne arbeidsflyter og mål total kostnad per godkjente resultat. Modellnavnet alene er ikke et regnestykke.
Må åpne AI-modeller kjøres på egen server?
Nei. Mange open-weight-modeller tilbys gjennom API-er og modellplattformer, slik at du slipper egen maskinvare og drift. Egen server gir mer kontroll, men krever kompetanse på hosting, sikkerhet, oppdateringer og kapasitet. Regn på hele driften før du sammenligner kostnader.