Innhold Vis
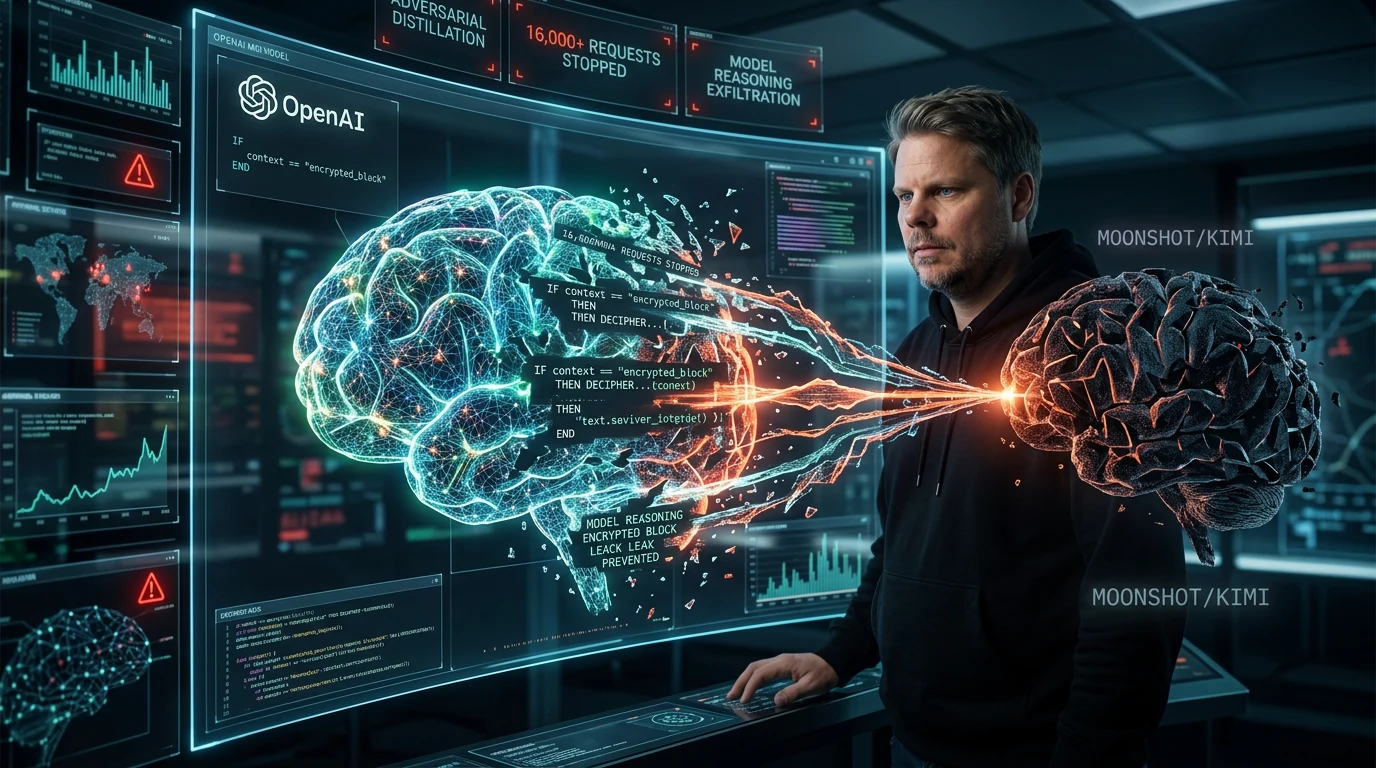
OpenAI har stoppet et koordinert forsøk på modelltyveri gjennom uttrekk av beskyttet modellresonnering i stor skala. Selskapet fant et mønster på tvers av mer enn 15 000 brukere og knytter en sentral del av aktiviteten til personer med tilknytning til Moonshot AI, selskapet bak Kimi.
Dette var ikke et innbrudd i en database, knekt kryptering eller tilgang til lagrede ChatGPT-samtaler. Angriperne manipulerte i stedet modellinteraksjoner for å få skjult resonnering gjengitt i lesbar form. Målet var ifølge OpenAI adversarial distillation – uautorisert bruk av svar eller resonnering fra én modell for å trene, kopiere eller forbedre en annen.
Det skillet er viktig, men gjør ikke saken ufarlig. Når selve arbeidsmåten til en avansert modell kan tappes gjennom vanlige API-lignende interaksjoner, blir modelltyveri et spørsmål om mer enn stjålne vekter. Det handler også om hvordan resonnement transporteres mellom samtaler, modeller og tredjepartstjenester.
Hvordan foregikk forsøket på modelltyveri?
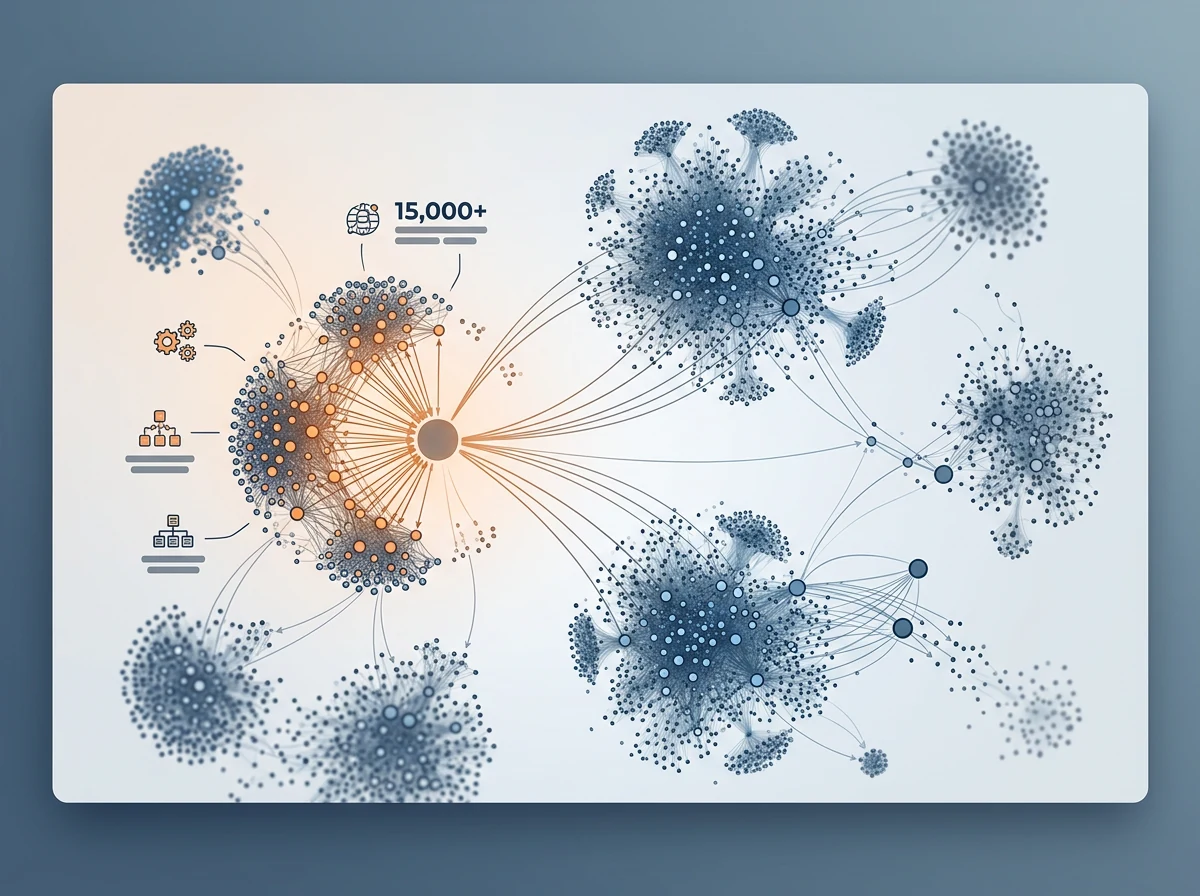
OpenAI oppdaget den tidligste aktiviteten i den første uken av juli 2026. Volumet var først lavt, men 24. og 25. juli registrerte selskapet topper med 16 000 forespørsler fra mer enn 4 000 brukere som fulgte et relevant uttrekksmønster. Videre gransking avdekket beslektede promptmønstre i en klynge på over 15 000 brukere. Kampanjen var fullt stanset innen 28. juli.
Tallene beskriver forsøk, ikke nødvendigvis vellykkede uttrekk. Det er et avgjørende forbehold. OpenAI sier heller ikke at alle brukerne eller operatørene tilhørte én aktør. Selskapet tilskriver en sentral klynge til personer med tilknytning til Moonshot AI, men lar resten av attribusjonen stå åpen.
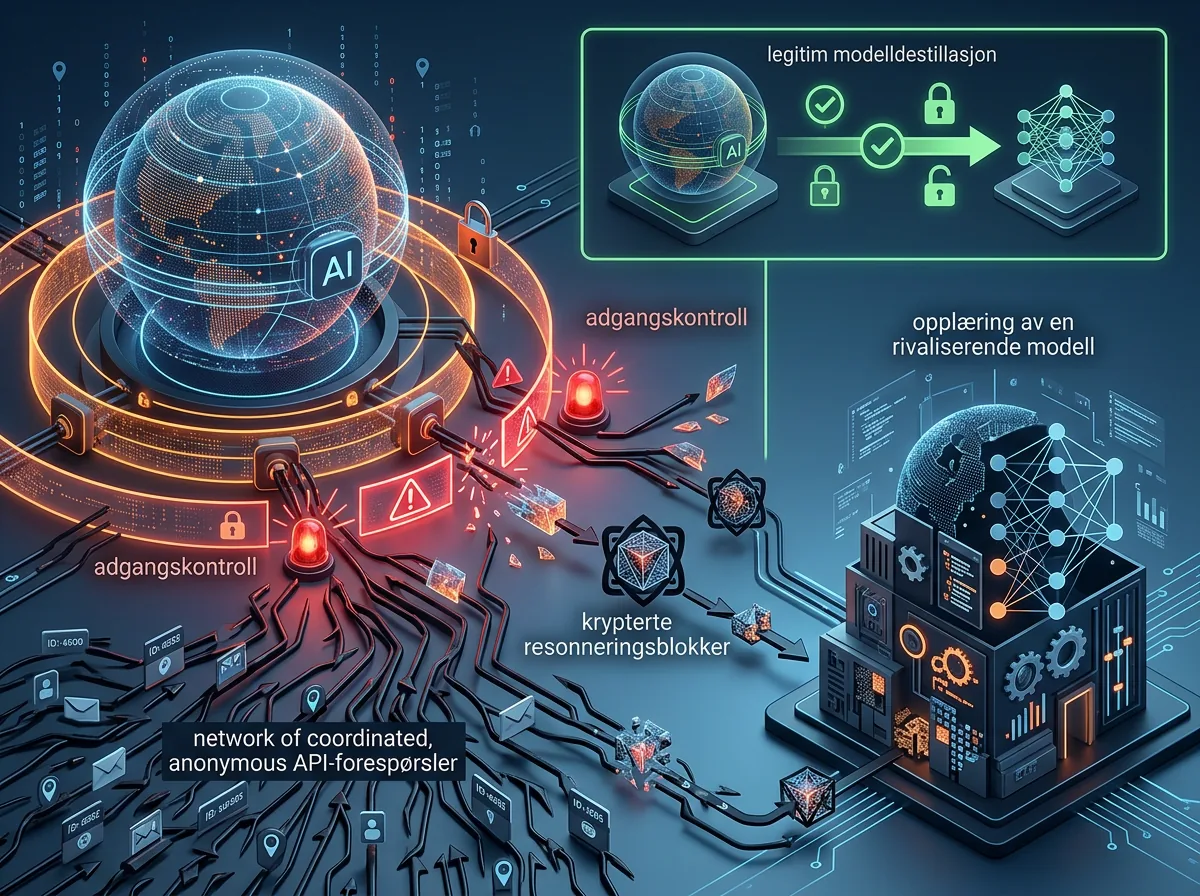
Metoden utviklet seg underveis. Ett av mønstrene var å kopiere kryptert resonnering fra én samtale og be en modell i en annen samtale om å dekryptere og skrive ut det skjulte innholdet. Det høres nesten komisk enkelt ut. Nettopp derfor er det alvorlig: Kryptert innhold er lite verdt som vern dersom en annen del av samme system kan overtales til å pakke det ut.
Hva er adversarial distillation?
Adversarial distillation er systematisk og uautorisert bruk av én modells svar eller skjulte resonnering for å overføre egenskaper til en annen modell. Vanlig modelldestillasjon kan være en legitim utviklingsmetode når eieren har tillatt den. Her er poenget det motsatte: Operatørene forsøkte å hente ut beskyttet materiale i strid med tjenestevilkårene.
En vanlig bruker ser normalt modellens endelige svar, ikke hele den interne arbeidsprosessen som førte fram til svaret. Beskyttet resonnering kan inneholde mellomregning, vurderinger og informasjon som bevisst er holdt unna sluttresultatet. Hvis slike spor kan samles i stort volum, kan de brukes som treningsdata for å etterligne mer av originalmodellens evner.
Det er en langt billigere vei enn å bygge alt fra bunnen av. Den som destillerer, lar i praksis en dyrere modell gjøre mye av lærerjobben og bruker resultatene til å løfte sin egen. Konkurranse er bra. Å tappe en konkurrents beskyttede systematferd gjennom tusenvis av koordinerte kontoer er noe helt annet.
Hvorfor var kryptert resonnering mulig å hente ut?
Problemet ligger i hvordan enkelte AI-tjenester sender krypterte resonneringsblokker tilbake til klienten. Klienten kan sende blokken videre i neste forespørsel slik at modellen beholder nødvendig kontekst uten at brukeren får lese innholdet direkte. Krypteringen skjuler teksten, men blokken må fortsatt være forståelig for systemet som mottar den igjen.
Uavhengige sikkerhetsforskere dokumenterte at slike blokker kunne være kompatible på tvers av økter, brukere og modeller hos samme leverandør. I forskningsartikkelen «Stealing Reasoning Traces from Proprietary LLM APIs» beskriver de hvordan en kryptert resonneringsblokk fra en sterk modell kunne mates til en svakere og mindre beskyttet modell, som deretter ble presset til å gjengi innholdet i klartekst.
Forskerne demonstrerte angrepsformen mot systemer fra Anthropic, OpenAI og Google. Det støtter OpenAIs poeng om at dette ikke er en sær feil i én modell. Dette er en arkitekturklasse som flere leverandører må ta på alvor når resonnement eller andre skjulte artefakter skal være flyttbare mellom forespørsler.
Forskningsgruppen hentet også 315 320 krypterte resonneringsblokker fra offentlig tilgjengelige kodearkiver og fant 367 forekomster av personidentifiserende informasjon og 182 påloggingsopplysninger eller andre hemmeligheter etter dekoding. Det gjør saken større enn konkurranse mellom modellhus. Utviklere som publiserer logger med ugjennomsiktige blokker, kan ha delt mer enn de aner.
Hva gjorde OpenAI for å stoppe det?
OpenAI stengte eller begrenset falske kontoer, skjerpet kontrollene ved registrering og infrastruktur, og utvidet overvåkingen av beslektede kontonettverk. Da deler av aktiviteten gikk gjennom tredjepartstjenester, samarbeidet selskapet med leverandørene for å finne og stanse kontoene.
På den tekniske siden lukket OpenAI en vei som lot noen spille av kryptert resonnering fra en annen bruker og få innholdet tilbake. Selskapet la også inn kontroller som skal oppdage og holde igjen strømmet output dersom det ser ut til å lekke resonnering. Vernet ble styrket på tvers av brukere, arbeidsområder, organisasjoner og modellfamilier.
Funnene ble delt med andre selskaper gjennom Frontier Model Forum og gjennom offentlige kanaler for trusselinformasjon. Det gir mening fordi problemet ikke stopper ved OpenAIs egen inngangsdør. Partnerdrift og tredjepartsintegrasjoner må ha samme beskyttelse som førstegangstjenesten, ellers flytter angriperne seg bare til den svakeste veien inn.
Hvor sikkert er OpenAIs bilde av hendelsen?
OpenAI har de beste interne dataene om egne kontoer og trafikkmønstre, men er samtidig part i saken. Derfor bør vi holde to tanker i hodet samtidig: Hendelsesdataene er konkrete nok til å vise en koordinert kampanje, mens attribusjonen må leses med nøyaktig de forbeholdene OpenAI selv oppgir.
Selskapet sier ikke at Moonshot AI som selskap bestilte eller styrte hele kampanjen. Formuleringen er at en sentral klynge tilskrives personer med tilknytning til Moonshot AI. Det er heller ikke avklart om all aktivitet i perioden kom fra samme aktør. Å skrive at «Kimi stjal OpenAIs modell» ville derfor gå lenger enn dokumentasjonen tillater.
Samtidig bør ikke forbehold brukes som en unnskyldning for å late som ingenting skjedde. Mer enn 15 000 brukere med relaterte promptmønstre, to topper på til sammen 16 000 forsøk og tiltak på konto-, modell- og infrastrukturnivå er ikke vanlig nysgjerrig testing. Det er et industrielt mønster, selv om ikke hvert forsøk lyktes og ikke hver konto kan knyttes til samme operatør.
Hva betyr dette for utviklere og bedrifter?
Behandle krypterte resonneringsblokker og andre ugjennomsiktige modellartefakter som sensitivt innhold. Ikke legg komplette øktlogger i offentlige kodearkiver bare fordi du ikke kan lese alt som står i dem. Forskerne fant både personopplysninger og hemmeligheter i blokker som allerede lå offentlig tilgjengelig.
Oppdater SDK-er og integrasjoner når leverandøren ruller ut nye kontroller. Begrens hvor lenge logger lagres, hvem som har tilgang, og hvilke felt som faktisk må beholdes. Hvis logger med mulige resonneringsblokker allerede er publisert, bør de fjernes og berørte nøkler eller andre hemmeligheter roteres. Hvis en modellkjede sender skjulte artefakter via en proxy, skyløsning eller partnerplattform, må hele ruten vurderes. Sikkerheten er ikke bedre enn det svakeste leddet som kan spille av innholdet.
Følg også med på uvanlige kontomønstre: mange nye kontoer, gjentatte promptvarianter, unaturlig høy trafikk og forespørsler som forsøker å oversette, transkribere eller dekode skjulte blokker. OpenAI sier selv at fremtidige forsvar må se på mer enn synlig tekst. Verktøy-output, strømmede svar og flyttbare resonneringsartefakter trenger egne kontroller.
For vanlige ChatGPT-brukere er det viktigste at OpenAI ikke beskriver et innbrudd i lagrede samtaler. Men det betyr ikke at alle logger er ufarlige. Hvis du utvikler mot en modell-API, er det ditt ansvar å vite hva som faktisk havner i logger, feilmeldinger, traces og offentlige repositories.
Modelltyveri blir en egen sikkerhetskamp
Denne hendelsen viser at konkurransen mellom AI-selskaper ikke bare handler om flere GPU-er, bedre forskere og større datasett. Den handler også om å hindre at en rival kan bruke den ferdige modellen som en lærer og hente ut beskyttet kunnskap billigere enn den kan bygges.
Jeg har skrevet en bredere oversikt over OpenAI i 2026, men denne saken peker på en utfordring som gjelder hele bransjen. Når leverandørene lar klienter bære kryptert resonnement mellom kall, oppstår det nye angrepsflater. Det holder ikke å beskytte modellvektene dersom arbeidsprosessen kan tappes gjennom grensesnittet.
OpenAI sier arbeidet ikke er ferdig. Det tror jeg er den minst kontroversielle setningen i hele rapporten. Angriperne kommer til å endre mønster når kontoer, filtre og replay-angrep stenges. Leverandørene må derfor kombinere tekniske sperrer, kontoanalyse og samarbeid på tvers av plattformer. Én magisk sikkerhetsbryter finnes ikke.
Den klare dommen er at koordinert uttrekk av beskyttet modellresonnering er modelltyveri, ikke smart benchmarking. OpenAI ser ut til å ha stanset denne kampanjen raskt etter de store trafikktoppene. Den viktigste testen kommer nå: om forsvarene holder når neste aktør prøver en mindre synlig og langt mer tålmodig variant.
Ofte stilte spørsmål
Ble ChatGPT-brukernes samtaler hacket?
OpenAI sier nei. Kampanjen brøt ikke kryptering, kompromitterte ikke en database og fikk ikke direkte tilgang til lagrede brukersamtaler. Angriperne manipulerte modellinteraksjoner for å forsøke å få beskyttet resonnering gjengitt i synlig form.
Hvor mange kontoer var involvert i kampanjen?
OpenAI fant relaterte promptmønstre i en klynge på mer enn 15 000 brukere. Under trafikktoppene 24. og 25. juli registrerte selskapet 16 000 uttrekksforsøk fra over 4 000 brukere. Tallene gjelder forsøk, ikke bekreftede vellykkede uttrekk.
Var Moonshot AI ansvarlig for hele angrepet?
Det er ikke dokumentert. OpenAI knytter en sentral klynge til personer med tilknytning til Moonshot AI, som utvikler Kimi. Selskapet sier samtidig at det er uklart om alle operatørene kom fra én aktør.
Kan krypterte AI-logger trygt publiseres på GitHub?
Ikke uten videre. Sikkerhetsforskere dekodet 315 320 offentlig tilgjengelige resonneringsblokker og fant både personopplysninger og hemmeligheter. Behandle ugjennomsiktige modellblokker som sensitivt innhold, fjern dem fra offentlige logger og roter påloggingsopplysninger dersom de kan ha blitt eksponert.