Innhold Vis
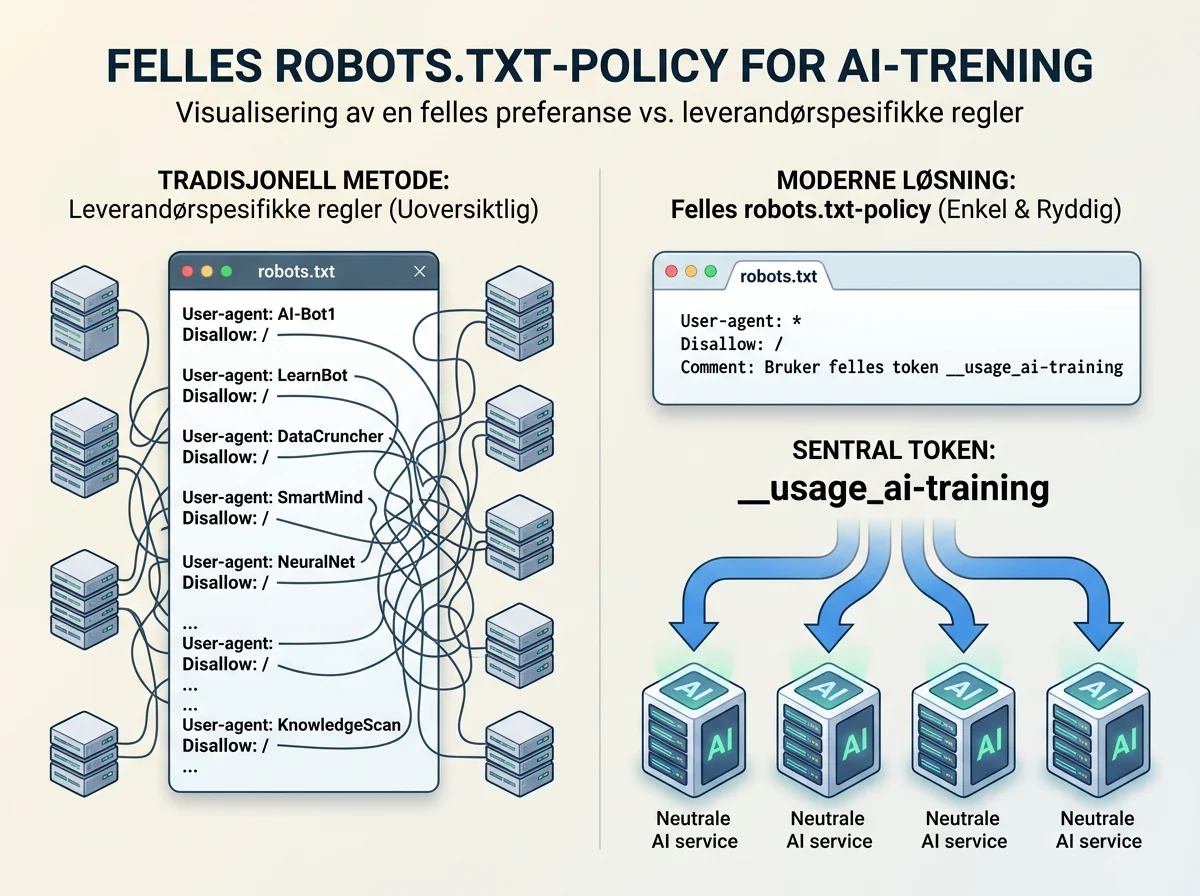
Nettsideeiere skal kunne reservere innhold mot AI-trening hos OpenAI, Google, Microsoft og Anthropic med én felles regel i robots.txt. Det er et etterlengtet steg bort fra jungelen av selskapsnavn og egne crawler-regler.
Den nye policy-tokenen heter __usage_ai-training. Med den kan en utgiver si nei til at hele eller deler av nettstedet brukes til å endre de lærte parameterne i generative AI-modeller. Samme beskjed kan leses av alle leverandører som velger å støtte ordningen.
Dette er fornuftig. En innholdsprodusent skal ikke måtte følge med på en stadig voksende navneliste over boter bare for å uttrykke ett enkelt valg. Men det er viktig å kalle løsningen det den er: en frivillig preferanse for modelltrening. Den blokkerer ikke crawling, den fjerner ikke data som allerede er brukt, og støtten er ennå ikke aktiv hos alle fire selskaper.
Hva er den nye opt-out-regelen?
Den nye opt-out-regelen er en vanlig gruppe i robots.txt der feltet User-Agent inneholder en felles policy-token i stedet for navnet på en bestemt crawler. Internet-Draft-utkastet bruker denne formen for å reservere hele nettstedet mot modelltrening, men tillate en egen pressemappe:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Disallow: / uttrykker en preferanse mot AI-trening for hele nettstedet. Den lengre regelen for /press-kit/ vinner for den mappen og tillater trening der. Mekanikken følger den vanlige lengste-treff-regelen i robots.txt, så utgivere kan styre reservasjonen per mappe og sti uten et nytt filformat.
Fram til nå har en utgiver måttet forholde seg til blant annet GPTBot, Google-Extended og ClaudeBot, i tillegg til egne regler og definisjoner hos hvert selskap. OpenAI beskriver den felles tokenen som en måte å uttrykke samme preferanse til flere leverandører på én gang. Selskapets eksisterende crawler-kontroller skal fortsatt gjelde ved siden av den nye ordningen.
Hva betyr regelen – og hva betyr den ikke?
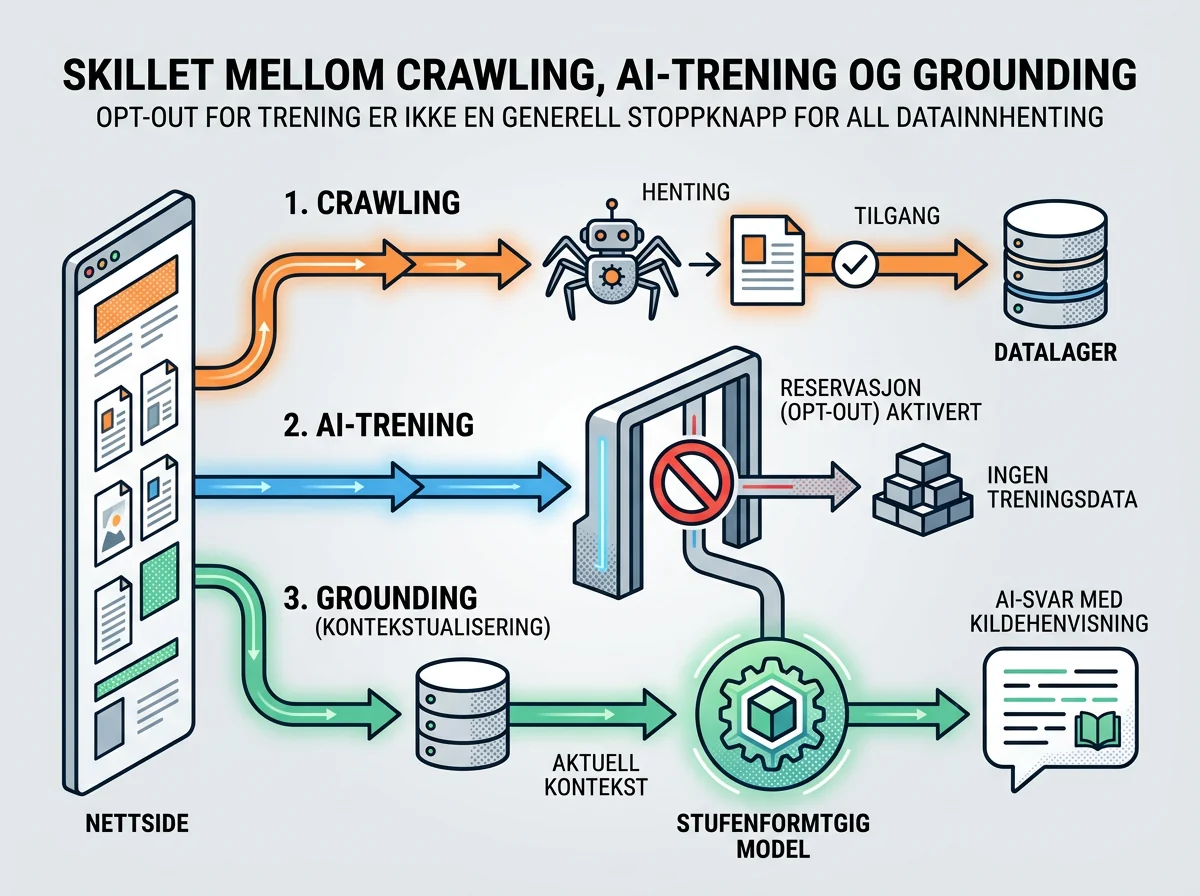
Tokenen gjelder AI-trening i en ganske presis betydning: bruk av innhold for å endre de lærte parameterne i en generativ AI-modell. Den styrer ikke automatisk om en bot får hente siden, om siden vises i et vanlig søkeresultat eller om innhold kan brukes som kilde i et svar som lages der og da.
Det skillet er mer enn teknisk flisespikking. Crawling er selve innhentingen. Trening endrer modellens parametere. Grounding betyr at en AI-tjeneste henter aktuell informasjon og bruker den som grunnlag for et svar, gjerne med lenke tilbake til kilden. En utgiver kan ønske å være synlig i søk og AI-svar, men samtidig si nei til modelltrening.
Den nye gruppen er heller ikke en crawler som kommer på besøk med navnet __usage_ai-training. Utkastet sier uttrykkelig at innholdsbruk og trafikkstyring er to uavhengige signaler. Vil du blokkere en faktisk bot, må du fortsatt bruke produkt-tokenen til den aktuelle crawleren.
En eksisterende jokerregel som User-Agent: * teller ikke som en preferanse under den nye ordningen. Mangler gruppen med __usage_ai-training, er det heller ikke uttrykt noe valg. Det betyr at dagens robots.txt-filer ikke plutselig blir tolket som samtykke eller reservasjon bare fordi utkastet finnes.
Når begynner selskapene å respektere signalet?
De fire selskapene støtter retningen, men innføringen skjer ikke samtidig. Anthropic har allerede tatt i bruk signalet. OpenAI sier at støtten skal komme i løpet av de neste månedene. Google sikter mot 2027, mens Microsoft har satt 1. februar 2027 som startdato for sine nye preferanser.
Det betyr at du ikke bør slette eksisterende selskapsregler og regne jobben som ferdig i dag. En preferanse har ingen praktisk virkning hos en leverandør før leverandøren faktisk har støtte for å lese og følge den. OpenAI og Google sier også uttrykkelig at deres egne eksisterende kontroller skal fortsette å fungere.
Google har forklart at en felles reservasjon skal tolkes som en blokkering av Google-Extended dersom nettstedet ikke har en egen regel for Google-Extended. Googles kunngjøring sier samtidig at en spesifikk Google-Extended-regel kan brukes for å gi Google et annet valg enn den brede fellespreferansen.
Her ligger også en praktisk hake: Google-Extended er knyttet både til trening og grounding i enkelte Gemini-opplevelser. En utgiver som vil si nei til trening, men ja til å bli brukt og lenket som aktuell kilde, må derfor lese Googles endelige implementasjon nøye. Én felles linje gjør grunnvalget enklere, men selskapenes produkter og tolkninger blir ikke magisk identiske.
Microsoft skiller mellom trening og AI-svar
Microsoft lager det tydeligste skillet mellom trening og grounding. Den felles robots.txt-regelen skal styre AI-trening for et nettsted eller en sti. En separat sideinnstilling skal styre om innholdet kan brukes som grunnlag for genererte svar i blant annet Bing, Copilot og Microsoft 365.
I Microsofts implementasjonsplan kan en utgiver for eksempel sette trening til Disallow og grounding til Allow. Da kan siden fortsatt brukes som aktuell kilde i et generert svar uten å være tilgjengelig for framtidig generativ modelltrening. Dette påvirker ikke i seg selv muligheten til å være med i vanlige Bing-søkeresultater.
Microsoft erstatter samtidig bruken av NoArchive og NoCache som kontroller for trening og grounding. De nye innstillingene begynner å gjelde ved crawling fra 1. februar 2027. Etter 1. mars 2027 skal de gamle taggene ikke lenger leses som slike preferanser.
Bruker nettstedet ditt NoArchive eller NoCache i dag for å begrense AI-bruk, har du derfor en faktisk migreringsjobb. Trening skal angis i robots.txt eller på siden. For å beholde en grounding-begrensning gjennom overgangen må den nye sidepreferansen publiseres, og en midlertidig innstilling må registreres i Bing Webmaster Tools innen 1. mars 2027. Den midlertidige innstillingen varer til siden er crawlet på nytt eller senest 30. september 2027.
Er dette en ferdig standard?
Nei. Dokumentet ble publisert 30. oktober 2026 som et individuelt Internet-Draft av Kevin Kelley fra Anthropic. Det er merket som aktivt arbeid og utløper 3. mai 2027 dersom det ikke oppdateres eller erstattes. IETF Datatracker presiserer at et individuelt utkast ikke er godkjent av IETF og ikke har formell status i standardiseringsprosessen.
Det gjør ikke ideen verdiløs. Tvert imot kan tidlig støtte fra fire store aktører gjøre den nyttig lenge før alle formelle runder er ferdige. Vanlig robots.txt-syntaks er også et smart valg fordi programvare som ikke kjenner policy-tokenen, bare kan ignorere gruppen uten å ødelegge de gamle crawler-reglene.
Men ordet «standard» bør foreløpig brukes med bremsen på. Dette er et utkast og en frivillig preferanse, ikke en teknisk sperre eller et kontrollorgan. Utkastet åpner dessuten for at mer spesifikke selskapsregler og private avtaler kan overstyre den brede preferansen. Om selskapene faktisk følger signalet, bygger på løftene deres og eventuelle rettslige plikter – ikke på at robots.txt kan håndheve noe alene.
Det samme gjelder historiske treningsdata. Preferansen knyttes til robots.txt-filen som gjaldt da innholdet ble hentet. Den kan styre framtidig bruk hos selskaper som respekterer den, men den spoler ikke tiden tilbake og fjerner et verk fra en modell som allerede er trent.
Min vurdering: Bra retning, men behold dagens kontroller
En felles opt-out for AI-trening er en god idé. Nettet trenger færre proprietære småkongedømmer der hver leverandør finner opp sin egen token, sin egen definisjon og sin egen dokumentasjon. Når OpenAI, Google, Microsoft og Anthropic støtter samme grunnsignal, blir valget langt enklere for både små nettsteder og store utgivere.
Samtidig må dette ikke selges som en stor rød stoppknapp for «AI-scraping». Det er den ikke. Tokenen sier noe om én bestemt bruk av innholdet, mens crawling, søkeindeksering, grounding og eksisterende treningsdata lever videre som egne spørsmål. Den forskjellen må være tydelig, ellers vil mange tro at de har slått av langt mer enn de faktisk har.
For nettstedseiere er rådet mitt derfor enkelt: Behold dagens leverandørspesifikke regler mens utrullingen pågår. Dokumenter hva du ønsker å tillate for crawling, trening og grounding hver for seg. Legg til den felles tokenen når den passer valget ditt, men kontroller også reglene hos leverandørene du faktisk bryr deg om.
Det er ikke den endelige løsningen. Det er likevel konkret, forståelig og mulig å ta i bruk uten å bygge om hele nettet. Det er en langt bedre start enn enda fire nye særregler.
Ofte stilte spørsmål
Hva skriver jeg i robots.txt for å si nei til AI-trening?
Bruk gruppen User-Agent: __usage_ai-training etterfulgt av Disallow: / for hele nettstedet. Signalet er foreløpig et utkast, og leverandørene innfører støtte på ulike datoer. Behold derfor eksisterende regler for GPTBot, Google-Extended og andre relevante boter inntil støtten er aktiv og kontrollert.
Stopper den nye regelen AI-boter fra å besøke nettstedet?
Nei. Policy-tokenen uttrykker en preferanse for hvordan innholdet brukes til generativ modelltrening. Den er ikke en crawler-blokkering. For å begrense selve innhentingen må du fortsatt bruke robots.txt-regler for produkt-tokenen til den aktuelle boten.
Kan nettstedet fortsatt vises i søk og AI-svar?
Ja, avhengig av leverandørens regler. Trening, vanlig søkeindeksering og grounding er forskjellige bruksområder. Microsoft tilbyr separate valg for trening og grounding. Google knytter den felles preferansen til Google-Extended dersom du ikke har angitt en egen Google-Extended-regel.
Fjerner opt-out-regelen innhold fra modeller som allerede er trent?
Nei. Utkastet knytter preferansen til innhold som hentes mens den aktuelle robots.txt-filen gjelder. Det beskriver ikke en mekanisme for å fjerne historiske treningsdata eller endre en modell som allerede er trent på innholdet.