Innhold Vis
Hvis du bygger taleagenter, løser Gemini 3.8 Live et av de mest irriterende problemene: Samtalen trenger ikke stoppe mens agenten bruker verktøy. Modellen kan fortsette å snakke, ta imot visuell kontekst og håndtere API-kall i bakgrunnen. Extended Thinking gjør det samme for oppgaver som krever flere resonneringssteg.
Google lanserte begge modellene 15. september 2026 som stabile modeller i Gemini API og Google AI Studio. Dette er native audio-to-audio-modeller, ikke den gamle kjeden der tale først blir tekst, sendes gjennom en språkmodell og deretter blir tale igjen. Den forskjellen merkes når en agent skal oppføre seg som en samtalepartner og ikke som en telefonsvarer med svært lange tenkepauser.
Min vurdering er nøkternt positiv: Dette er et viktig steg fra imponerende demoer til taleagenter som kan gjøre nyttig arbeid mens samtalen lever. Men «production-ready» på en lanseringsside er ikke det samme som produksjonsklar i din løsning. Du må velge riktig av de to modellene, håndtere den nye tilstandslogikken og måle kostnaden for hele samtalen før du slipper en agent løs på kunder.
Hva er Gemini 3.8 Live?
Gemini 3.8 Live er Googles standardmodell for raske, toveis talesamtaler med lav forsinkelse. Den tar imot tekst, bilder, lyd og video, svarer med tekst eller lyd og har et kontekstvindu på 131 072 input-token. Modell-ID-en i API-et er gemini-3.8-live.
Den er laget for direkte oppgaver der tempoet i samtalen betyr mest: førstelinje i kundeservice, stemmesøk, språkøving, styring av enheter og andre arbeidsflyter der verktøyene svarer raskt. Function calling er asynkront som standard, men du kan fortsatt bruke blokkerende kall for eldre integrasjoner.
Det mest praktiske er at taleagenten kan bekrefte at den har forstått forespørselen og holde kontakten mens et API arbeider. I stedet for fem sekunder med taushet kan den for eksempel si at den sjekker ordren, fortsette dialogen og komme tilbake når verktøyet har svart. Det høres ut som en liten detalj. I en ekte telefonsamtale er det forskjellen på flyt og «Hallo, er du der?».
Live API støtter 97 språk, og modellen kan skifte språk midt i samtalen uten at du setter en ny språkkode. Den kan også bruke live videobilder som kontekst. Det åpner for support der brukeren viser et kontrollpanel eller en maskin mens vedkommende forklarer problemet muntlig. Er ren sanntidsoversettelse behovet, har jeg også skrevet om Gemini 3.5 Live Translate.
Hva gjør Extended Thinking annerledes?
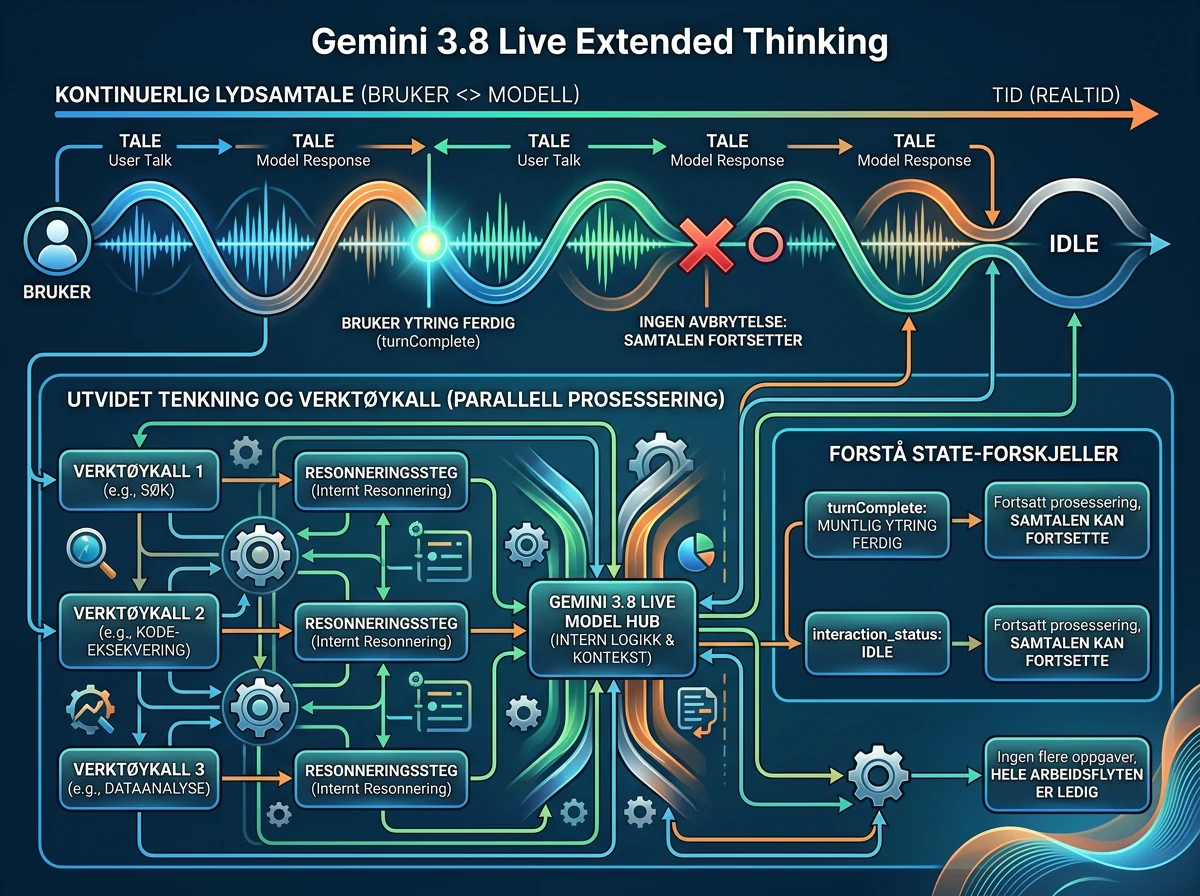
Gemini 3.8 Live Extended Thinking er varianten for kompliserte oppgaver med flere steg, parallelle verktøykall og lengre behandlingstid. Den kan resonnere i bakgrunnen samtidig som den gir korte muntlige oppdateringer. Modell-ID-en er gemini-3.8-live-extended-thinking, og function calling er bare asynkront.
Google anbefaler standardmodellen når rask respons og enkel klientlogikk er viktigst. Extended Thinking passer bedre til teknisk feilsøking, reisebestilling på tvers av flere tjenester, kodeundervisning og andre oppgaver der agenten må samle inn data, sammenligne alternativer og planlegge flere handlinger før den kan svare ordentlig.
Du kan velge low, medium eller high for thinking_level i Extended Thinking. Standardmodellen støtter ikke denne innstillingen. Forskjellen er viktig ved migrering: Sender du gammel thinking_config til gemini-3.8-live, har du ikke oppgradert – du har bare bygget deg en feil med et nytt modellnavn.
Googles dokumentasjon for bakgrunnsresonnering viser også en mer grunnleggende endring. I Extended Thinking betyr ikke turnComplete: true lenger at hele jobben er ferdig. Det betyr bare at modellen er ferdig med én ytring. Klienten må følge interaction_status og vente til statusen er IDLE før den behandler agenten som ledig.
Hvorfor betyr bakgrunnsarbeidet så mye?
En nyttig taleagent må gjøre mer enn å snakke pent. Den må hente kundedata, kontrollere lager, finne en ledig tid, oppdatere en sak og håndtere at ett av systemene bruker tid eller feiler. Når alle kall blokkerer samtalen, blir hvert ekstra verktøy en ny kunstpause.
Gemini 3.8 Live lar verktøy deklareres med NON_BLOCKING. Agenten kan da fortsette lydstrømmen mens kallet kjører, og funksjoner kan planlegges som SILENT, WHEN_IDLE eller INTERRUPTED. Det gir utvikleren mer kontroll over når resultatet skal flettes inn og om modellen bør avbryte seg selv når viktig informasjon kommer tilbake.
Extended Thinking går et steg videre ved å holde én arbeidsflyt aktiv over flere muntlige oppdateringer. En bookingagent kan lete etter fly, hoteller og priser parallelt, fortelle at søket pågår og senere presentere alternativene. Brukeren slipper å sitte og lure på om forbindelsen døde.
Dette er hovedgrunnen til at lanseringen betyr noe. Benchmark-tall er hyggelige, men en taleagent lever eller dør på flyt, avbrudd, verktøyfeil og om den faktisk fullfører oppgaven. Bakgrunnskall fjerner ikke disse problemene. De gir deg en arkitektur som gjør dem mulig å håndtere uten å ødelegge samtalen.
Hvor gode er modellene på målte tester?
Extended Thinking fikk 82,6 poeng og førsteplass på Artificial Analysis’ Speech to Speech Quality Index, mens standardmodellen kom på andreplass i Speech Agent Arena. Google viser også til tester av oppgavefullføring og lydresonnering, men flere av resultatene kommer fra selskapets egen lansering.
Det er lovende, men en rangering sier lite om dine kunder, dialekter, verktøy og responstider. En taleagent kan score pent og fortsatt rote bort bekreftelseskoder, misforstå avbrudd eller bli hengende når et API svarer tomt.
Jeg ville derfor brukt resultatene som grunn til å teste, ikke som grunn til å migrere blindt. Lag et fast sett med ekte samtaleforløp: avbrudd midt i et svar, feil bekreftelseskode, tregt API, verktøy som returnerer tomt resultat og en bruker som bytter språk. Mål oppgavefullføring og hvor ofte et menneske må rydde opp. Der ligger fasiten.
Hva koster Gemini 3.8 Live?
Begge modellene har samme standardpris. Lyd inn koster 0,005 dollar per minutt, cirka 4,7 øre med en dollarkurs rundt 9,34 kroner. Lyd ut koster 0,018 dollar per minutt, cirka 16,8 øre. En time kontinuerlig lyd inn og en time lyd ut blir dermed omtrent 1,38 dollar, eller rundt 12,90 kroner.
Googles pristabell oppgir også 0,75 dollar per million teksttoken inn og 4,50 dollar per million teksttoken ut. For lyd tilsvarer minuttprisene 3 dollar per million input-token og 12 dollar per million output-token. Thinking-token faktureres som output.
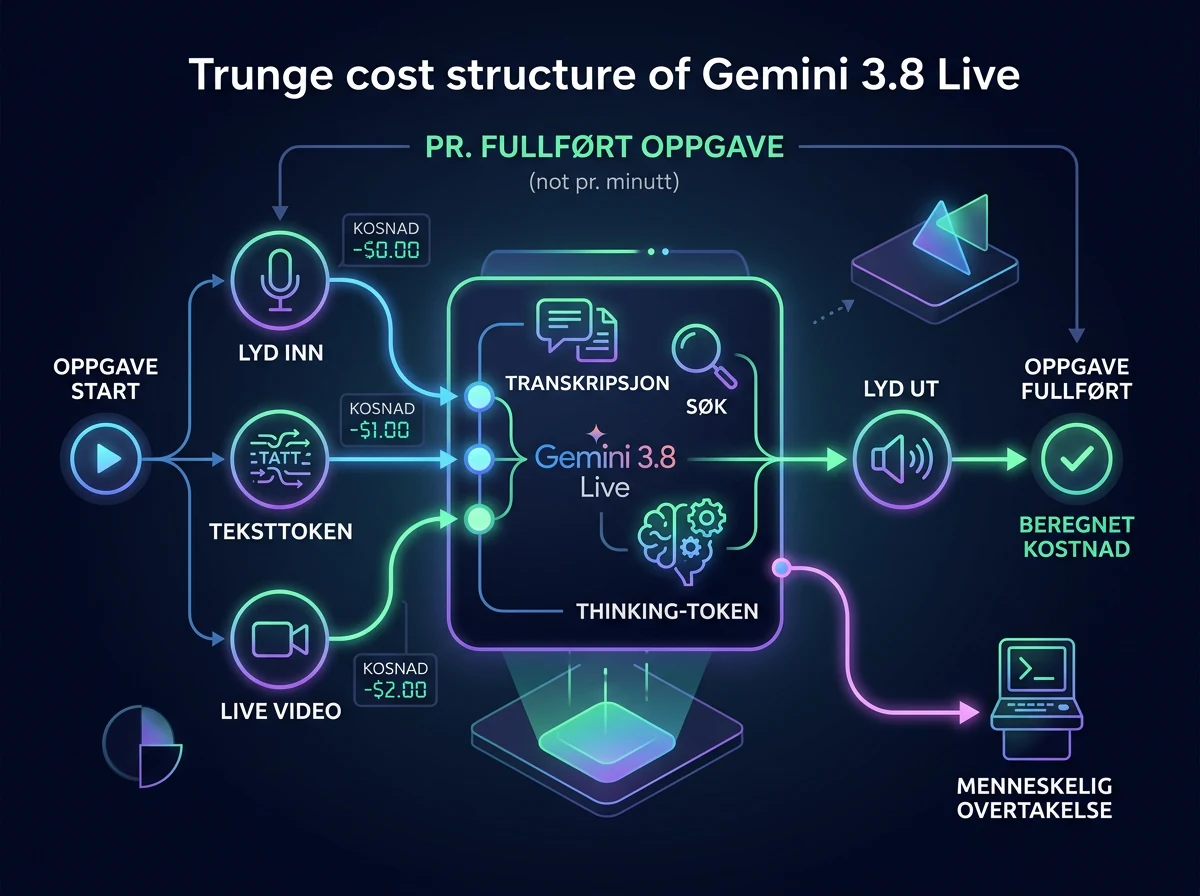
Minuttprisen er bare starten på regnestykket. Tekst, live video og søk kan legge til forbruk, og søk faktureres etter den delte gratiskvoten. Proactive audio er dessuten permanent aktivert for Gemini 3.8-modellene. Derfor må du måle hele inputstrømmen og ikke bare sekundene der agenten svarer.
Det praktiske rådet er å måle kostnad per fullført oppgave, ikke bare per minutt. En agent som løser saken på fire minutter kan være billigere enn en rimeligere modell som bruker åtte minutter og ender hos et menneske. Men en agent som prater mens den tenker, kan også bruke både tid og output uten å komme nærmere målet. Tallene må inn i loggen.
Hva må endres ved migrering?
Kommer du fra gemini-3.1-flash-live-preview, starter du med å bytte modellstrengen til gemini-3.8-live. Fjern thinking_level og thinking_config fra oppsettet for standardmodellen. Asynkrone funksjonskall er nå standard, og proactive audio kan ikke deaktiveres.
Google har også fjernet affective dialogue-innstillingen. Har du enable_affective_dialog i konfigurasjonen, skal den bort. Video inngår som standard i turdekningen, så send bare bilderammer når agenten faktisk trenger dem. Ellers bruker du kontekst og penger på at modellen ser et uforandret bilde igjen og igjen.
Velger du Extended Thinking, må klienten fortsette å lytte etter nye lydrammer og verktøykall etter turnComplete: true. Tilstanden skal styres etter interaction_status. Verktøyene må deklareres som NON_BLOCKING, og brukergrensesnittet bør vise forskjell på at modellen har sluttet å snakke og at arbeidsflyten faktisk er ferdig.
Dette er ikke bare teknisk pirk. Feil tilstandsmodell kan gjøre at brukeren starter en ny kommando mens den gamle fortsatt arbeider, eller at klienten lukker samtalen før resultatet kommer. Les gjerne min tidligere gjennomgang av Gemini 3.1 Flash Live for å se hva den nye generasjonen bygger videre på.
Hvilken modell bør du velge?
Velg Gemini 3.8 Live når samtalen skal være rask, oppgavene er forholdsvis direkte og verktøyene svarer fort. Velg Extended Thinking når agenten må analysere flere kilder, planlegge mange steg eller skjule ventetiden fra trege tjenester med naturlige statusoppdateringer.
Ikke velg Extended Thinking bare fordi navnet høres kraftigere ut. Dypere resonnering gir mer klienttilstand å håndtere og kan bruke flere output-token. En enkel agent som sjekker åpningstider eller henter ordrestatus trenger sjelden å tenke på høyt nivå. Riktig modell er den minste som fullfører jobben stabilt.
Start med 3.8 Live som grunnlinje. Kjør de samme samtalene med Extended Thinking der standardmodellen feiler på planlegging eller flertrinnsoppgaver. Sammenlign oppgavefullføring, svartid, antall verktøykall, kostnad og hvor ofte en ansatt må overta. For mer bakgrunn om økosystemet har jeg samlet modellene og tjenestene i min norske guide til Google Gemini.
Gemini 3.8 Live er lovende fordi Google tar tak i den vanskelige delen av taleagenter: arbeidet som skjer mellom replikkene. Nå er ikke spørsmålet bare om AI kan snakke naturlig. Spørsmålet er om den kan holde samtalen levende mens den faktisk får noe gjort. Det kan disse modellene være et reelt svar på – dersom integrasjonen din tåler virkeligheten utenfor demoen.
Ofte stilte spørsmål
Er Gemini 3.8 Live tilgjengelig i Norge?
Modellene er tilgjengelige for utviklere gjennom Gemini API og Google AI Studio, og Live API støtter norsk blant 97 språk. Tilgangen til Gemini-funksjoner i Search, Workspace og abonnementer kan variere etter produkt, marked og utrulling.
Kan Gemini 3.8 Live bruke kamera og tale samtidig?
Ja. Modellen tar imot lyd, bilder og video og kan bruke live visuell kontekst i samtalen. Send bare relevante videorammer, siden bilder bruker kontekst og faktureres separat. Modellen leverer tekst eller innebygd lyd som svar.
Hva koster en samtale på ti minutter?
Ti minutter lyd inn koster 0,05 dollar og ti minutter lyd ut 0,18 dollar, til sammen cirka 2,15 kroner med kurs rundt 9,34. Faktisk pris kan bli høyere med transkripsjon, teksttoken, video, søk og annen bruk.
Må jeg bruke Extended Thinking for verktøykall?
Nei. Gemini 3.8 Live støtter asynkrone verktøykall og passer best når oppgavene er direkte og lav forsinkelse er viktig. Extended Thinking er for komplekse arbeidsflyter med flere steg, bakgrunnsresonnering og verktøy som bruker merkbar tid.