Innhold Vis
Det viktigste tallet i Inkling 2 Small er ikke 594 milliarder, men 17 milliarder. Thinking Machines Lab slapp modellen 5. november 2026, og bare 17 milliarder parametere aktiveres per token. Det kan gi håndterlige beregningskostnader, men gjør ikke en 594B-modell liten å lagre.
For utviklere er den viktigste nyheten at modellen allerede kan brukes til inferens og finjustering gjennom Thinking Machines Labs Tinker-plattform. Fullstendige modellvekter er derimot ikke tilgjengelige ennå. Selskapet sier at de skal komme under Apache 2.0-lisensen etter ekstern sikkerhetstesting.
Lanseringen kommer derfor i to trinn: Modellen kan brukes i skyen nå, mens løftet om åpne vekter fortsatt ligger litt fram i tid. Jeg liker retningen, men en varslet åpen utgivelse er ikke det samme som filer du kan laste ned i dag.
Hva er Inkling 2 Small?
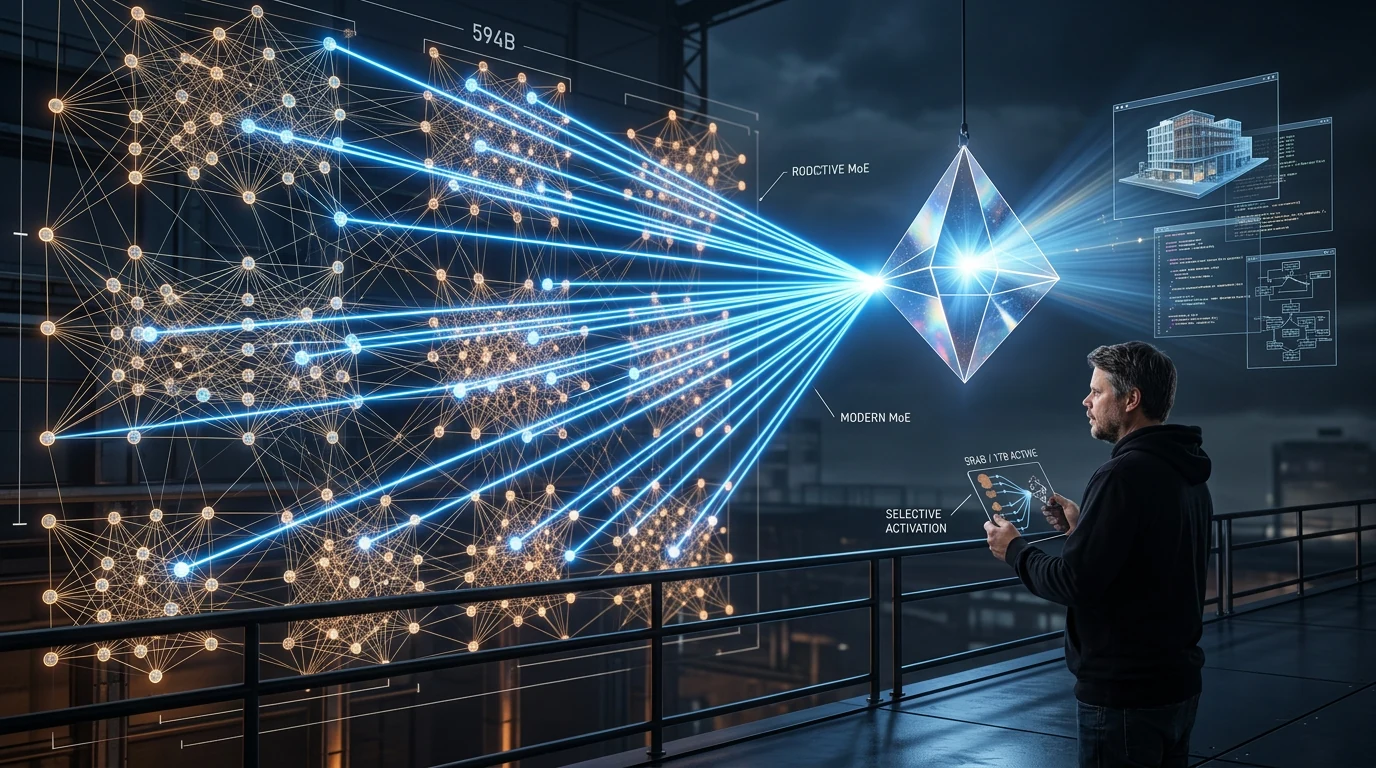
Inkling 2 Small er andre generasjon i Inkling-familien fra Thinking Machines Lab. Modellen er en Mixture-of-Experts, ofte forkortet MoE, med 594 milliarder totalparametere og 17 milliarder aktive parametere per token. Den tar imot tekst og bilder, kan bruke verktøy og lar brukeren styre hvor mye arbeid den skal legge i svaret.
MoE betyr grovt sagt at modellen består av mange spesialiserte deler, men bare sender hvert token gjennom et utvalg av dem. Alle de 594 milliardene må fortsatt lagres når modellen skal kjøres lokalt eller på egen infrastruktur. Beregningen for hvert token ligger derimot nærmere de 17 milliardene som aktiveres. «Small» handler altså mer om aktiv beregning enn om en liten nedlasting.
Den forrige Inkling-Small hadde 276 milliarder totalparametere og 12 milliarder aktive. Andre generasjon mer enn dobler det totale parameterantallet, mens den aktive delen øker langt mindre. Det er et godt bilde på hva Thinking Machines Lab prøver å få til: større samlet kapasitet uten at kostnaden per token vokser i samme takt.

Hvorfor betyr 594B/17B noe i praksis?
Forholdet mellom 594 milliarder totalt og 17 milliarder aktive parametere forklarer både styrken og haken ved Inkling 2 Small. Modellen kan fordele kunnskap og ferdigheter over et svært stort ekspertnettverk, men trenger ikke bruke hele nettverket på hvert ord den behandler. Det kan gi høyere kapasitet per beregnet token enn en tett modell med samme totalstørrelse.
Men aktiv parameterbruk er ikke det samme som maskinvarekrav. Hvis de åpne vektene blir publisert som varslet, må hele modellen fremdeles få plass et sted. Thinking Machines Lab har foreløpig ikke publisert en komplett lokal distribusjonsoppskrift for denne utgaven. Det er derfor for tidlig å love at en vanlig arbeidsstasjon kan kjøre den bare fordi tallet 17B ser overkommelig ut.
Modellkortet oppgir et kontekstvindu på opptil 1 million token. I Tinkers prisoppsett finnes trenings- og samplingsvarianter med 64K og 256K kontekst, mens serverless inferens tilbys med 256K. Den offisielle modell-ID-en er thinkingmachines/Inkling-2-Small. Modellen støtter bilder, men ikke lyd. Det siste er verdt å merke seg fordi første generasjon Inkling og Inkling-Small også kunne ta imot lyd.
Hva kan modellen faktisk gjøre?
Thinking Machines Lab har trent Inkling 2 Small for koding, verktøybruk, bildeanalyse, kunnskapsarbeid og langvarige agentoppgaver. I selskapets egen lanseringsartikkel demonstreres blant annet nettsteder, spill og 3D-design som modellen bygger og forbedrer ved å tolke visuell tilbakemelding.
Den mest interessante delen er likevel arbeidet over lang tid. Modellen ble trent på hundretusener av langvarige kodeoppgaver og fikk også oppgaver innen automatisk research. I én demonstrasjon trente den en Qwen3.5-4B-modell til å forutsi tidsserier. Den bygget evalueringen, oppdaget en feil i sin egen test, prøvde både supervised fine-tuning og reinforcement learning og forkastet forsøk som gjorde resultatet dårligere.
Arbeidet tok 4 timer og 17 minutter og kostet 426 dollar i Tinker, omtrent 4 000 kroner med dollarkursen 5. november. På skjulte data fra august og september reduserte sluttmodellen feilen med rundt 15 prosent sammenlignet med basismodellen. Det er en imponerende leverandørdemonstrasjon, men fortsatt en håndplukket oppgave presentert av selskapet selv – ikke et løfte om at alle agentjobber vil lykkes like godt.
Artificial Analysis Intelligence Index er oppgitt til 30,6, avrundet til 31 i lanseringen. Den samlede poengsummen peker på et tydelig løft fra første generasjon, men et indeksnummer forteller ikke om modellen passer akkurat din kodebase eller arbeidsflyt. Jeg ville sett mer på oppgavene, kostnaden og hvor godt modellen følger instruksjoner enn på én plassering i en tabell.
Hva koster Inkling 2 Small på Tinker?
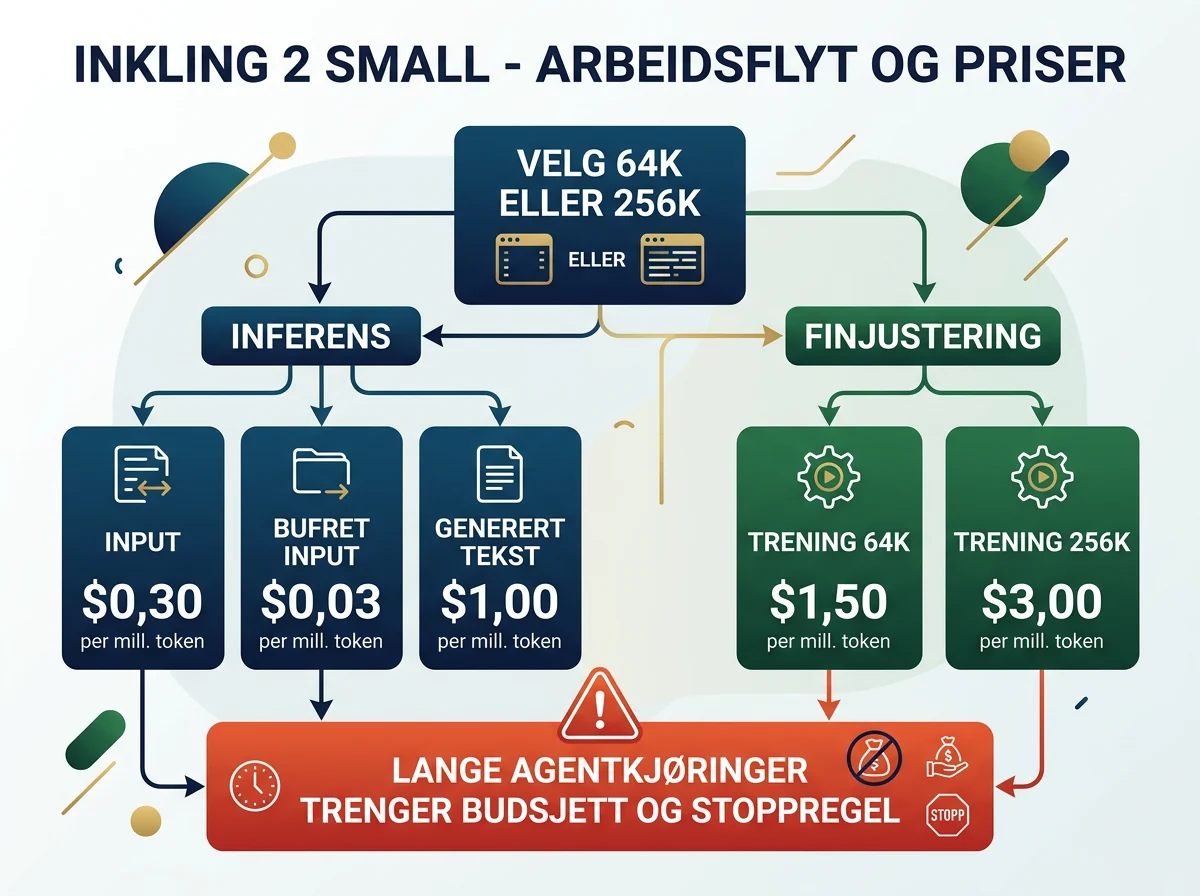
Tinker-prisen for Inkling 2 Small er 0,30 dollar per million inputtoken, 0,03 dollar for bufret input og 1 dollar per million genererte token. Med Norges Banks dollarkurs på 9,2984 kroner 5. november tilsvarer det omtrent 2,80 kroner for input, 28 øre for bufret input og 9,30 kroner for generert tekst per million token.
Finjustering med 64K kontekst koster 1,50 dollar per million treningstoken, rundt 14 kroner. Velger du 256K-kontekst, dobles treningsprisen til 3 dollar, omtrent 28 kroner per million token. Prisene er oppgitt uten eventuelle avgifter, og kronebeløpene vil bevege seg med valutakursen.
Det er konkurransedyktige tokenpriser for en så stor modell, men agentarbeid kan spise svært mange token. Demonstrasjonen til 426 dollar viser det bedre enn en pen pris per million: Lange kjøringer med trening, evaluering og mange nye forsøk må ha et tydelig budsjett og en stoppregel. Ellers blir «billig per token» fort en dyr ettermiddag.
Er vektene åpne nå?
Nei. Inkling 2 Small er tilgjengelig gjennom Tinker med lukkede vekter ved lansering 5. november 2026. Thinking Machines Lab sier at de fullstendige vektene skal publiseres under Apache 2.0-lisensen uken etter, når ekstern sikkerhetstesting og red teaming er ferdig.
Apache 2.0 er en praktisk og romslig lisens som normalt tillater både kommersiell bruk, endring og distribusjon. Det kan gjøre modellen aktuell for forskere, bedrifter og miljøer som vil bygge egne varianter. Men den vurderingen blir først reell når vektene, filformatene og distribusjonsdokumentasjonen faktisk er publisert.
Den trinnvise åpningen er den største forskjellen mellom hva du kan gjøre nå og hva som er lovet. I dag kan du prøve modellen i Tinker Playground, bruke serverless inferens i beta og finjustere den på Tinker. Når vektene kommer, skal sjekkpunktene fra finjustering også kunne lastes ned.
Hvordan skiller den seg fra første Inkling-Small?
Første Inkling-Small kom med 276 milliarder totalparametere, 12 milliarder aktive og støtte for tekst, bilder og lyd. Inkling 2 Small øker til 594 milliarder totalt og 17 milliarder aktive, men dropper lyd. Samtidig legger andre generasjon langt større vekt på langvarig agentarbeid, visuell tilbakemelding og én samlet RL-trening på tvers av mange oppgavetyper.
Treningen er også interessant i seg selv. Første pretreningsfase omfattet 8,4 billioner token og ble kjørt i 68 timer på Nvidia GB300 NVL72-systemer. Senere fulgte 3,8 billioner token med nyere data, før agent- og resonneringsdata ble blandet inn. Hovedrunden med reinforcement learning brukte mer enn 17 millioner rollouts over ni dager på 2 048 GPU-er.
Det er enorme tall, men det mest nyttige er hva treningen prøver å forbedre: Modellen skal kunne holde en oppgave i gang, bruke verktøy, kontrollere eget arbeid og fortsette etter at den vanlige chatten ville gått tom for kontekst. Thinking Machines Lab har tidligere vist en annen side av modellfamilien med TML-Interaction-Small for sanntidssamtaler. Inkling 2 Small er mer rettet mot tekst-, bilde- og agentarbeid enn mot tale.
Begrensningene er ganske konkrete
Modellkortet for Inkling 2 Small gjør det klart at dette ikke er den beste modellen for alt. Thinking Machines Lab sier selv at den kan være omstendelig, velge feil verktøy i kodebaser med mange skills og presentere svar dårligere enn modeller som er finpusset spesielt for chat.
Den kan også overreagere på spørsmål om psykisk helse og andre sikkerhetsrelaterte temaer. På enkelte sikkerhetstester avviser den mer enn ønskelig. Dette er ikke små fotnoter hvis modellen skal møte kunder eller arbeide autonomt i et komplisert verktøymiljø.
Modellen er heller ikke testet av meg. Det som er kjent, kommer fra Thinking Machines Labs dokumentasjon, modellkort og priser. Jeg kan derfor si hva arkitekturen, tilgangen og selskapets egne målinger viser, men ikke at modellen er bedre i en bestemt norsk arbeidsflyt eller at den oppfører seg godt med norske instruksjoner.
Min vurdering av Inkling 2 Small
Inkling 2 Small ser ut som et reelt generasjonshopp, særlig for langvarige agentoppgaver og finjustering. Kombinasjonen av 594 milliarder totalparametere, 17 milliarder aktive og lave Tinker-priser er mer interessant enn selve benchmarkpoenget. Den sier noe konkret om hvordan store MoE-modeller kan gi mye samlet kapasitet uten å beregne alt hver gang.
Samtidig skal «Small» tas med en god klype salt. Dette er en enorm modell, og åpne vekter betyr ikke automatisk enkel lokal kjøring. Først når vektene og distribusjonsoppskriften er ute, blir det mulig å vurdere maskinvarekrav, kvantisering og reell ytelse utenfor Tinker.
For utviklere som allerede bruker Tinker, er modellen klar til å prøves nå. For alle som først og fremst venter på en åpen modell, er det riktige rådet enklere: Vent til filene faktisk er publisert, og vurder lisens, størrelse og støttet programvare da. Løftet er godt. Leveransen er det som teller.
Ofte stilte spørsmål
Kan Inkling 2 Small kjøres lokalt?
Ikke ennå med offisielt publiserte vekter. Thinking Machines Lab varsler Apache 2.0-vekter etter sikkerhetstesting, men har foreløpig ikke publisert en komplett lokal distribusjonsoppskrift. 17B aktive parametere betyr heller ikke at bare 17 milliarder parametere må lagres.
Støtter Inkling 2 Small bilder og lyd?
Modellen støtter tekst og bilder, men ikke lyd. Det skiller den fra første generasjon Inkling og Inkling-Small, som også kunne ta imot lyd. For tale- eller lydarbeid må du derfor velge en annen modell eller koble på egne lydkomponenter.
Hvor mye kontekst har Inkling 2 Small?
Modellkortet oppgir opptil 1 million token. Tinkers prisoppsett har trenings- og samplingsvarianter med 64K og 256K kontekst, mens serverless inferens tilbys med 256K. Den lengre finjusteringsvarianten bruker modell-ID-en thinkingmachines/Inkling-2-Small:peft:262144.
Når kommer de åpne vektene?
Thinking Machines Lab sa 5. november 2026 at de planla å publisere fullstendige vekter under Apache 2.0 uken etter, når ekstern sikkerhetstesting og red teaming var fullført. Dette er en varslet tidsplan, ikke en bekreftet nedlasting på lanseringsdagen.