
Innhold Vis
Jev er en ny AI-modell som ikke skriver tekst, men gir programvare typede beslutninger og sannsynligheter i løpet av 70-500 millisekunder. Den er laget for oppgaver som klassifisering, ruting, poengsetting og kontroll av AI-agenter – steder der et godt formulert avsnitt ofte bare er en dyr omvei.
Det er en retning jeg blir skikkelig nysgjerrig av. Vi har brukt flere år på å presse språkmodeller inn i programvare som om all intelligens må komme ut som tekst først. Deretter ber vi modellen lage JSON, validerer svaret, håndterer feil og prøver å gjette hvor sikker modellen egentlig var. Jev starter i den andre enden: Programmet definerer hvilke svar som er lov, og modellen leverer beslutninger som koden kan bruke direkte.
Det betyr ikke at språkmodellen er ferdig. Jev kan verken skrive kundesvaret, lage kode eller føre en samtale. Men den kan være svært god til å avgjøre hva som bør skje videre. Hvis resultatene holder utenfor TypeSafe AIs egne tester, kan dette bli et viktig byggestykke i billigere og mer pålitelig automatisering.
Hva slags AI-modell er Jev?
Jev er den første offentlige modellen i det TypeSafe AI kaller System One Models. Den tar inn en tilstand og et sett med forhåndsdefinerte spørsmål, og returnerer typede svar, sannsynlighetsfordelinger og confidence score. Modellen ble lansert i tidlig tilgang 15. september 2026. Almeida forlot OpenAI og startet TypeSafe to år tidligere.
Bak selskapet står blant andre Diogo Almeida, en tidligere OpenAI-forsker som var med på å bygge ChatGPT og utvikle RLHF. Han mener språk er feil grensesnitt når svaret først og fremst skal brukes av en datamaskin. Jev er derfor ikke en chatbot i miniatyr – og bør ikke vurderes mot de samme oppgavene som de beste AI-chatbotene. TypeSafe sier modellen bruker en ny arkitektur, parallell sampling og en treningsmetode selskapet kaller Reinforcement Learning for Calibrated Decisions, forkortet RLCD.
Selskapet har foreløpig ikke offentliggjort nok om arkitekturen til at utenforstående kan etterprøve hvor ny den faktisk er. TechCrunch skriver at enkelte observatører mistenker at Jev er bygget oppå en modell med åpne vekter. Det er en viktig reservasjon. Det nye og praktisk interessante er uansett grensesnittet, treningsmålet og måten modellen brukes inne i kode på.
Hvorfor er typede beslutninger så nyttige?
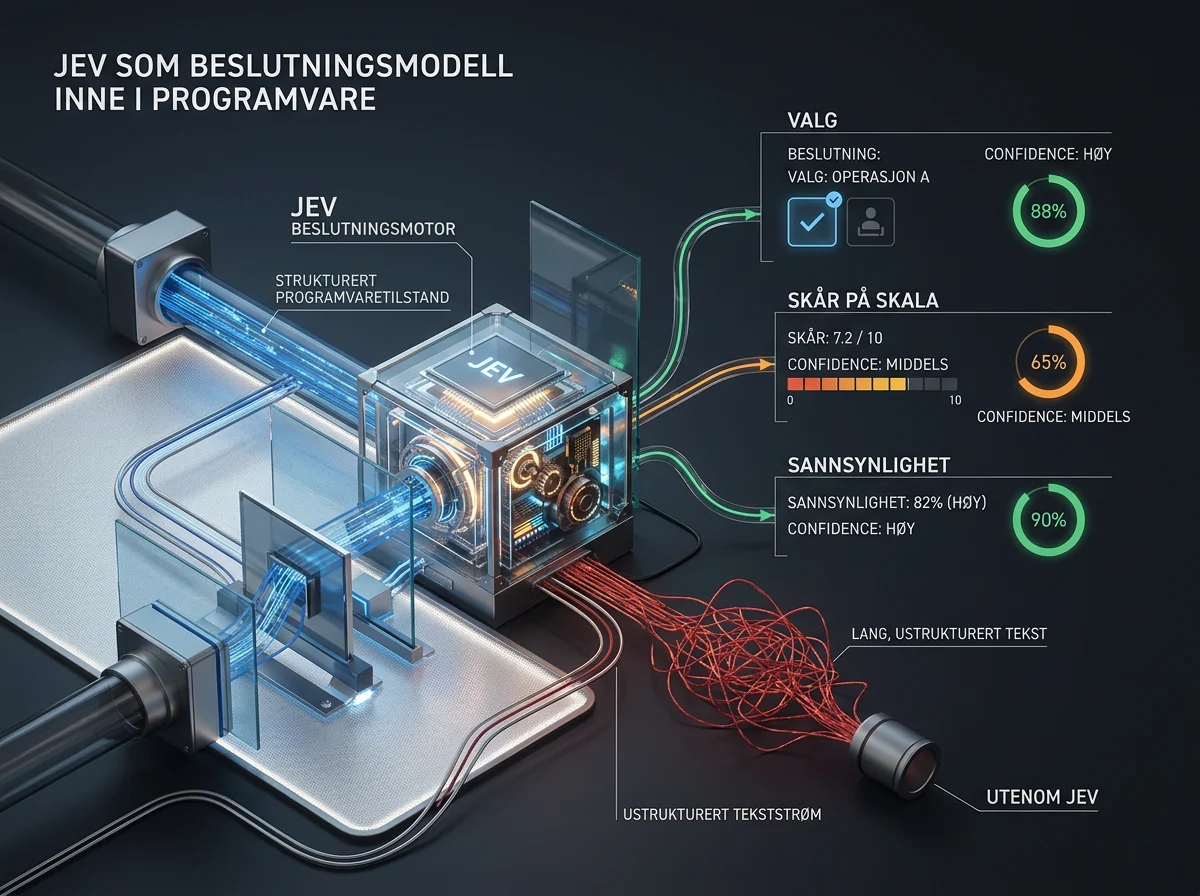
Typede beslutninger begrenser modellen til svar programvaren kjenner på forhånd. I stedet for å skrive et fritt svar om hvorvidt en e-post er svindel, kan Jev velge mellom definerte kategorier og oppgi sannsynligheten for hver av dem. Da slipper utvikleren å tolke prosa eller håpe at en JSON-struktur overlever hver eneste forespørsel.
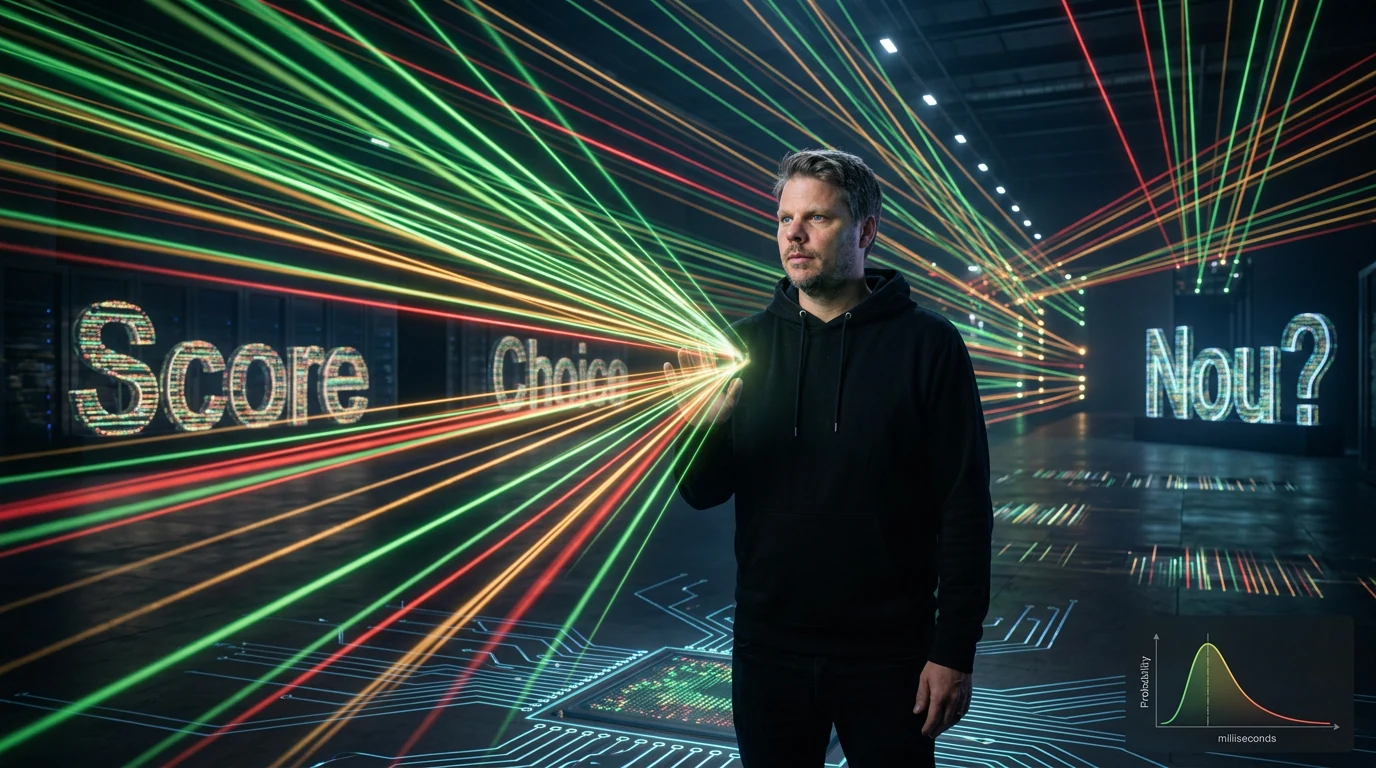
Dokumentasjonen beskriver tre primitive spørsmålstyper. Choice velger ett alternativ fra en liste, Score vurderer noe på en skala, og Noul gir en sannsynlighet mellom 0 og 1 for at en påstand er sann. Flere spørsmål kan sendes i samme API-kall og behandles parallelt mot den samme tilstanden.
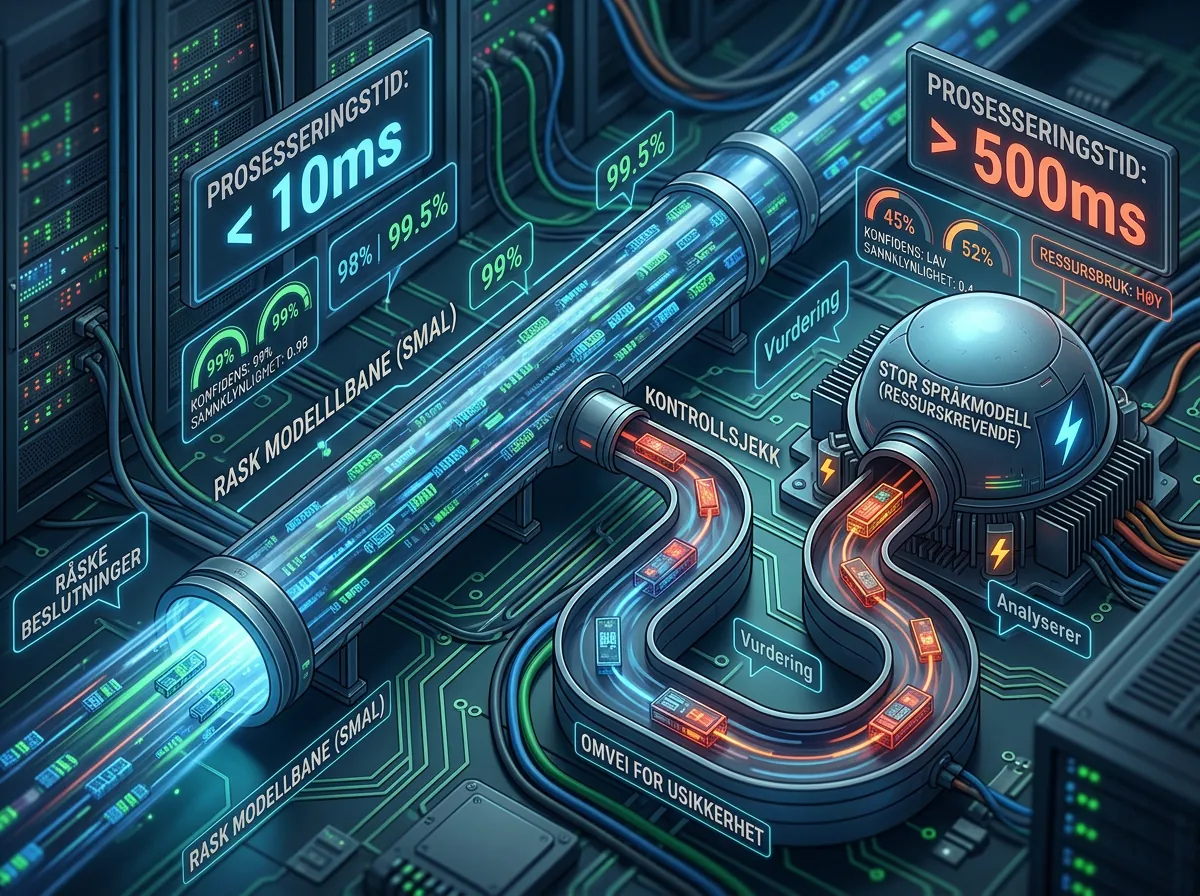
Det siste er viktig. En kundesak kan vurderes for hastegrad, risiko, misnøye og riktig avdeling samtidig. Koden kan så kombinere resultatene med vanlige regler: Send saken til et menneske hvis risikoen er høy, svar automatisk hvis modellen er sikker nok, eller hent inn en dyrere språkmodell bare når oppgaven faktisk krever det.
Jeg liker denne arbeidsdelingen. Modellen får gjøre de uklare vurderingene som er vanskelige å kode med faste regler. Programvaren beholder kontrollen over terskler, rekkefølge og handlinger. Det er mye mer jordnært enn ideen om én enorm modell som skal tenke seg gjennom hele bedriften på egen hånd.
Kan Jev hallusinere?
Jev kan ikke finne på en ugyldig datatype utenfor skjemaet, men den kan fortsatt ta feil. Det skillet er helt avgjørende. Hvis programmet bare tillater svarene «godkjenn», «stopp» og «send til kontroll», kan modellen ikke plutselig returnere et dikt. Den kan likevel velge «godkjenn» når riktig svar var «stopp».
TypeSafe bruker uttrykket «zero hallucinations», men dokumentasjonen er mer presis enn slagordet. Choice og Score returnerer både sannsynligheter og confidence score, mens Noul returnerer en sannsynlighet mellom 0 og 1. Dermed kan utvikleren sette terskler for automatiske handlinger. Et svar på 95 prosent kan behandles annerledes enn et på 51 prosent, og usikre saker kan sendes til menneskelig kontroll eller en annen modell.
Dette flytter en del av ansvaret tilbake til den som bygger systemet. Du må definere gode spørsmål, velge fornuftige terskler og måle om sannsynlighetene faktisk stemmer med virkeligheten. En kalibrert modell er verdifull nettopp fordi «80 prosent sikker» skal bety omtrent det samme over tid. Men ordet kalibrert er ikke en garanti du kan lime på produksjonssystemet uten egne tester.
Hvor rask og billig er modellen?
TypeSafe oppgir en responstid på 70-500 millisekunder for Jev og en pris på 0,042 dollar per million input-tokens. Det tilsvarer 42 dollar, eller omtrent 400 kroner med Norges Banks siste tilgjengelige kurs 22. september 2026, per milliard input-tokens. Output prises ikke separat fordi modellen returnerer små, strukturerte beslutninger i stedet for lange tekstsekvenser.
Selskapets egne workflow-tester viser opptil 193,6 ganger høyere fart og 444,6 ganger lavere kostnad enn sammenlignede språkmodeller. TypeSafe sier selv at disse tallene ligger i den høye enden av hva de forventer i virkelige arbeidsflyter, og at testene er laget av selskapets eget modellteam. Det er bra at de sier det rett ut. Leverandørtall er et utgangspunkt, ikke en fasit.
De første utviklerrapportene er mer beskjedne, men fortsatt lovende. Ifølge TechCrunch byttet Vercel en sikkerhetsklassifisering fra en OpenAI-modell til Jev og fikk svar 5-18 ganger raskere med bedre nøyaktighet i den aktuelle testen. En annen utvikler testet klassifisering av bedrifts-e-post og fant at Gemini var litt mer nøyaktig, mens Jev kostet 10-20 ganger mindre.
Det er akkurat sånn modellen bør vurderes: på din oppgave, med dine data og med kostnaden for hele arbeidsflyten. En modell som er litt svakere på rå nøyaktighet kan være det beste valget hvis gode confidence scores gjør det mulig å sende de usikre sakene videre. Omvendt hjelper lav pris lite dersom feilene havner i den dyreste delen av prosessen.
Hva kan Jev brukes til i praksis?
Jev passer best når programvaren trenger mange raske, avgrensede vurderinger. Det kan være å sortere supporthenvendelser, oppdage mistenkelige kommandoer, prioritere sikkerhetsvarsler, kontrollere fakturaer eller velge hvilken modell som skal løse neste oppgave. TypeSafes offentliggjorte arbeidsflyter dekker blant annet sikkerhetshendelser, agentovervåking, fakturabehandling og kundeservice.
Modellruting er et særlig godt eksempel. En enkel forespørsel kan sendes til en rask og billig modell, mens krevende saker går til en dyrere modell med mer resonnering. Det er lite smart å bruke den dyreste språkmodellen bare for å avgjøre hvilken språkmodell du burde bruke. En liten beslutningsmodell kan ta den jobben i sanntid.
Det samme gjelder AI-agenter. Når en agent utfører mange steg, blir det dyrt å la en ny stor språkmodell kontrollere hvert verktøykall og hver melding. Jev kan vurdere sporene, se etter jailbreak-forsøk eller flagge handlinger som trenger kontroll. Det gjør ikke agenten automatisk trygg, men det kan gi et billig ekstra sikkerhetslag rundt den.
Her treffer Jev også en svakhet ved dagens skybaserte AI-agenter for bedriftsteam: Selvstendige agenter trenger kontrollpunkter som ikke mangedobler regningen og ventetiden. En rask modell for smale avgjørelser kan være langt mer nyttig enn enda en agent som sitter og kommenterer den første.
Hva kan Jev ikke erstatte?
Jev erstatter ikke en generell språkmodell når oppgaven krever språk, kreativitet eller lengre resonnering. Den kan klassifisere en kundemelding, men ikke skrive et godt og nyansert svar. Den kan velge riktig behandlingsløp for en kodefeil, men ikke nødvendigvis finne og implementere løsningen.
Modellen fungerer best med atomiske spørsmål: én konkret vurdering om gangen. TypeSafe anbefaler selv å dele «vurder denne bedriften» opp i markedsstørrelse, teknisk gjennomførbarhet og differensiering, og deretter kombinere svarene i kode. Det krever mer systemarbeid enn å sende ett stort prompt og håpe på det beste. Til gjengjeld blir logikken synlig og lettere å endre.
Jev er dessuten i tidlig tilgang. Etterspørselen var så stor etter lanseringen at TypeSafe en kort stund mistet evnen til å betjene API-brukerne. Arkitekturen er lukket, uavhengige tester er foreløpig få, og selskapets pris må bevise at den er bærekraftig over tid. Dette er ikke et ferdig svar på all programvareintelligens.
Jev peker mot en mer fornuftig AI-stack
Det mest spennende med Jev er ikke at den slår en bestemt chatbot i en bestemt test. Det er tanken om at god AI-programvare bør bruke forskjellige modeller til forskjellige jobber. En språkmodell kan forstå og formulere tekst. En resonneringsmodell kan løse vanskelige problemer. En modell som Jev kan ta tusenvis av små, raske beslutninger mellom dem.
Vi har sett et beslektet brudd med språktvang i modeller som lærer uten å beskrive alt med ord. Jev angriper problemet fra programvaresiden: Hvorfor generere setninger når mottakeren er kode som trenger et valg, et tall og en ærlig vurdering av usikkerheten?
Jeg tror ikke Jev blir slutten på språkmodellen. Jeg håper den blir starten på slutten for språkmodellen som standardsvar på absolutt alt. Utviklere bør prøve Jev på en smal arbeidsflyt med kjent fasit, måle feilrate, responstid og totalkostnad, og bruke confidence thresholds til å sende usikre saker videre. Holder dette i praksis, får vi ikke bare billigere AI. Vi får programvare som vet litt bedre når den ikke vet.
Ofte stilte spørsmål
Er Jev en språkmodell?
Nei. TypeSafe beskriver Jev som en System One Model som returnerer typede beslutninger og sannsynligheter i stedet for generert tekst. Choice og Score returnerer også confidence score. Jev er laget for smale vurderinger inne i programvare, ikke for samtaler, tekstskriving eller generell kodegenerering.
Kan Jev gi feil svar selv om den ikke lager ugyldig output?
Ja. Jev kan holde seg helt innenfor et definert skjema og likevel velge feil alternativ. Forskjellen er at programvaren alltid får en gyldig datatype og en vurdering av usikkerheten, slik at lave confidence scores kan utløse menneskelig kontroll eller en annen modell.
Hva koster Jev?
TypeSafe oppgir 0,042 dollar per million input-tokens, tilsvarende 42 dollar eller omtrent 400 kroner per milliard tokens med Norges Banks siste tilgjengelige kurs 22. september 2026. Output prises ikke separat. Den faktiske kostnaden avhenger av hvor mye tilstand du sender inn og hvor mange kall arbeidsflyten krever.
Hvilke oppgaver bør utviklere teste Jev på først?
Start med en smal oppgave med kjent fasit, for eksempel klassifisering, prioritering, modellruting eller kontroll av agenthandlinger. Mål nøyaktighet, kalibrering, responstid og total kostnad, og bestem på forhånd hvilken confidence threshold som kreves før programvaren får handle automatisk.